Command Palette
Search for a command to run...
SAFETY ALIGNMENT SHOULD BE MADE MORE THAN JUST A FEW TOKENS DEEP
SAFETY ALIGNMENT SHOULD BE MADE MORE THAN JUST A FEW TOKENS DEEP
Xiangyu Qi Ashwinee Panda Kaifeng Lyu Xiao Ma Subhrajit Roy Ahmad Beirami Prateek Mittal Peter Henderson
摘要
The safety alignment of current Large Language Models (LLMs) is vulnerable. Simple attacks, or even benign fine-tuning, can jailbreak aligned models. We note that many of these vulnerabilities are related to a shared underlying issue: safety alignment can take shortcuts, wherein the alignment adapts a model's generative distribution primarily over only its very first few output tokens. We unifiedly refer to this issue as shallow safety alignment. In this paper, we present case studies to explain why shallow safety alignment can exist and show how this issue universally contributes to multiple recently discovered vulnerabilities in LLMs, including the susceptibility to adversarial suffix attacks, prefilling attacks, decoding parameter attacks, and fine-tuning attacks. The key contribution of this work is that we demonstrate how this consolidated notion of shallow safety alignment sheds light on promising research directions for mitigating these vulnerabilities. We show that deepening the safety alignment beyond the first few tokens can meaningfully improve robustness against some common exploits. We also design a regularized fine-tuning objective that makes the safety alignment more persistent against finetuning attacks by constraining updates on initial tokens. Overall, we advocate that future safety alignment should be made more than just a few tokens deep.
一句话总结
普林斯顿大学和 Google DeepMind 将“浅层安全对齐”确定为多种 LLM 漏洞的统一根因,并表明,将安全对齐深入到前几个 output tokens 之外,并设计约束 early-token updates 的正则化微调目标,可以显著提升针对对抗性后缀、prefilling、解码和微调攻击的鲁棒性。
核心贡献
-
论文提出了“浅层安全对齐”这一概念,用于统一解释一类 LLM 安全漏洞:当对齐主要在前几个 output tokens 上改变生成分布时,便会产生这类漏洞。案例研究将这种捷径与对抗性后缀、prefilling、解码参数和微调攻击联系起来。
-
论文提出了深度安全对齐防御方法,利用简单的数据增强,将对齐延伸到 initial refusal tokens 之外;结果表明,更深的对齐可提升针对常见推理阶段越狱攻击的鲁棒性。
-
论文开发了一种正则化微调目标,对 initial tokens 的更新施加约束,从而使安全对齐在微调攻击下更具持久性。
引言
大语言模型依赖监督微调、RLHF 和 DPO 等安全对齐技术,以避免生成有害内容,因此这些方法是安全部署 LLM 的核心。
已有研究表明,常见的对齐方法仍可通过对抗性输入、解码技巧、预填充的不安全提示或短暂微调而被绕过。作者认为,这种脆弱性源于浅层安全对齐:对齐主要将前几个输出 tokens 转换为类似拒绝的前缀,但并未明显改变后续 harmful token 的概率。
作者的主要贡献是对这种浅层对齐效应进行形式化表述和实证刻画,并展示通向更深对齐的路径。作者引入了数据增强,使模型能够从 unsafe beginnings 中恢复,并引入约束优化目标,限制 early token probabilities 的有害变化,旨在使模型在完整生成响应中的安全行为更加稳健。
数据集
-
作者构建了一个名为
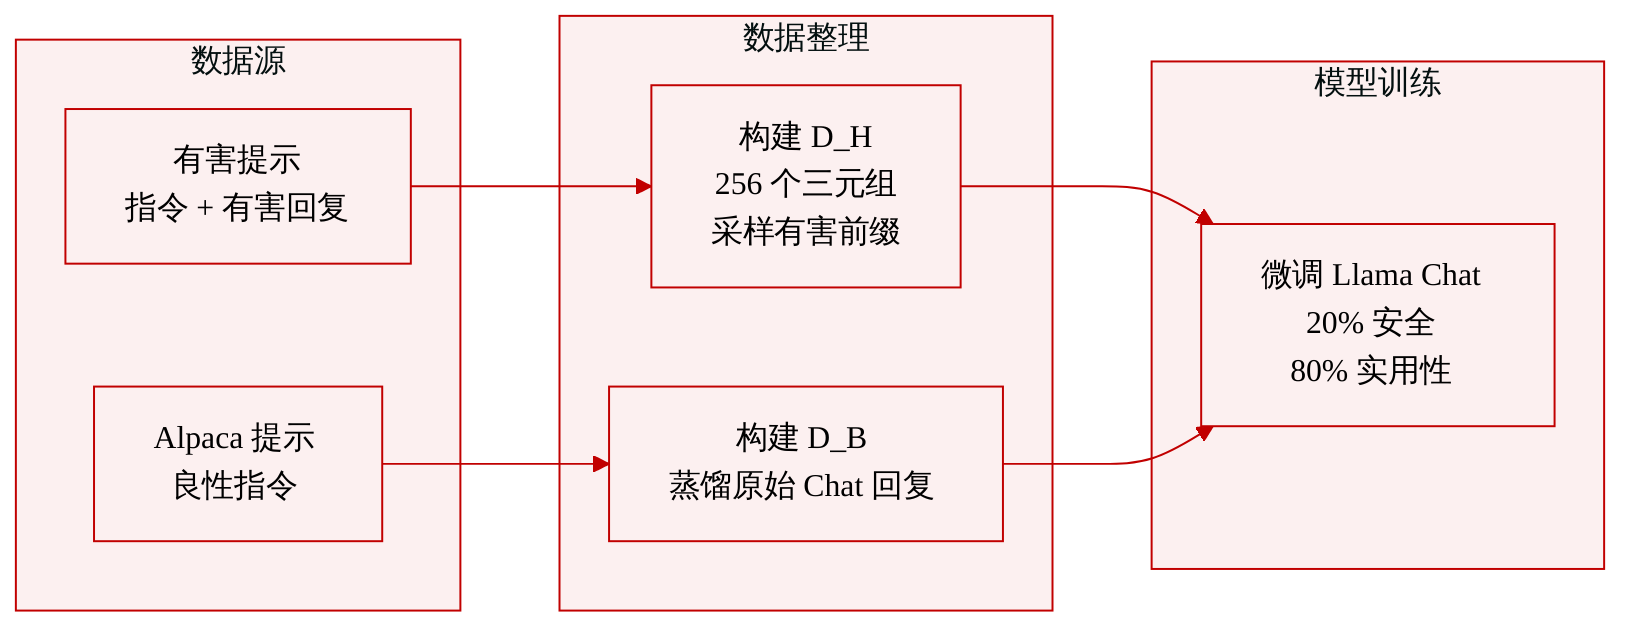
D_H的小型合成安全数据集,用于测试更深入的安全对齐思路。- 规模:256 个样本。
- 格式:每个样本是一个三元组,包含有害指令
x、有害响应h和拒绝响应r。 - 组成:这些数据并非来自摘录中描述的公开有害响应基准。相反,作者通过将有害指令与有害输出和拒绝响应配对来构造这些三元组。
- 特殊格式:每个样本将有害指令放入上下文,然后仅包含有害响应的很短前缀
h_{<=k},并紧接着给出拒绝响应。这创建了训练案例,使模型开始偏向有害续写后,必须通过拒绝来恢复。 - 处理细节:前缀长度
k在训练期间采样。有 50% 的概率不添加任何有害前缀,即k = 0。有 50% 的概率均匀采样一个有害前缀。目标仍是拒绝响应。 - 数据性质:作者指出,这些样本是合成的,而且通常看起来并不自然,因为它们故意创建了异常前缀,这些前缀在正常人工标注 SFT 数据或模型采样偏好数据中不太可能出现。
-
作者添加了名为
D_B的效用保持数据集,以避免损害模型实用性。- 来源:良性指令取自 Alpaca 数据集。
- 响应构造:对于每条 Alpaca 指令,响应由原始已完成对齐的 Llama-2-7B-Chat 模型蒸馏得到。
- 规模:摘录中没有给出确切规模。
- 作用:它作为效用锚点,教会模型在以安全为重点的微调后继续产生其原本的良性响应。
-
数据集使用方式:
- 作者并未从头对齐模型。作者从已完成对齐的 Llama-2-7B-Chat 模型出发,并在安全恢复数据和效用数据上进行进一步微调。
D_H样本用于训练模型:即使有害响应的一部分已被 prefill,模型也要拒绝有害续写。D_B样本用于保持良性指令跟随能力。- 在训练目标中,安全样本的权重为
alpha = 0.2,效用样本的权重为0.8。这使得数据混合包含 20% 的安全恢复信号和 80% 的良性效用信号,尽管论文描述的是这种权重,而非字面上的采样数据比例。 - 摘录中没有描述明确的过滤规则。
方法
作者采用一个诊断与纠正框架,该框架基于如下观察:当前经过安全对齐的模型常常通过较短的拒绝前缀来编码安全性,而不是通过在整个完整响应中深度抑制有害内容。该框架的核心是生成的 token 级视角:对于有害指令 x 和有害响应 h=(h1,h2,…,h∣h∣),有害输出的概率可以分解为 token 级条件概率。浅层对齐可能主要通过抑制 h1 来降低整体有害概率,而相对于未对齐基座模型,后续有害续写基本保持不变。这促使作者测量模型在每个生成 token position 上相对于基座模型的 divergence,而不是仅在序列层面进行测量。
作者构造有害指令-响应对,并计算已对齐模型 πaligned 与未对齐预训练模型 πbase 之间的 token 级 divergence。所使用的是
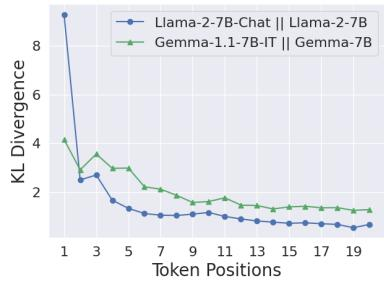
DKL(πaligned(⋅∣x,y<k)∥πbase(⋅∣x,y<k)),并在有害响应续写序列上评估。观察到的模式是,这种 divergence 在前几个 token 处最大,并在后续 token 处迅速下降。见下图。
这种 divergence 剖面支持如下假设:安全对齐往往集中在回答的开头附近。如果模型无法产生 initial refusal tokens,响应的后半部分可能仍接近基座模型的有害续写分布。因此,作者将其视为浅层对齐捷径:仅更新 early-token distribution 就能让模型看起来安全,却在序列更深处保留有害行为。
为了深化安全效应,作者引入安全恢复样本。他们考虑如下形式的三元组
(x,h,r),其中 x 是有害指令,h 是对该指令的有害响应,r 是安全拒绝响应。他们不仅训练标准的 prompt-to-refusal 对 (x,r),还训练在任意有害响应前缀之后的条件拒绝。具体而言,他们优化目标 toward
πθ(r∣x,h≤k),k∼Pk,其中 h≤k 表示前 k 个 harmful tokens。这迫使模型在生成最初已经沿有害轨迹开始时,仍能恢复到拒绝。相应的数据增强针对后续的 token 概率,例如
πθ(h>k∣x,h≤k),而不仅仅是 πθ(h1∣x)。换言之,训练样本显式覆盖了前几个 token 已经偏向有害内容的状态,而这些状态下的期望行为是停止并拒绝。
在实验性的对齐实例中,作者从一个已经对齐的指令微调模型出发,并在两类数据源上进一步微调。第一类是包含有害指令、有害响应和拒绝三元组的安全恢复数据集 DH。第二类是良性效用锚定数据集 DB,其构造方式是取良性指令,并从原始已对齐模型蒸馏响应。该效用分量在安全恢复分量重塑有害前缀之后的条件拒绝行为的同时,保持模型的正常有帮助行为。
整体微调目标为
θminαE(x,h,r)∼DH,k∼Pk[−logπθ(r∣x,h≤k)]+(1−α)E(x′,y′)∼DB[−logπθ(y′∣x′)].这里,α 在安全恢复训练和效用保持之间进行平衡。作者设置前缀分布 Pk,使一半安全样本从原始有害指令开始,而另一半从有害响应的某个前缀之后开始。这种混合训练既覆盖直接拒绝,也覆盖从部分有害生成中恢复拒绝。
这种增强的效果可见于增强模型与基座模型之间的 token 级 divergence。与原始已对齐模型相比,增强模型在更靠后的 harmful-token positions 上更强烈地偏离基座模型。所得到的模式如下。
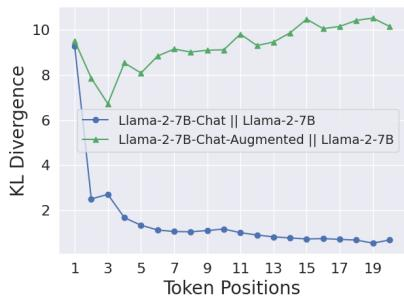
后续 token 上更高的 divergence 表明,该增强将对齐信号扩展到 initial refusal prefix 之外。作者指出,divergence 本身是方向中性的,因此后续 token 上的变化仍需要行为验证。然而,分布偏移证实,训练目标已成功将约束注入有害生成过程中更深的位置。
随后,作者设计第二种互补机制,用于在自定义微调期间保护已经对齐的模型。其前提是:如果 early tokens 主导安全行为,那么微调应当限制模型在这些 early positions 上的移动幅度,同时仍允许模型从下游效用数据中学习。他们受到偏好式 sigmoid 损失启发,提出 token 位置级约束目标。对于微调数据集 D,目标为
θminE(x,y)∼D−t=1∑∣y∣βt2log[σ(βtlogπaligned(yt∣x,y<t)πθ(yt∣x,y<t))],其中 σ(z)=1/(1+e−z),βt 是与 token 位置相关的常数。更大的 βt 表示在 token position t 上向原始已对齐模型施加更强的正则化。
为了理解该损失,定义
Δt(x,y<t,yt)=logπaligned(yt∣x,y<t)−logπθ(yt∣x,y<t).那么 token 损失可以借助 softplus 函数 S(z)=log(1+ez) 写成
βt2S(βtΔt).当 βt 很小时,该损失近似标准交叉熵,因此模型可以从微调数据中自由学习。当 βt 很大时,该损失接近如下 hinge-like 形式
max{Δt,0},该形式仅在新模型为目标 token 分配的概率低于初始已对齐模型时施加惩罚。因此,较大的 βt 能阻止微调后的模型偏离安全模型的 early-token distribution,同时仍允许模型在其预测弱于对齐基线的地方改进。
梯度视角使这种自适应控制更加明确。token-wise 梯度项可写成
−2σ(βtΔt)∇logπθ(yt∣x,y<t).这表明,常规交叉熵梯度乘上了一个自适应权重
wt=2σ(βtΔt).如果新模型在位置 t 已经显著偏离已对齐模型,权重 wt 会下降,从而限制进一步移动。如果新模型仍然接近已对齐模型,或落后于已对齐模型,该权重仍会保持活跃。这样,作者使用了与 token 位置相关的受约束微调模块,在保护决定性 initial refusal tokens 的同时,不冻结整个模型。
实验
实验考察浅层安全对齐如何使已对齐语言模型产生漏洞:首先通过推理阶段攻击,例如 prefilled non-refusal prefixes、基于优化的越狱攻击和随机采样;随后考察微调动态,其中 early-token distributions 最易受到扰动。这些分析表明,当 initial refusal tokens 被绕过,或在微调期间被快速遗忘时,有害输出的易感性会上升。通过比较经过增强、具有更深对齐的模型,并应用保护前几个 token 的受约束微调,实验进一步验证:更深的对齐和 initial-token constraints 能显著提升鲁棒性,同时保持良性任务性能。
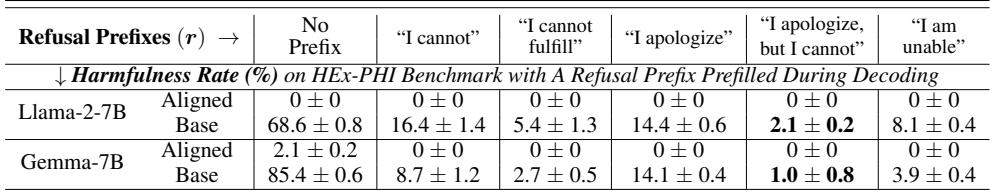
在解码期间预填充短拒绝前缀,会显著降低未对齐 Llama-2 和 Gemma 基座模型在有害指令上的有害率。已对齐版本已大多产生安全输出,因此这些前缀主要影响基座模型。这表明 initial refusal tokens 可以形成浅层安全捷径,强烈影响后续响应行为。仅靠一个拒绝前缀,就能让许多原本有害的基座模型输出变为安全。更完整的拒绝前缀尤其能有效降低有害性。由于已对齐模型的基线有害率已经很低,额外收益很小。
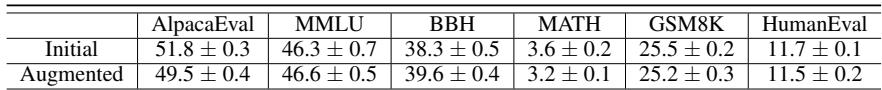
具有安全恢复样本的增强模型,在多项能力评估中仍接近初始 Llama-2-7B-Chat 的效用。它在开放式生成、math、GSM8K 和 code 上出现小幅下降,同时在 MMLU 和 BBH 上略有提升。这表明,更深层次的安全导向数据增强只会带来很小的效用权衡。安全恢复增强保留整体效用,仅引起较小的 benchmark 波动。MMLU 和 BBH 上的推理导向分数略有提升,而 math 和 code 导向分数略有下降。
增强后的 Llama-2-7B-Chat 模型在所有评估的推理阶段攻击中均展现出比初始模型更低的攻击成功率。提升在 prefilling 攻击和 decoding parameters 攻击中尤为明显,同时在 HEx-PHI 和 AdvBench 上的 GCG 攻击率也下降。这些结果支持了这样的观点:深化安全对齐可以提升针对多种攻击类型的鲁棒性。增强后,在测试的 token budgets 范围内,prefilling 攻击成功率变得非常低。增强模型上的 decoding parameters 攻击也被强烈降低。

对 initial tokens 施加更强惩罚的受约束微调,可显著抑制 Llama-2-7B-Chat 和 Gemma-1.1-7B-IT 在 harmful example、identity shifting 和 backdoor poisoning 设置中的攻击成功率。标准微调会导致高得多的攻击成功率,尤其是在存在 backdoor trigger 时;而受约束微调更接近初始安全模型。受约束目标仍然将良性任务效用提升到与标准微调相当的水平。对 early tokens 的强约束使对抗性微调后的攻击成功率保持低位。受约束微调限制 trigger 激活的有害行为,同时在无 trigger 时保持低 unsafe rates。在受约束训练下,良性微调效用得到提升,并保持接近标准微调性能。
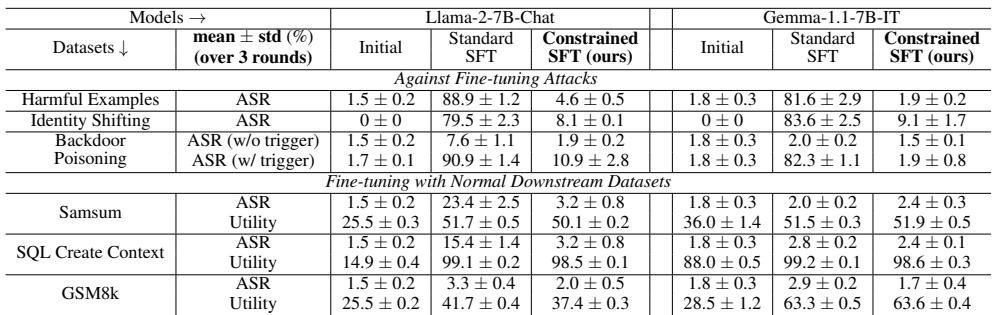
在 Llama 和 Gemma 模型上的实验表明,预先添加短拒绝前缀可以强有力地引导基座模型远离有害输出;更完整的前缀能产生更安全的响应,而已对齐模型的额外收益有限。通过安全恢复数据增强的模型在保留广泛能力的同时,仅带来较小的效用权衡,并降低在推理阶段攻击中的成功率,例如 prefilling、decoding-parameter manipulation 和基于优化的攻击。最后,惩罚 early-token deviations 的受约束微调能够在 harmful-example、identity-shifting 和 backdoor-poisoning 设置中抑制攻击成功率,同时保持良性任务性能,这表明 early-token safety constraints 可以在不造成主要能力损失的情况下增强鲁棒性。