Command Palette
Search for a command to run...
基于离散 Walk-Jump 采样的蛋白质发现
基于离散 Walk-Jump 采样的蛋白质发现
摘要
我们通过学习一个平滑化的能量函数,使用朗之万马尔可夫链蒙特卡洛(MCMC)从平滑后的数据流形中采样,并以一步去噪将样本投影回真实数据流形,从而解决了离散生成模型在训练与采样方面的困难。离散 Walk-Jump 采样框架结合了基于能量的模型的对比散度训练与基于分数的模型的更优样本质量,同时仅需单一噪声水平即可简化训练与采样流程。我们在抗体蛋白的生成建模上验证了方法的鲁棒性,并提出分布一致性分数作为蛋白质生成模型的评估基准。针对所提出的分布一致性分数对模型进行优化与采样后,在单轮实验室实验中,97%–100% 的生成样本在首次尝试中即成功表达并纯化,70% 的功能设计在结合亲和力上与已知功能抗体持平或有所提升。我们还首次展示了长时间运行的快速混合 MCMC 链,其中单条 MCMC 链能够遍历多样化的抗体蛋白类别。
一句话总结
Genentech 与纽约大学提出了离散走跳采样(Discrete Walk-Jump Sampling),该方法将能量模型的对比散度训练、平滑流形上的朗之万 MCMC,以及单一噪声水平下的一步去噪统一起来,从而在抗体蛋白生成中取得高质量结果,其中 97% 至 100% 的样本成功表达,并且 70% 的有功能设计在首次实验室尝试中表现出与已知有功能抗体相等或更优的结合亲和力。
核心贡献
-
提出平滑离散采样,用于离散生成建模:该方法学习一个平滑能量函数,使用朗之万马尔可夫链蒙特卡洛从平滑数据流形中采样,并通过一步去噪将样本投影回真实数据流形。该方法将对比散度能量模型训练与基于 score 的采样行为结合起来,同时仅需要单一噪声水平。
-
提出面向抗体蛋白序列的离散走跳采样。该采样方法利用平滑表述,移除常见的能量模型稳定化机制,将工程复杂度降低为单一噪声水平选择,并能够在有限且高熵的生物数据上实现稳健且高效的训练与采样。
-
提出分布一致性分数,用于基准测试蛋白生成模型。抗体设计实验显示,生成样本中 97% 至 100% 可以被表达和纯化,并且 70% 的有功能设计在首次尝试中等于或提升结合亲和力。其中包括首次展示长时间运行且快速混合的马尔可夫链蒙特卡洛链,能够在单条链内访问多样化的抗体蛋白类别。
引言
离散序列生成对基于梯度的模型具有挑战性,因为这些模型必须学习具有表达能力的分布,同时生成服从应用约束的多样且新颖样本。这对蛋白质设计尤其重要,特别是抗体发现,其中序列空间非常庞大,治疗数据集较小,并且序列同时包含保守结构和高度可变区域。现有方法存在不足:自回归蛋白模型受误差积累和高延迟影响,扩散模型或 score 模型使用复杂噪声调度并且可能脆弱或缓慢,能量模型则难以训练和采样。作者利用神经经验贝叶斯框架,引入平滑离散采样和离散走跳采样,使用单一噪声水平将分别训练的能量模型和 score 模型结合起来,实现快速非自回归采样,并在抗体设计中展示出强生物学有效性。
方法
作者利用一个将含噪连续采样与离散解码分离的生成框架。该方法在离散序列的平滑表示上操作,而不是在原始分类 token 上操作。对于抗体数据,重链和轻链通过 gap token 对齐到固定 token 长度,并编码为稀疏 one-hot 张量。这些离散表示 x∈{0,1}d 通过加性各向同性高斯噪声被转换为连续含噪输入,
y=x+ε,ε∼N(0,σ2Id).平滑含噪流形包含接近有效离散编码但本身不是分类形式的序列。因此,该框架在这个连续含噪空间中训练一个密度模型,并训练一个独立去噪器,将含噪状态投影回干净离散序列。参见框架图:
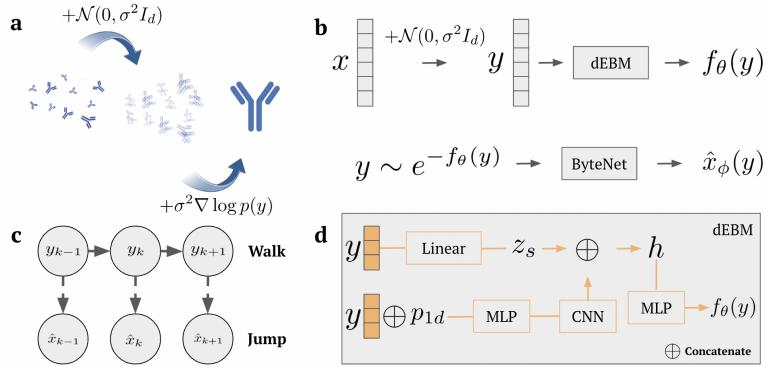
在该流程中,离散能量模型对含噪序列表示参数化一个能量函数 fθ(y)。对应的含噪密度表示为
pθ(y)∝exp(−fθ(y)).该模型通过在平滑数据分布上的最大似然进行训练。目标函数可以写成正负样本形式
argθmaxEy∼pY[logpθ(y)]=argθmax(Ey−∼pθ[fθ(y−)]−Ey+∼pY[fθ(y+)]),其中 y+ 表示含噪训练数据,y− 表示由当前模型生成的含噪样本。该训练目标鼓励模型给真实含噪数据分配更低能量,等价于更高密度,同时给模型生成的含噪样本分配更高能量。该目标的对比散度实现利用了恒等式
∇θlogpθ(y)=−∇θfθ(y)+Ey∼pθ(y)[∇θfθ(y)],该恒等式用模型样本上的期望替代难以处理的配分函数梯度。
通过神经经验贝叶斯训练一个独立神经网络去噪器。含噪样本的平滑边际密度为
p(y)=∫p(y∣x)p(x)dx,给定含噪观测 y,干净信号 x 的最小二乘估计为
x^(y)=y+σ2∇logp(y).score 函数 g(y)=∇logp(y) 由神经网络 gϕ:Rd→Rd 近似。这得到一个参数化去噪映射
x^ϕ(y)=y+σ2gϕ(y).网络 gϕ 通过去噪目标优化
L(ϕ)=Ex∼p(x),y∼p(y∣x)∥x−x^ϕ(y)∥2.该目标是关于加噪和去噪样本对的监督最小二乘回归,并且在去噪器训练期间不需要 MCMC 采样。在实践中,去噪器将平滑含噪输入映射为对干净 one-hot 编码序列的连续估计,并通过 argmax 投影恢复有效离散序列。
流程中使用的密度模型接受含噪张量 y,将其与位置编码 p1d 拼接,将结果通过一个 MLP 和一个卷积特征提取器,将这些特征与输入嵌入结合起来,并输出能量 fθ(y)。该架构旨在捕捉固定对齐序列表示中的依赖关系,同时在含噪连续空间中操作,而不是直接在分类 token 上操作。
在推理时,生成分为两个交错角色。首先,能量模型通过在含噪数据流形上运行朗之万 MCMC 执行一次“走”。如果含噪状态为 yt,则朗之万更新可被视为在 pθ 所建模的密度上进行的梯度引导随机游走。其次,在每个含噪状态 yk 之后,去噪器通过返回结果执行一次“跳”
x^ϕ(yk)=yk+σ2gϕ(yk).对 x^ϕ(yk) 应用 argmax 操作可恢复离散序列。由于游走和跳跃组件解耦,马尔可夫链期间遇到的每个含噪状态都可以解码为候选序列。这与标准扩散式采样不同,在标准扩散式采样中,中间状态通常含噪,并且必须通过固定噪声调度逐渐传输。在走跳表述中,马尔可夫链采样平滑密度,而去噪器将任何此类样本映射回离散数据流形。
下图展示了单条马尔可夫链的典型采样轨迹:
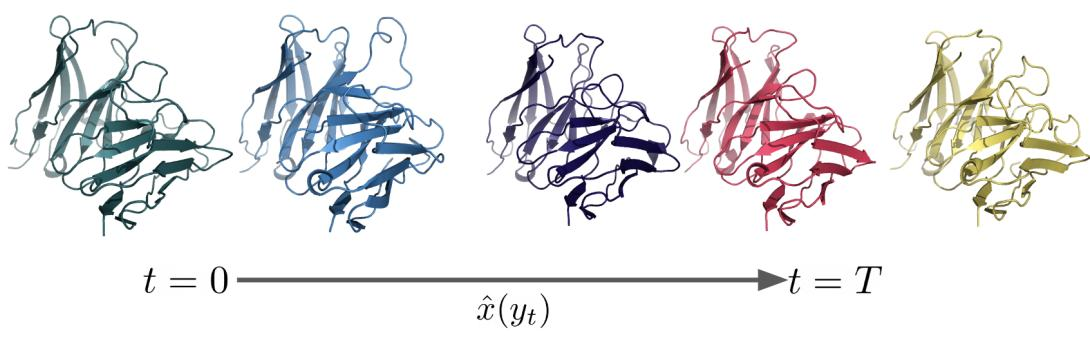
该轨迹说明,一条链可以跨越抗体分布中的多样区域,包括不同胚系类别,而无需多次独立生成运行。采样与去噪的分离也允许受约束的序列编辑。在蛋白质发现中,模型可以无条件采样。在蛋白质设计中,可以在每个去噪步骤之后应用二值投影矩阵 P,以部分保留起始序列 s,强制满足
P⊤argmaxx^(y,t)=P⊤s.这里 P 选择应当保持保守的位置。未约束位置保持自由变化,随着链在含噪流形上演化。
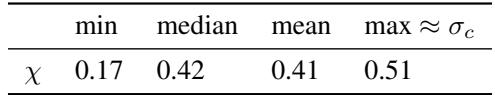
噪声水平 σ 的选择要使含噪表示在学习和采样中足够重叠。作者通过数据样本间的成对距离来说明这一选择。定义
χii′=2d∥Xi−Xi′∥,其中归一化反映了各向同性高斯在高维空间中的集中性质。临界噪声水平为
σc=i,i′maxχii′.当 σ>σc 时,含噪样本在平滑空间中倾向于重叠,这同时支持稳定的密度估计和高效采样。对于对齐后的抗体表示,该临界值约为 0.5,与经验使用的范围一致。
生成的序列通过分布一致性分数进行评估,该分数衡量样本是否在保留新颖性的同时接近参考分布。流程为计算模拟设计和保留参考集计算多个属性。这些属性可包括生物物理属性和统计度量,例如序列自然度、基于比对的相似性、疏水性、电荷相关属性以及语言模型似然。随后使用联合密度估计将设计与参考分布进行比较,并将得到的似然值压缩为一个一致性度量。评估流程如下所示:
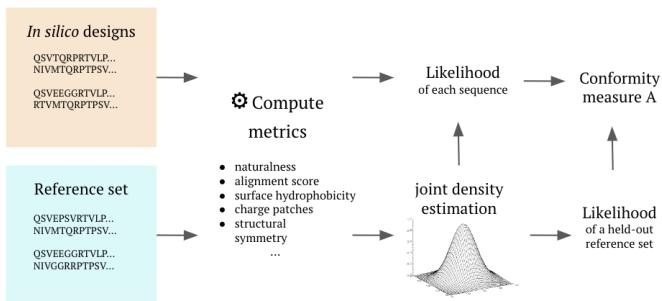
实验
实验评估离散走跳采样在抗体分布学习、体外表达和具有治疗功能的设计中的表现,使用分布一致性、抗体相似性和湿实验验证。计算模拟结果表明,该方法能够生成自然、新颖且多样的抗体,并在样本质量和采样效率方面优于多个基线。湿实验进一步确认,生成序列高度可表达,并可作为靶向结合体发挥作用,支持该方法在设计和开发具有现实性与治疗用途的抗体方面的实用价值。
该表总结了离散抗体序列的归一化成对距离,并为选择训练噪声水平提供几何依据。大多数距离集中在中间范围,最大距离略高于 0.5,并作为临界噪声水平。这支持使用接近 0.5 的噪声水平,也就是抗体生成实验中采用的值。归一化抗体序列距离显示较宽但中等的分布,而不是极端变化。观察到的最大距离与临界噪声水平高度匹配,证明将噪声设为接近 0.5 是合理的。选定的噪声水平被用于训练抗体生成器,生成了高质量的功能性候选结合体。
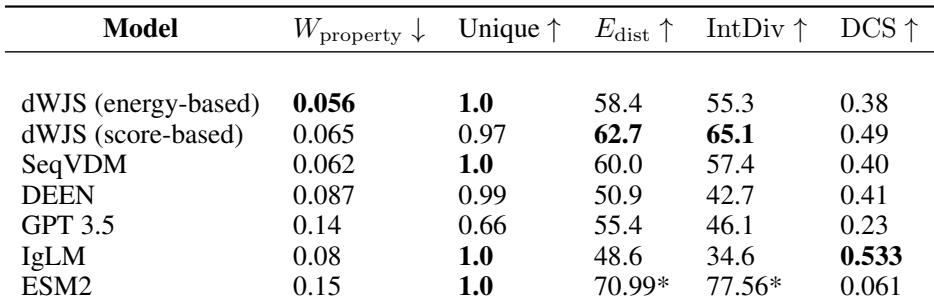
抗体相似性结果显示,dWJS 方法生成的样本与验证序列属性高度一致,同时保持独特性。基于能量的变体最匹配验证属性分布,并具有最高独特性,而基于 score 的变体强调新颖性和内部多样性。基线模型显示权衡:IgLM 具有较强的分布一致性,但多样性较弱;GPT 3.5 的抗体相似性和独特性较弱。dWJS 基于能量的采样在比较模型中提供最佳属性分布一致性和最高独特性。dWJS 基于 score 的采样提供强新颖性和内部多样性,同时保持具有竞争力的分布一致性。IgLM 具有最强分布一致性分数,但内部多样性明显更低,表明样本种类较少。GPT 3.5 的抗体相似性较低,独特性也不如 dWJS 方法。ESM2 显示较高编辑距离和内部多样性,但对抗体序列属性的符合度较差。
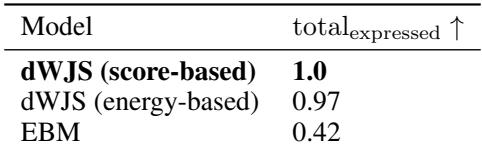
测得的蛋白质合成结果显示,dWJS 生成的抗体序列在表达和纯化中具有非常高的体外成功率。基于 score 的 dWJS 模型在测试设计中实现了全部测得表达,而基于能量的 dWJS 模型也非常高。相比之下,EBM 基线的表达率显著更低,表明 dWJS 在捕捉抗体分布方面具有优势。对 dWJS 生成的抗体序列观察到接近完全的体外表达。基于能量的 dWJS 维持非常高的表达,并显著优于 EBM 基线。当生成分布优化不佳时,少量序列编辑就可能破坏表达。
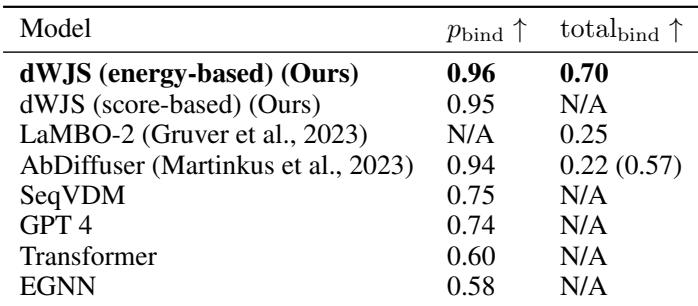
该表比较了 CDR H3 重设计方法中预测抗体结合与实验测得抗体结合。基于能量的 dWJS 模型显示最强的预测结合,并在报告结果中具有最高的实验测得功能性结合体比例。与同期扩散方法相比,dWJS 达到显著更高的湿实验结合率,且不依赖事后筛选。基于能量的 dWJS 设计在具有湿实验验证的方法中取得最高测得功能性结合率。预测结合概率将 dWJS 排在其他序列模型之上,而 AbDiffuser 也获得较高的预测结合体概率。LaMBO-2 和未筛选 AbDiffuser 的测得结合率低于 dWJS 达到的水平。
实验使用序列距离校准、抗体相似性指标、体外表达和功能结合验证来评估抗体生成流程。归一化成对距离显示中等分布,并支持使用接近 0.5 的训练噪声水平。dWJS 采样方法生成真实、独特且多样的类抗体序列,其中基于能量的采样提供最佳属性一致性,基于 score 的采样强调新颖性。实验结果进一步表明,dWJS 设计,尤其是基于能量的模型,在体外高度表达,并在比较方法中取得最强测得功能性结合。