Command Palette
Search for a command to run...
模型告诉你该丢弃什么:面向 LLMs 的自适应 KV 缓存压缩
模型告诉你该丢弃什么:面向 LLMs 的自适应 KV 缓存压缩
Suyu Ge Yunan Zhang Liyuan Liu Minjia Zhang Jiawei Han Jianfeng Gao
摘要
本研究提出了一种即插即用的自适应 KV 缓存压缩方法,用于降低大语言模型(LLMs)生成推理的内存占用。与传统 KV 缓存保留所有上下文 token 的键向量和值向量不同,我们通过定向剖析来识别注意力模块的内在结构。基于所识别的结构,我们提出了 FastGen,以自适应方式构建 KV 缓存:在强调局部上下文的注意力头上驱逐长程上下文,在以特殊 token 为中心的注意力头上丢弃非特殊 token,仅在广泛关注所有 token 的注意力头上使用标准 KV 缓存。此外,由于使用轻量级注意力剖析来指导自适应 KV 缓存的构建,FastGen 无需资源密集的微调或重训练即可部署。在多种任务上的实验表明,FastGen 在生成质量几乎无损的情况下显著降低了 GPU 内存消耗。
一句话总结
伊利诺伊大学厄巴纳香槟分校和微软提出 FastGen,一种即插即用的自适应 KV cache 压缩方法,通过剖析注意力模块的结构,按注意力头类型自适应淘汰 tokens,在无需微调的 LLM 生成式推理过程中实现大幅 GPU 内存减少,且质量损失可忽略不计。
核心贡献
-
FastGen 被提出为一种即插即用的自适应 KV cache 压缩方法,无需微调或重新训练即可减少大语言模型生成式推理的内存占用。
-
该方法使用轻量级注意力剖析来识别内在的注意力头结构,并应用自适应策略:对局部上下文注意力头淘汰长程上下文,对以 special tokens 为中心的注意力头丢弃非 special tokens,仅对广泛关注所有 tokens 的注意力头保留标准 KV cache。
-
在数学、代码、知识和常识推理基准上的 Llama 1 实验显示,在质量损失可忽略不计的情况下可实现可观的 GPU 内存节省,包括在 35% KV cache 压缩率下恢复超过 95% 的注意力得分;对于 30B 模型,在 50% 压缩率下优于固定 KV 压缩方法在 15% 压缩率下的表现。
引言
基于 Transformer 的大语言模型越来越多地用于文本生成,但其自回归推理严重依赖 KV cache。KV cache 通过复用先前的注意力向量来加速生成,同时也会迅速增加 GPU 内存压力。既有方法往往需要重新训练,只适用于非自回归模型,或者使用固定淘汰规则;将 KV cache 卸载到 CPU 或 NVMe 时,受限的 PCIe 带宽可能损害延迟。作者提出 FastGen,一种无需训练的方法,剖析每个模块中的注意力模式,并自适应地应用不同的 KV cache 压缩策略,例如局部上下文缓存、special token 保留、sparse token 淘汰或全量缓存,从而在生成质量损失很小的情况下减少内存使用。
方法
作者将自适应 KV cache 压缩表述为一种两阶段推理算法。在标准自回归生成中,prompt 编码首先为整个 prompt 计算 key 和 value 向量,并且 token 生成在每一步追加新的 key 和 value 向量。这导致 cache 大小随输出长度线性增长。FastGen 通过 prompt 编码阶段剖析每个注意力头,并在生成阶段维护每个注意力头专属的 KV cache,从而改变这一默认行为。
对于候选压缩策略 C,压缩后的 KV cache 记作 KC,VC=f(K,V,C)。给定注意力映射 A=softmax(QKT),该方法选择那些使 cache 内存开销最小、同时使重建后的注意力映射尽量接近原始映射的策略。这可以写为:
C∗=C∈CargminCacheMemoryCost(C)s.t.∣A−softmax(QKCT)∣≤1−T,其中,C 是可行策略集合,CacheMemoryCost(C) 是策略的内存预算,T 是恢复比率。因此,剖析阶段会搜索能够保留足够注意力结构的最低内存 cache 策略。
核心压缩策略围绕观察到的注意力模式设计。special token 策略 Cspecial 只保留诸如句首标记或指令类 tokens 等 tokens。标点策略 Cpunct 只保留标点类 tokens。局部性策略 Clocal 在由比率 rl 控制的相对距离阈值内保留近期上下文。频率或 heavy-hitter 策略 Cfrequent 保留累计注意力得分最大的 tokens,并由比率 rf 控制。全量缓存策略 Cfull 也用于在目标恢复比率下无法被压缩的注意力头。
在实践中,该方法使用这些基础 cache 通过并集操作构成的混合策略。作者采用一个贪心构建的混合策略短名单:
C={Cspecial,Cspecial+punct,Cspecial+punct+frequent,Cspecial+punct+frequent+local,Cfull}.special tokens 被包含在大多数混合策略中,因为它们通常获得较高注意力得分,且带来的内存开销很小。标点类 tokens 也常被保留,因为它们较为稀有,并且能够以很小的 cache 开销帮助保留注意力质量。
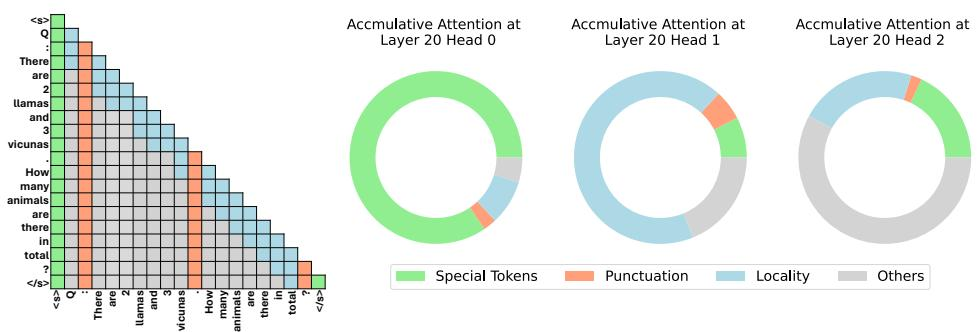
注意力头的行为并不相同,即使在同一层内也是如此。有些注意力头集中在 special tokens 上,有些依赖标点,有些关注局部上下文,还有些需要更广的上下文。下图展示了这一点:
观察到的模式促使采用注意力头级策略选择,而不是单一的全局 cache 配置。跨层剖析结果进一步表明,所需策略随深度变化。初始层和最终层倾向于包含更多需要全量或轻度压缩 cache 的注意力头,而中间层通常由以 special tokens 为中心的注意力头主导。跨层的剖析分布如下:
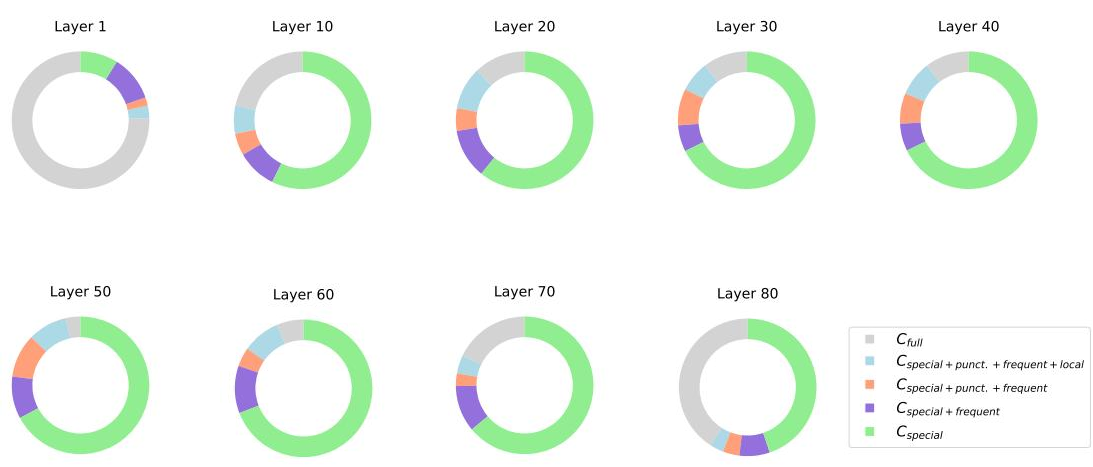
这种依赖层和注意力头的分布支持自适应设计:每个注意力头都获得与其注意力结构匹配的压缩策略。
基于 prompt 的剖析过程还依赖于解码期间注意力结构保持稳定的假设。作者检查选定注意力头在 prompt 编码阶段以及后续解码阶段中的累计注意力得分。由此得到的稳定性分析如下图:
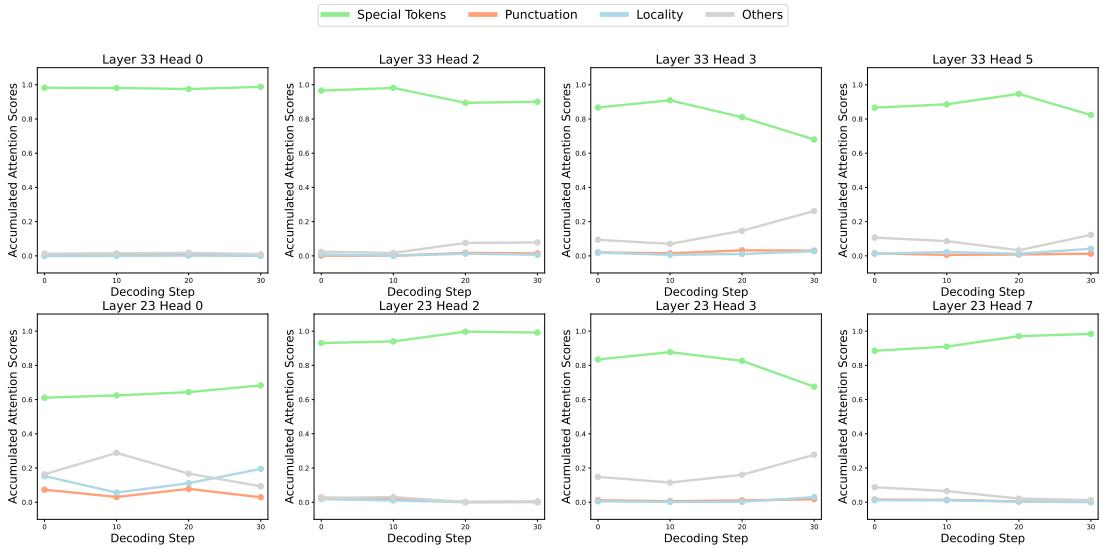
累计注意力模式在解码步骤之间总体保持一致。主要关注 special tokens 的注意力头在生成期间继续如此,而在标点、局部性或其他上下文上具有更大占比的注意力头保持类似行为。这种稳定性使该方法能够从 prompt 编码阶段选择 cache 策略,并在 token 生成过程中复用它们。
实验
实验首先检查 Llama 模型中的注意力行为,以验证自适应 KV cache 压缩的前提,表明注意力头在同一个序列内具有彼此不同但稳定的结构。这支持使用每个注意力头的剖析来选择压缩策略,而不是应用统一的 cache 策略。跨模型规模和任务的综合生成评估表明,自适应压缩在减少 KV cache 内存、改善延迟的同时保留质量,且剖析开销可忽略不计。
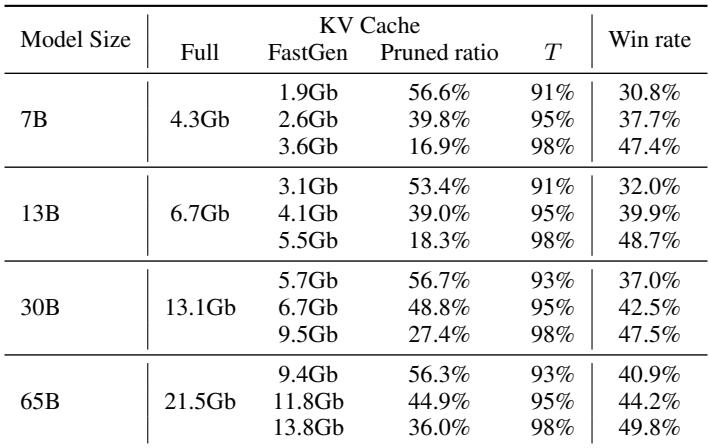
FastGen 对微调后的 Llama 1 模型压缩 KV cache,并在测试的模型规模范围内,相对于全量缓存基线降低内存消耗。更大的模型获得更大的内存节省,而较小的模型在保持几乎没有质量退化的情况下,内存减少更有限。在各种设置中,高剪枝率伴随着不同的胜率,反映压缩强度和模型行为之间的权衡。更大的模型比更小的模型从 FastGen cache 压缩中受益更多。较小的模型实现更温和的低退化内存节省。激进的 KV cache 剪枝可以降低内存使用,但胜率会随压缩级别变化。
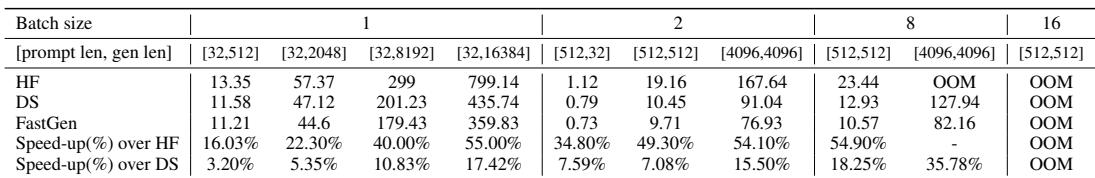
在 Llama 1-7B 上,与全量缓存 Hugging Face 基线和优化后的 DeepSpeed 基线相比,FastGen 持续降低端到端延迟。与 DeepSpeed 相比,在更长的生成设置中测得加速更大,并且随着 batch size 增大而增大。即使在不利的短生成场景中,改进仍然存在。在所有测试的 prompt 和生成配置下,FastGen 相较于全量缓存 Hugging Face 基线都降低延迟。相对加速随生成长度增长而增加。FastGen 也优于 DeepSpeed,在更大 batch size 和更长生成下增益更大。
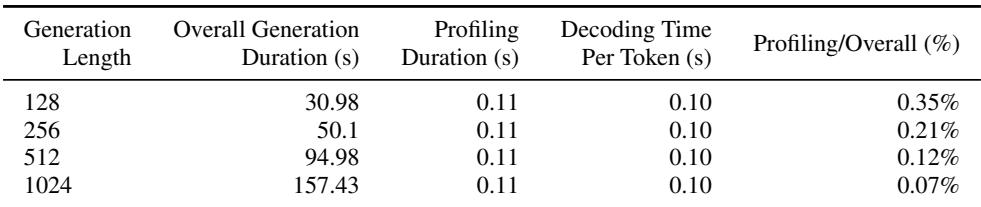
Llama 1-65B 的剖析步骤只占整体生成时间的一小部分。随着生成长度增加,这一占比变小,而测得的剖析时间和每个 token 的解码时间几乎不变。相关内存开销也被描述为可忽略,因为额外的注意力得分存储远小于 KV cache。剖析持续时间在不同生成长度下大致保持恒定。作为总生成时间一部分的剖析开销随输出变长而下降。与 KV cache 存储相比,累计注意力得分所需的额外内存开销很小。
实验在微调后的 Llama 1 模型上评估 FastGen,以验证内存减少、生成延迟和剖析开销。结果显示,cache 压缩会降低内存使用,更大的模型节省更多;而较小的模型在保持质量时获益更少,并且强剪枝以内存换取不稳定的行为。FastGen 相对于全量缓存基线和优化基线也能降低延迟,在更长生成和更大 batch 下收益增大,而剖析增加的时间和内存开销可忽略。