Command Palette
Search for a command to run...
LEARNING INTERACTIVE REAL-WORLD SIMULATORS
LEARNING INTERACTIVE REAL-WORLD SIMULATORS
Sherry Yang Yilun Du Kamyar Ghasemipour Jonathan Tompson Leslie Kaelbling Dale Schuurmans Pieter Abbeel
摘要
Generative models trained on internet data have revolutionized how text, image, and video content can be created. Perhaps the next milestone for generative models is to simulate realistic experience in response to actions taken by humans, robots, and other interactive agents. Applications of a real-world simulator range from controllable content creation in games and movies, to training embodied agents purely in simulation that can be directly deployed in the real world. We explore the possibility of learning a universal simulator (UniSim) of real-world interaction through generative modeling. We first make the important observation that natural datasets available for learning a real-world simulator are often rich along different dimensions (e.g., abundant objects in image data, densely sampled actions in robotics data, and diverse movements in navigation data). With careful orchestration of diverse datasets, each providing a different aspect of the overall experience, we can simulate the visual outcome of both high-level instructions such as "open the drawer" and low-level controls such as "move by ∆x, ∆y" from otherwise static scenes and objects. We use the simulator to train both high-level vision-language policies and low-level reinforcement learning policies, each of which can be deployed in the real world in zero shot after training purely in simulation. We also show that other types of intelligence such as video captioning models can benefit from training with simulated experience, opening up even wider applications. Video demos can be found at https://universal-simulator.github.io.
一句话总结
加州大学伯克利分校、Google DeepMind、MIT 和阿尔伯塔大学的研究者提出 UniSim,这是一种通过学习生成式建模构建的通用真实世界模拟器,它协调具有互补维度的多源数据集,以模拟高层指令以及 Δx,Δy 等底层控制的视觉结果,从而使完全在模拟中训练的策略能够零样本部署到真实世界。
核心贡献
-
UniSim 是一个生成式真实世界交互模拟器,它融合了包含丰富物体、机器人动作和导航移动的数据集,用以合成诸如“打开抽屉”等高层指令以及诸如“移动 ∆x, ∆y”等底层控制的视觉结果。该模型将可控视频生成建模为动力学建模问题。
-
该模拟器可响应从文本指令到机器人控制命令的各种输入,将原本静态的场景和物体转化为视觉上真实的体验。这为训练交互式 agents 提供了真实且近乎无限制的环境访问。
-
仅使用模拟数据训练的高层视觉-语言策略和底层强化学习策略可零样本部署到真实世界;视频描述模型在使用模拟经验训练后也能得到改进。这些发现弥合了策略学习及相关模型的 sim-to-real 差距。
引言
生成式模型现已能够生成高度逼真的文本、图像和视频,这推动了一个更宏大的目标:将其用作真实世界的视觉模拟器。此类模拟器可以让人类与合成场景交互,让机器人在没有物理风险的情况下学习,并为其他智能系统生成大量逼真训练数据。先前工作面临数据与建模挑战:现有数据集捕获现实的不同方面,例如场景、语言、人类活动或机器人运动;而以往的世界模型和视频生成器往往局限于狭窄领域、底层控制或简化环境。作者通过构建 UniSim 解决这一问题,这是一个通用模拟器,它通过“动作输入、视频输出”框架组合多种数据集,并使用视频扩散模型预测未来观测,再自回归展开以实现长时程交互。该研究证明,高层视觉-语言策略和底层控制策略均可完全在模拟中训练,并迁移到真实机器人,从而有助于缩小具身学习中的 sim-to-real 差距。
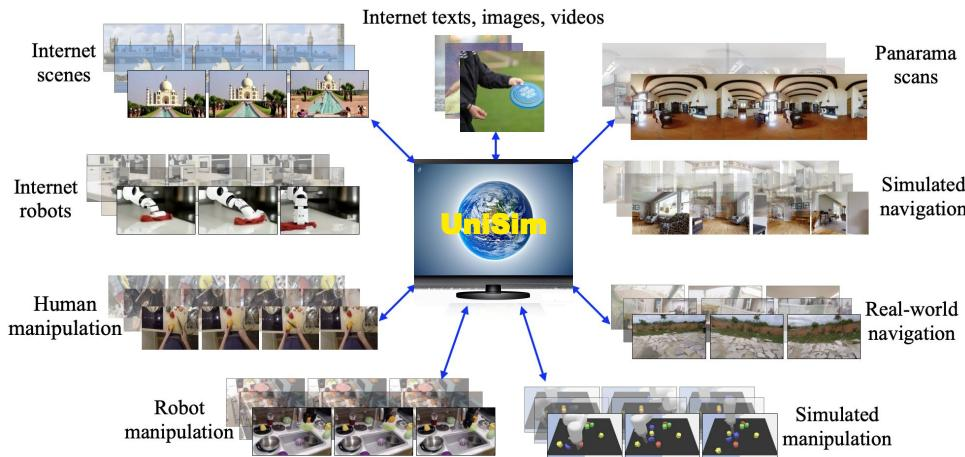
数据集
-
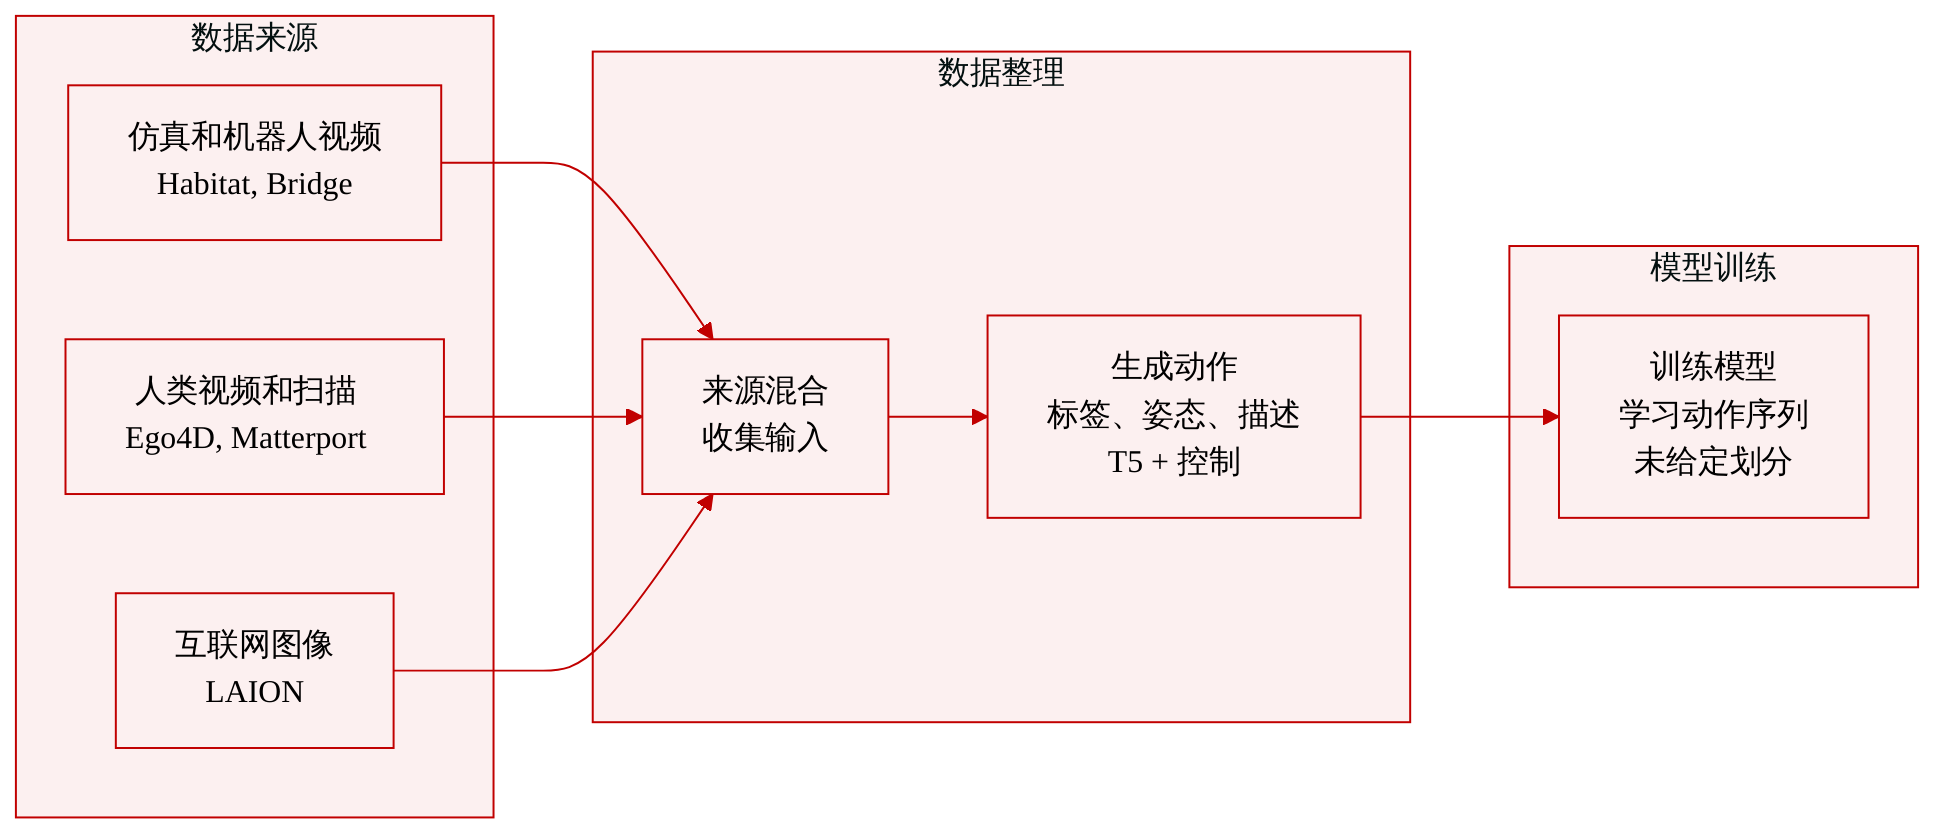
作者将五类视频、扫描和图像数据转换为带有动作的观测序列这一统一格式,从而构建多样化的模拟器训练语料。
-
模拟执行与渲染:使用来自基于 HM3D 的 Habitat 物体导航以及 Language Table Data 的模拟生成数据。若存在文本描述,则将其提取为动作。对于连续控制动作,通过语言嵌入编码控制值,并将其与离散化控制值拼接。
-
真实机器人数据:纳入与任务描述配对的真实机器人执行视频,例如 Bridge Data,以及用于支持 RT-1 和 RT-2 的数据。任务描述被视为高层动作;若存在,则加入离散化后的连续控制动作。
-
人类活动视频:使用大规模人类活动数据集,包括 Ego4D、EPIC-KITCHENS 和 Something-Something V2。视频标签被转换为文本动作;视频按能够捕捉有意义动作的帧率被下采样为观测片段。
-
全景扫描:使用 Matterport3D 等静态 3D 扫描数据,这类数据原本不包含动作。通过截断全景扫描并利用图像之间的相机位姿差异,构造动作,例如转身动作。
-
网络图文数据:使用 LAION 等成对图文数据集。静态图像被视为单帧视频,图像描述被用作动作,尤其是在描述包含运动线索时。
-
统一动作处理:对于每个子集,使用 T5 语言模型嵌入将文本 tokens 转换为连续表示。这些嵌入与底层动作信息(例如机器人控制值)拼接,形成用于训练模拟器的统一动作空间。
-
文中未提供数据集规模、训练/验证/测试划分、混合比例或明确过滤阈值。
方法
作者将交互式真实世界模拟器定义为一个将动作和近期视觉历史映射到未来视觉片段的模型。他们使用观测空间 O 和动作空间 A 对该过程进行形式化。在第 t 个交互步骤,agent 观测一组历史帧 ht−1∈O,选择一个时间扩展动作 at−1∈A,模拟器预测下一组视频帧 ot∈O。因此,核心预测问题是学习一个模型
p(ot∣ht−1,at−1).为支持长时程交互,作者通过从该模型反复采样、并将新预测的帧作为下一轮预测的历史来自回归生成未来观测。该建模通过基于有限数量的近期帧进行条件化得到简化,而不是试图维持覆盖整个历史序列的递归状态。
一个核心设计选择是将异构训练源转换为统一的视频预测问题。模拟环境提供渲染视频及其文本描述或底层控制序列。机器人执行数据集提供与高层任务描述配对的视觉视频,并在可获得时加入离散化控制信号。人类活动数据集通过把活动标签转换为文本动作,并把视频下采样为捕捉有意义运动的片段进行处理。静态 3D 全景扫描通过裁剪视角并从位姿变化推导相机运动动作,转换为视频。成对图文数据被视为单帧视频,图像描述作为动作。文本输入通过语言模型嵌入,并与底层动作表示(例如离散化机器人命令或相机运动 tokens)拼接。这为所有数据集产生统一的连续动作接口。
如框架图所示:
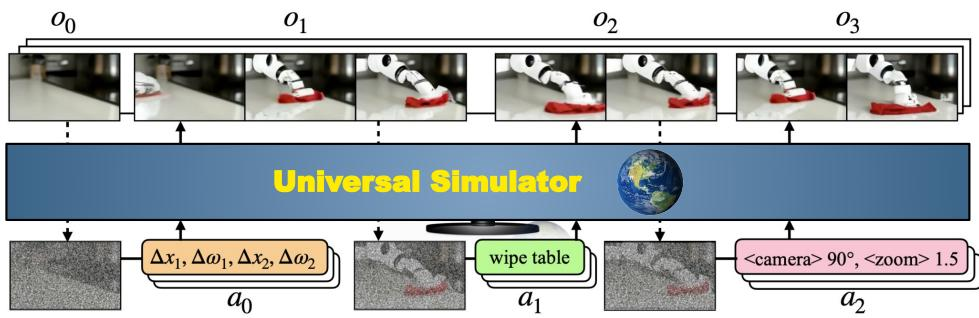
统一模拟器被参数化为视频扩散模型。反向过程学习一个去噪模型 ϵθ(ot(k),k∣ht−1,at−1),在初始噪声 ot(K)∼N(0,I) 上经过 K 个去噪步生成下一段观测。实际中,模型仅以前置视频帧作为条件,而将历史中的先前动作省略。条件帧会在未来帧索引处被复制,并与待去噪的含噪视频帧沿通道拼接。动作条件通过 classifier free guidance 实现。引导去噪方向将条件去噪器和无条件去噪器组合如下
ϵ~θ(ot(k),k∣ht−1,at−1)=(1+η)ϵθ(ot(k),k∣ht−1,at−1)−ηϵθ(ot(k),k∣ht−1),其中 η 控制动作条件的强度。
训练优化标准的去噪回归目标。给定干净目标帧 ot、噪声 ϵ∼N(0,I) 和由 k 索引的噪声等级,损失为
LMSE=ϵ−ϵθ(1−β(k)ot+β(k)ϵ,k∣ht−1,at−1)2.这里 β(k) 是扩散步 k 的噪声调度。在推理时,模型从 ot(K)∼N(0,I) 开始,根据下式从 k=K 迭代去噪到 k=0
ot(k−1)=α(k)(ot(k)−γ(k)ϵθ(ot(k),k∣ht−1,at−1))+ξ,ξ∼N(0,σk2I),其中 γ(k) 是去噪步长,α(k) 是对当前去噪样本的衰减项,σk 是随时间变化的噪声等级。
该架构是一个视频 U-Net,在降采样和上采样路径中都交错使用时空注意力与卷积层。这种设计使模型能够在视频片段内捕捉时间运动,同时保留每帧中的详细空间结构。实现的模型有 5.6B 参数,并在统一的动作条件视频数据上联合训练,使模拟环境、机器人平台、人类活动视频、全景扫描和图像描述数据集的信息共同贡献于同一个模拟器。
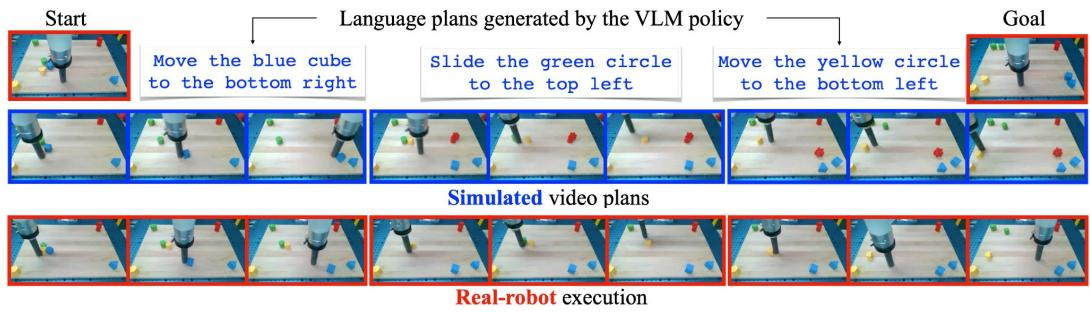
作者不仅将模拟器用作生成模型,还将其用作策略训练环境。对于长时程视觉-语言策略学习,通过在 UniSim 中执行脚本化语言动作来生成模拟轨迹,然后应用回溯重标注。每次生成 rollout 的最后一帧成为目标图像,而用于产生该 rollout 的脚本化语言指令序列作为策略的监督目标动作。这产生原本需要昂贵真实机器人或长视频采集才能得到的长时程训练数据。模拟器用于预测语言动作的视觉后果,所得视觉计划可与真实机器人执行对齐以进行评估。
如下图所示:
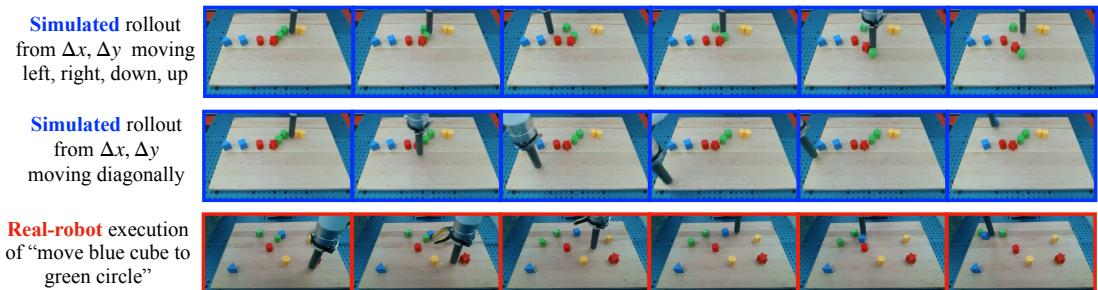
对于强化学习,训练了一个视觉-语言-动作策略,它将图像观测和自然语言任务描述映射到底层控制动作,例如 Δx 和 Δy 方向上的末端位置移动。由于 UniSim 可以接受底层控制动作作为输入,训练好的策略可以在模拟器内执行 model-based rollouts。一个单独学习得到的奖励模型将当前模拟观测映射为标量奖励,其中使用来自训练数据的估计“距完成步数”等代理信号。随后使用 REINFORCE 优化策略,将模拟 rollouts 视作真实环境 rollouts,并用学习到的奖励模型提供反馈。这使得策略改进无需直接在真实机器人上部署探索。
如下图所示:
实验
实验将模拟器评估为面向真实世界操作与导航的通用环境,表明它能够生成动作丰富、由语言驱动的交互,在长序列中保持状态,并捕捉多样化的随机转移;同时,消融实验表明,适度的历史条件化与谨慎的低数据场景处理可提升模拟质量。这些模拟随后用于支持下游学习:由回溯重标注生成的轨迹可训练能够迁移到真实机器人执行的长时程视觉-语言策略,而基于模拟器的 rollouts 可强化视觉控制策略,实现真实世界任务的零样本完成。结果还显示其作为合成数据的更广泛价值:生成的视频显著提升视觉-语言描述性能和跨任务迁移。
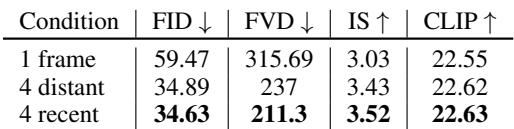
在 Ego4D 上,相较于仅依赖单帧条件化,使用多帧过去条件化可提升视频生成质量。总体而言,使用四帧近期历史表现最佳,其 FVD、FID 和 Inception score 优于单帧或远期历史。在该数据集上,使用超过四帧的条件化不会进一步提升性能。多帧历史条件化相较单帧条件化提升了质量。近期历史比远期历史更有效,尤其体现在视频真实感上。CLIP alignment 受历史条件化选择的影响很小。
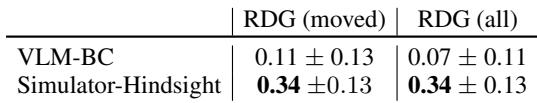
通过回溯重标注在模拟长时程数据上训练 VLM 策略,会使长时程方块重排能力显著强于在原始短时程数据上训练。模拟器训练策略在多次评估运行中,对于移动方块和所有方块,到目标的距离降低更大。基于模拟器的回溯训练相比短时程基线改善了目标推进。移动方块距离目标和所有方块距离目标的降低均可见。
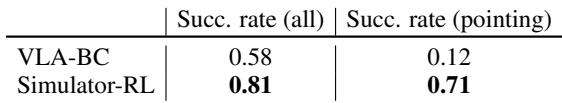
基于模拟器的强化学习相较行为克隆基线,提高了视觉-语言-动作策略在模拟任务中的成功率。在仅有有限专家示范的指向任务上,提升尤其显著。在报告的部署中,模拟器训练策略还可零样本迁移到真实机器人执行。在模拟器中进行 RL 微调,相较基线策略显著提升 rollout 成功率。在专家示范有限的指向任务上,性能提升最明显。模拟器训练策略可泛化到零样本真实机器人执行。
相较于不进行微调,在 UniSim 生成视频上微调预训练视觉-语言模型可显著提升 ActivityNet 上的视频描述性能,并达到在真实 ActivityNet 数据上微调所能获得的大部分性能。与在真实 ActivityNet 描述上微调、更倾向于专门适配 ActivityNet 的模型相比,模拟数据模型对其他描述基准具有更好的泛化能力。模拟训练数据相较未微调带来大幅描述性能提升。在多个描述任务上,模拟数据微调比在真实 ActivityNet 数据上微调具有更好迁移能力。尽管真实数据微调可获得最高的域内描述分数,但可能过拟合到 ActivityNet。
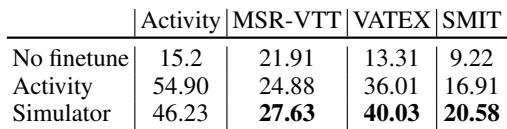
在 Ego4D、模拟操作和视频描述评估中,实验表明,将视频生成条件化在四帧近期历史上可获得最佳真实感;同时,模拟数据和强化学习可提升策略目标推进、任务成功率和真实机器人迁移。多帧历史相较单帧条件化可提升生成质量;基于模拟器的回溯训练和 RL 优于短时程或行为克隆基线;UniSim 生成视频支持强描述微调,且相比仅使用真实数据微调具有更广泛化。