Command Palette
Search for a command to run...
鲁棒智能体学习因果世界模型
鲁棒智能体学习因果世界模型
Jonathan Richens Tom Everitt
摘要
人们长期假设因果推理在鲁棒且通用的智能中发挥着根本性作用。然而,目前尚不清楚智能体是否必须学习因果模型才能泛化到新领域,还是其他归纳偏置就足以实现这一点。我们回答了这一问题,证明任何能够在一组广泛的分布偏移下满足遗憾界的智能体,必然已经学习了数据生成过程的一个近似因果模型,且对于最优智能体而言,该模型会收敛于真实因果模型。我们讨论了这一结果对迁移学习和因果推断等多个研究方向的启示。
一句话总结
Google DeepMind 证明:在大量分布偏移上满足 regret 界的任何 agent,必然已经学到数据生成过程的近似因果模型;对于最优 agents,该模型会收敛到真实因果模型。这为鲁棒泛化与因果推理之间建立了形式化联系,对迁移学习和因果推断具有启示意义。
核心贡献
-
对于无中介决策任务,论文证明:能够在大范围分布偏移集合上满足 regret 界的任何 agents,必然已经学到数据生成过程的近似因果模型。对于最优 agents,该学习到的模型会收敛到真实因果模型。
-
论文通过表明跨领域变化下的鲁棒性能会迫使 agents 的内部世界模型超越表面统计量,解决了因果性与泛化猜想的一个模型无关版本。因此,在所述假设下,因果世界模型对于能够泛化到新领域的 agents 是必要的。
-
论文通过表明在分布偏移下最优策略的集合几乎总是足以识别环境变量之间的因果关系,将决策鲁棒性与因果推断联系起来。这补充了因果层次定理,并澄清了鲁棒学习何时意味着学习数据生成过程。
引言
因果推理对通用智能很重要,因为它帮助系统在环境变化后做出可靠决策,例如数据分布、特征、标签或任务条件发生偏移。这影响领域自适应、迁移学习、鲁棒分类,以及其他要求 agent 在数据生成过程变化时仍保持低 regret 的决策任务。
先前的工作留下一个开放问题:如果现代深度学习 agents 能够在没有显式学习因果模型的情况下适应新环境,那么因果模型是否真的必要?因果可移植性理论为迁移提供了有用条件,但它通常假设所有归纳偏置都可以表示为因果结构。现实中的深度学习系统可以利用许多其他偏置,因此鲁棒适应是否本质上需要因果知识仍不清楚。
论文通过证明一个必要性结果解决了这一问题。它表明:任何能够在足够多的、基于局部干预的分布偏移下,以有界 regret 解决决策任务的 agent,必然已经学到数据生成过程的近似因果模型。其方法利用因果贝叶斯网络、决策理论以及干预下的策略行为,将鲁棒适应与因果世界模型学习联系起来。
方法
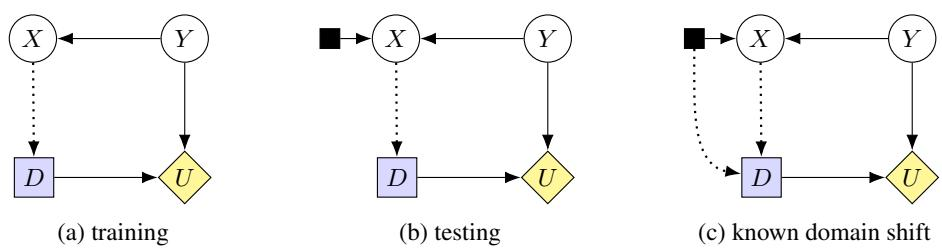
论文通过因果影响图对决策任务进行建模。因果影响图在环境变量的底层因果贝叶斯网络基础上增加一个决策节点和一个效用节点。在单决策情形下,变量集合被划分为
V=({D},{U},C),其中 D 是 agent 选择的决策,U 是实值效用函数,C 表示描述环境的 chance variables。论文假设这些 chance variables 满足因果充分性,即 C 包含与观测行为相关的所有共同原因。论文不假设 agent 知道底层因果图,但它能够观测环境变量的某个子集,
PaD⊆C,并选择一个策略
π(d∣PaD).策略的期望效用通过对决策节点施加干预来定义,
Eπ[U]=E[U∣do(D=π(PaD))].最优策略 π∗ 最大化该量。在实际设置中,agent 可能不会表现最优,其 regret 量化为
δ=Eπ∗[U]−Eπ[U].框架聚焦于无中介决策任务,其中 agent 的决策不会因果地影响进入效用函数的环境变量。形式上,论文施加以下条件
DescD∩AncU=∅,这排除了马尔可夫决策过程等设置,因为在这些设置中,agent 的动作会在效用实现之前改变未来环境状态。该假设涵盖分类与回归等预测任务,其中目标是根据观测信息选择决策,以优化损失函数或奖励函数。
参见框架图。
在示例性的监督学习任务中,标签变量 Y 导致特征变量 X,agent 以 X 为条件来选择预测 D,效用是负损失函数。在分布偏移下,一个领域节点(regime node)会对 X 施加干预。如果领域偏移已知,策略可以以偏移指示变量为条件,
πσ(d∣PaD,σ).关键的方法论主张是:在此类偏移下,最优行为会揭示底层因果结构的信息。具体而言,论文构造了一个过程,在因果充分变量集合 C 上的局部干预混合体中查询最优策略的 oracle。该算法识别最优决策会发生变化的干预混合体。随后,这些临界干预混合体被用于恢复有向无环图,以及效用变量祖先集合上的联合分布,
AncU.对于满足技术假设的几乎全部因果影响图,最优策略族
{πσ∗(d∣PaD)}σ∈Σ足以识别 AncU 上的环境因果模型,其中 Σ 表示局部干预混合体的集合。这表明,在广泛的领域偏移下,精确最优策略编码了相关环境变量的完整因果模型。
论文随后放宽最优行为的理想化假设,研究其策略满足 regret 界的 agents,
Eπσ[U]≥Eπσ∗[U]−δ.在该假设下,它表明可以识别出近似因果模型
M′=(G′,P′)而不是精确的环境模型。学习到的模型参数满足
∣P′(vi∣pai)−P(vi∣pai)∣≤γ(δ),其中 γ(0)=0,并且对于足够小的 regret,γ(δ) 随 δ 线性增长。当 regret 严格为正时,一些弱因果关系可能无法被分辨,因此恢复得到的图 G′ 可能是真实图 G 的稀疏子图。论文在具有二元决策和二元潜变量的模拟环境中评估这一恢复过程。下面的结果总结了模型误差与归一化 regret 之间的关系。
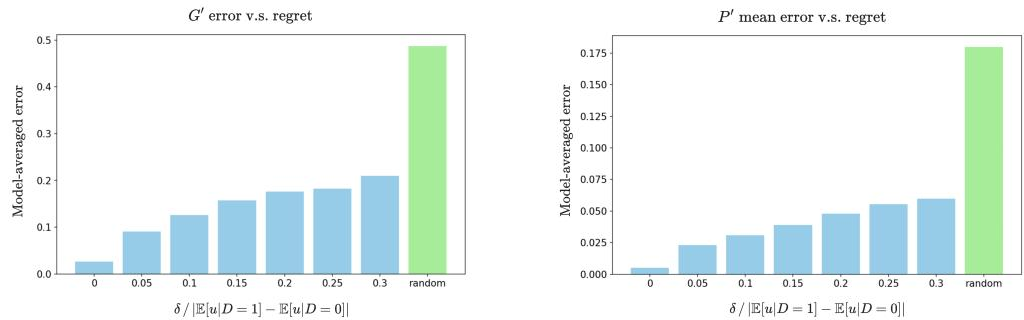
论文还证明反向结果。如果 agent 访问到一个因果充分的环境模型 M=(P,G),那么对于任何父节点位于 C 中的效用函数,它都可以识别软干预下的最优策略。如果 agent 转而拥有一个参数误差以 ϵ 为界的近似因果模型 M′=(P′,G′),那么论文表明它可以识别 regret 随 ϵ 线性增长的策略。因此,该方法识别出一个理论等价关系的两面:在局部领域偏移下的鲁棒策略学习意味着恢复一个近似因果模型;而近似因果模型足以产生低 regret 的策略。