Command Palette
Search for a command to run...
一般几何上的流匹配
一般几何上的流匹配
Ricky T. Q. Chen Yaron Lipman
摘要
我们提出了黎曼流匹配(Riemannian Flow Matching, RFM),这是一个简单而强大的框架,用于在流形上训练连续标准化流。现有的流形上生成建模方法要么需要昂贵的模拟,要么本质上无法扩展到高维,要么使用极限量的近似而导致有偏的训练目标。黎曼流匹配绕过了这些限制,相较于先前的方法具有多项优势:在简单几何上无需模拟,不需要散度计算,且以封闭形式计算目标向量场。RFM 的关键在于构造了一个相对简单的预度量来定义目标向量场,该预度量涵盖了现有的欧几里得情形。为了推广到一般几何,我们借助谱分解来高效地即时计算预度量。我们的方法在许多真实的非欧几里得数据集上达到了最先进的性能,并展示了一般几何上可处理的训练,包括具有高度非平凡曲率和边界的三角网格。
一句话总结
FAIR(Meta)与魏茨曼科学研究所提出黎曼流匹配(Riemannian Flow Matching,RFM),这是一种在流形上构建连续标准化流的免模拟框架,通过构造预度量实现闭式目标向量场,并利用谱分解扩展到一般几何,在包括三角网格在内的非欧几里得数据集上取得了最先进的结果。
核心贡献
- 黎曼流匹配(RFM)通过回归闭式条件向量场而非得分函数来训练流形上的连续标准化流,在简单几何上实现免模拟训练,并避免训练期间的散度计算。
- RFM 引入预度量来定义目标向量场,并使用谱分解在一般几何上高效近似该预度量,从而在有限截断下使用近似谱距离实现可处理训练。
- RFM 在真实世界的非欧几里得数据集上取得最先进性能,并展示了在一般几何上的可处理训练能力,包括具有非平凡曲率和边界的三角网格。
引言
作者聚焦于生活在黎曼流形上的数据生成建模,例如球面、双曲空间、乘积几何和网格。这很重要,因为许多真实世界数据集具有几何约束,而欧几里得生成方法不能自然尊重这些结构。
先前考虑流形的连续标准化流和扩散模型面临重要限制。有些即使在简单几何上也需要训练期间的模拟或迭代采样。其他方法难以扩展到高维,依赖对得分函数或散度的近似,或需要在流形上使用困难的随机微分方程求解器。
作者利用流匹配框架提出黎曼流匹配,这是一种在一般黎曼流形上直接学习连续标准化流的可扩展方法。关键思想是将从流形预度量构造的条件向量场作为回归目标,该预度量自然可取测地距离。这带来简单的训练目标,避免散度估计,并在具有闭式测地线的几何上完全免模拟,同时在更一般流形上仍保持实用性。
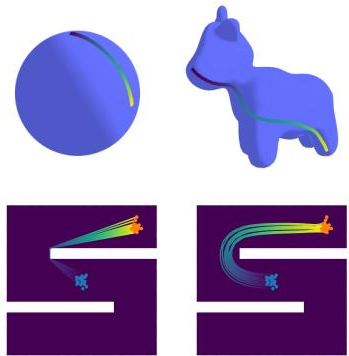
方法
作者使用黎曼流匹配框架在光滑流形上训练生成模型。该流形被假设是完备、连通并配备了度量 g。训练样本从流形上未知的数据分布 q(x1) 中抽取,同时模型旨在将简单的基础分布 p 转换为 q。该方法不直接学习最终传输映射,而是学习时间依赖的切向量场
vt(x)∈TxM,以 θ 参数化。该向量场通过求解常微分方程在流形上定义连续标准化流。学习到的流随时间将点从基础分布传输到数据分布。
核心训练目标是将参数化向量场 vt 拟合到已知目标向量场 ut,该 ut 在流形上生成期望的概率路径 pt。概率路径必须满足边界条件
p0=p,p1=q.在欧几里得域上,这类似于流匹配。在流形上,使用黎曼度量比较切向量,得到目标函数
LRFM(θ)=Et,pt(x)∥vt(x)−ut(x)∥g2.这里 vt(x) 和 ut(x) 都位于 x 处的切空间,范数由流形度量 g 诱导。
直接的目标路径 pt 和速度场 ut 通常不可直接计算。作者因此构造条件概率路径 pt(x∣x1),其中每个条件是训练样本 x1。每条条件路径从基础分布开始,并在最终时间坍缩到数据点 x1:
p0(x∣x1)=p(x),p1(x∣x1)≈δx1(x).随后通过对数据分布取平均得到边缘路径:
pt(x)=∫Mpt(x∣x1)q(x1)dvolx1.相应的边缘向量场也可写成条件平均,但直接评估代价高昂。关键的训练简化是将边缘匹配损失替换为条件匹配损失:
LRCFM(θ)=Et,q(x1),pt(x∣x1)∥vt(x)−ut(x∣x1)∥g2.在条件构造下,该损失与原始流匹配目标等价,但只需要从可计算的条件路径采样。
实际训练流程采样时间 t、数据点 x1 和基点 x0。该方法随后构造条件流
xt=ψt(x0∣x1),并使用时间导数
x˙t=ut(xt∣x1)作为回归目标。由此得到的训练目标为
LRCFM(θ)=Et,q(x1),p(x0)∥vt(xt)−x˙t∥g2.在每次更新时,模型只需要评估 vt(xt;θ) 并与目标切向量比较。如果条件流没有闭式形式,xt 可以通过条件向量场的前向模拟获得。梯度只对模型参数求取,不需要对模拟本身求导。
核心设计模块是条件流的构造。作者引入预度量 d:M×M→R 来衡量一个点距离条件点 x1 有多近。该预度量要求非负、仅在相同点处为正,并且非退化,即在远离条件点时梯度非零。这些性质确保减小预度量会使所有点朝向 x1。
给定满足以下条件的调度器 κ(t)
κ(0)=1,κ(1)=0,所需的条件流按照以下规则减小预度量
d(ψt(x0∣x1),x1)=κ(t)d(x0,x1).实现该收缩的条件向量场为
ut(x∣x1)=dtdlogκ(t)d(x,x1)∥∇d(x,x1)∥g2∇d(x,x1).调度器控制收缩速度。一个特别简单的选择是线性衰减,
κ(t)=1−t,这会得到一个以恒定相对速率减小预度量的条件流。使用该调度器时,训练损失可以写成
LRCFM(θ)=Et,q(x1),p(x0)vt(xt)+d(x0,x1)∥∇d(xt,x1)∥g2∇d(xt,x1)g2.当预度量选择为测地距离 dg 时,所得条件流变得特别自然。此时,该向量场是使到 x1 的距离减小的最小范数解,对应轨迹是连接 x0 和 x1 的恒速测地线。在测地线具有闭式表达的流形上,插值点可以用指数映射和对数映射写出:
xt=expx1(κ(t)logx1(x0)).这使得在欧几里得空间、超球面、双曲空间、环面以及某些矩阵李群等标准几何上,训练目标可以免模拟。在欧几里得空间中,使用标准范数时,该方法还原了常见的直线插值以及对应的欧几里得流匹配目标。
对于一般流形,任意两点之间的测地线可能计算代价较高。作者因此引入谱距离作为高效预度量。这些距离由 Laplace-Beltrami 算子的特征函数和特征值构造而成。如果 φi 是对应特征值 λi 的特征函数,则谱距离具有如下形式
dw(x,y)2=i=1∑∞w(λi)(φi(x)−φi(y))2,其中 w 是递减加权函数。常见选择包括扩散距离加权,
w(λ)=exp(−2τλ),以及双调和距离加权,
w(λ)=λ−2.在实践中,无穷级数被截断到最小的 k 个特征值。所需特征函数在预处理阶段一次性计算,之后即可在训练期间快速评估该距离。作者指出,有限截断足以满足预度量的作用,并且不会在训练过程中引入偏差。对于带边界的流形,在求解特征函数时使用 Neumann 边界条件,有助于确保诱导出的条件向量场始终位于流形内部。与测地距离不同,谱距离通常不会给出闭式的最短路径,因此条件流需要通过模拟获得。
实验
实验在球面气候数据集、蛋白质扭转角环面、高维环面、网格流形以及带边界的迷宫状流形上评估该方法。结果表明,该方法对集中区域和复杂分布的建模有所改进,并在更高维环面上取得特别显著的增益,同时避免了竞争方法中由近似引发的不稳定。在弯曲网格流形上,谱距离使实际的高保真生成成为可能;在带边界迷宫中,学习到的向量场成功将质量跨越非平凡拓扑进行传输,且不越过边界。
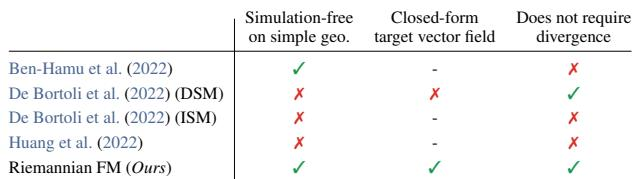
比较表明,黎曼流匹配是所列方法中唯一结合在简单几何上免模拟运行、闭式目标向量场以及无需散度估计的方法。它还独特地扩展到一般流形,而若干相关连续时间或受扩散启发的方法则依赖模拟、得分函数近似或增加方差的散度估计。黎曼流匹配在简单流形上保持免模拟。它不需要散度估计。它是所比较方法中同样能够处理一般几何的方法。
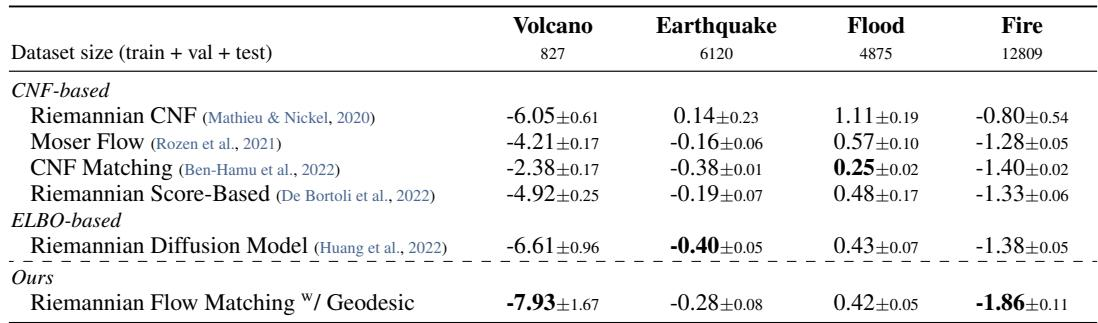
在球面上的地球与气候科学数据集中,更低的测试负对数似然显示,不同数据集的最佳方法各不相同。火山与火灾数据集报告了最强的增益,在这些数据集中,集中区域使高保真密度建模尤为重要。火山和火灾结果因数据集中在需要精确密度建模的区域而成为显著改进之处。在所列方法中,其余球面数据集上的表现各有侧重,基于 ELBO 的黎曼扩散在地震数据集上最强,CNF 匹配在洪水数据集上最强。
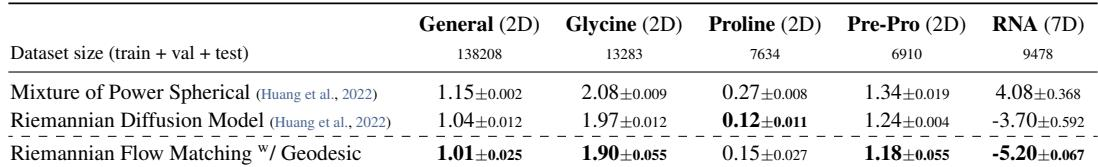
蛋白质数据集结果显示,与先前的 Mixture of Power Spherical 和 Riemannian Diffusion 基线相比,采用测地线构造的黎曼流匹配在大多数 2D 和 7D 环面数据集上改善了测试负对数似然。该优势在更高维的 RNA 数据集上尤为明显,而扩散基线在其中一个 2D 数据集上仍略强。这支持该方法在更复杂扭转角分布上的可扩展性。采用测地线构造的黎曼流匹配在大多数蛋白质环面数据集上取得最佳或接近最佳的表现。该方法在更高维 RNA 数据集上表现出特别强的相对增益。先前的 Riemannian Diffusion 在 Proline 2D 数据集上仍取得最佳结果。
在网格流形上,模型性能随所选谱距离和使用特征函数数量的不同而变化。双调和距离被描述为更平滑、更易使用,并且通常在 Stanford Bunny 网格上带来更低的测试负对数似然,而扩散距离在 Spot the Cow 网格上表现更好。在两种距离选择中,测试误差通常会随着使用更多特征函数而上升。在若干特征函数数量下,双调和距离可以在 Stanford Bunny 网格上优于扩散距离。在报告的设置中,扩散距离在 Spot the Cow 网格上给出比双调和距离更低的测试负对数似然。
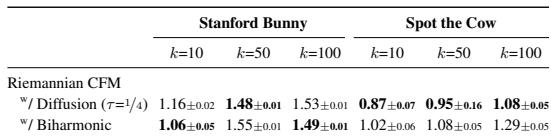
实验在球面、环面和网格流形上,围绕理论性质和实际密度估计任务评估所提出方法。比较突出表明,黎曼流匹配独特地结合了免模拟运行、闭式目标向量场、无需散度估计以及适用于一般几何等特点;地球与气候数据集上的实证结果表现出依赖数据集的优势,尤其对高度集中的火山和火灾数据有特别强的增益。在蛋白质环面流形上的进一步评估展示了强大的密度估计性能和可扩展性,尤其针对更高维结构;网格实验则表明结果依赖于所选谱距离和规模,表明方法在不同流形几何下具有鲁棒性。