Command Palette
Search for a command to run...
基于随机优化的标准式博弈纳什均衡逼近
基于随机优化的标准式博弈纳什均衡逼近
Ian Gemp Luke Marris Georgios Piliouras
摘要
我们提出了首个适用于无偏蒙特卡洛估计的标准式博弈近似纳什均衡损失函数。该构造使得我们可以采用标准的非凸随机优化技术来逼近纳什均衡,从而得到具有可证明保证的新算法。我们通过实验补充了理论分析,结果表明随机梯度下降能够超越此前最先进的方法。
一句话总结
DeepMind 提出了首个允许无偏蒙特卡洛估计的标准式博弈近似纳什均衡损失函数,使随机梯度下降(SGD)等标准非凸随机优化方法能够以可证明保证计算均衡,并优于此前最先进的基线方法。
核心贡献
- 引入首个允许无偏蒙特卡洛估计的标准式博弈近似纳什均衡损失函数,解决采样博弈中可利用性和基于梯度损失存在的偏差问题。
- 通过实现无偏梯度估计,该形式化使标准非凸随机优化方法,包括 bandit 和原始随机梯度下降,可用于具有可证明保证的均衡计算。
- 实验表明,基于该损失函数的随机梯度下降可以优于此前最先进的纳什均衡近似方法。
引言
纳什均衡描述了多智能体系统中的稳定结果,其中任何玩家都不会从单方面偏离中获益,因此它成为经济学、机器学习和行为建模中的核心概念。然而,在一般的 n 玩家、一般和博弈中,计算甚至近似均衡在计算上是困难的,并且当存在多个均衡时,实践者还面临均衡选择问题。现有标准式博弈求解器扩展性较差,因为收益张量呈指数增长,而且常见均衡损失依赖非线性最佳响应或投影运算,从而阻碍无偏采样估计。作者将近似纳什均衡搜索表述为带有 Lipschitz 有界损失且允许无偏蒙特卡洛估计的随机非凸优化问题,使 bandit 和 SGD 方法能够以可扩展方式应用。该方法还支持特定应用目标,例如寻找福利阈值以上的均衡或接近观测行为的均衡,并在大型博弈上将随机梯度下降与最先进基线进行比较。
方法
作者将纳什均衡近似转化为博弈联合混合策略空间上的随机优化问题。每个玩家 k 在单纯形上维护一个策略 xk,联合策略为 x=(x1,…,xn)。对于给定联合策略,玩家 k 具有期望收益 uk(x),对应梯度 ∇xkk 衡量收益如何随玩家 k 的行动概率变化。由于策略受单纯形约束,作者关注单纯形的切空间。对该切空间的投影为
ΠTΔ(v)=v−m11(1⊤v),其中 m 是行动数量。这一几何视角是核心:一个内部策略是最佳响应当且仅当其投影梯度范数为零。这一驻点条件促使作者构造一个直接基于投影梯度范数的损失函数,
L(x)=k∑ηkΠTΔ(∇xkk)2,其中 ηk>0 可解释为玩家 k 的权重或投影梯度上升步长。当每个玩家的投影梯度均为零时,损失恰好消失,这对应于一个内部纳什均衡。等价地,该损失衡量一步投影梯度上升更新将如何改变每个玩家的策略。作者还将该损失与可利用性联系起来,证明对手通过偏离可获得的最大收益被一个缩放后的投影梯度范数上界限制,因而也由损失本身上界。
一个关键设计选择是使损失适合一步无偏蒙特卡洛估计。难点在于损失包含期望梯度的平方范数,而期望的平方不等于平方的期望。为克服这一点,作者使用两个独立的无偏梯度估计量 ∇^xkk(1) 和 ∇^xkk(2),并对其投影版本取点积。概念上,投影估计量为
g^k(p)=∇^xkk(p)−mk1(1⊤∇^xkk(p))1,而乘积 g^k(1)⋅g^k(2) 给出投影期望梯度平方范数的无偏估计。梯度估计量可以在不同的成本与方差权衡下构造。精确估计量针对所有其他玩家的策略对玩家 k 的收益进行边缘化,而更便宜的估计量采样对手的行动或采样所有玩家的行动。采样会增加方差,但会降低查询复杂度,使该方法适用于大型博弈。
基本投影梯度损失对完全混合的内部均衡最为自然。然而,许多博弈在单纯形边界上具有纯策略或部分混合策略均衡,边界约束可能使投影梯度分析的可靠性下降。为处理这些情况,作者引入熵正则化。每个玩家的效用变为
ukτ(x)=uk(x)+τS(xk),其中 S(xk)=−∑lxklln(xkl) 是香农熵,τ>0 是温度参数。熵正则化将最佳响应转化为 softmax 形式,保证所有均衡具有正概率质量,因此位于内部。相应损失为
Lτ(x)=k∑ηkΠTΔ(∇xkkτ)2.熵梯度仅依赖玩家 k 的已知策略,因此可以确定性地添加到采样梯度估计量中,同时保持无偏性。熵正则化损失还在原始无正则化博弈中保持可利用性界,
ϵ≤τlog(k∏mk)+minkηk2nLτ(x).因此,通过选择较小温度 τ,该方法可以近似内部和边界纳什均衡,同时保持可利用性可解释的上界。如下图所示:
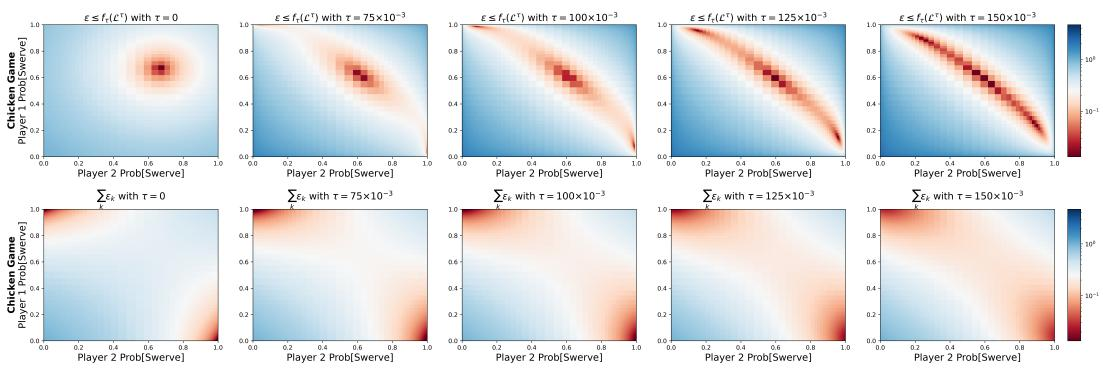
作者随后分析熵正则化损失的优化景观。虽然损失通常非凸,但它在相关内部区域上有界且 Lipschitz 连续,使标准非凸优化假设适用。Lτ 的梯度可以通过投影梯度项和博弈的局部曲率信息表达,而 Hessian 可分解为一个 Gram 矩阵项和一个在均衡处消失的项。在均衡附近,有效单纯形方向上的正定性对应于局部强凸性。作者引入多矩阵隔离均衡(polymatrix-isolated equilibrium)概念,当博弈的局部多矩阵近似在联合单纯形切空间中产生满秩曲率证书时发生。该条件有助于区分孤立均衡与多个均衡可能连通的退化区域。
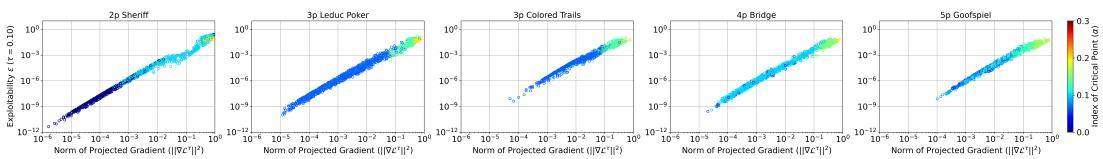
景观分析还阐明了为什么尽管损失非凸,优化在实践中仍然可行。损失曲面可能包含许多鞍点,但这些鞍点通常与高可利用性相关,而不是虚假均衡。参考下图:
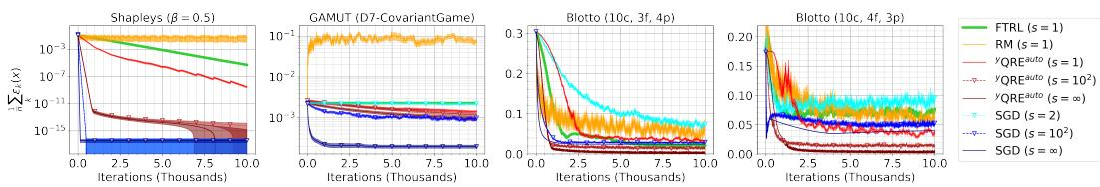
在该形式化基础上,作者探索两种优化策略。第一种是将随机梯度下降应用于 Lτ。在每次迭代中,算法构造投影梯度损失的无偏采样估计,并更新策略组合,同时使策略保持在单纯形上。SGD 通常不提供全局收敛,并且可能卡在鞍点附近,但它受益于朝向平坦极小值的隐式正则化,并在若干基准博弈上表现出良好的经验性能。如下图所示:
第二种策略使用基于 bandit 的全局优化来缓解局部极小值和鞍点。算法不是仅跟随梯度,而是通过细化策略单纯形的网格或划分,并使用无偏损失估计量评估采样点,系统探索联合策略空间。这一探索与利用过程可被解释为纳什均衡近似中排除方法的随机推广。在假设所有量化响应均衡都是多矩阵隔离均衡的条件下,bandit 方法获得到高概率多项式收敛率来近似纳什均衡。近似质量随温度 τ 降低而改善,而收敛界中的常数则随正则化损失相关的 Lipschitz 行为而增大。
实验
实验在若干博弈族上评估随机梯度下降,并将其与成熟的可扩展均衡近似方法进行比较。结果表明,SGD 具有广泛竞争力,在博弈结构支持收敛时表现尤其良好,例如在修改后的 Shapley 博弈中,而 Blotto 等具有挑战性鞍点结构的博弈仍然更加困难。总体而言,这些发现验证了 SGD 是一种有效且对结构敏感的近似均衡计算优化器。
此前标准式博弈的损失函数在通过采样博弈估计收益时往往有偏,因为它们的估计量在 max 算子或单纯形投影内部涉及随机变量。所列障碍表明,可利用性、NashConv 类损失、完全可微可利用性以及基于梯度的 NashConv 都需要非线性期望,而这些期望并不容易以无偏方式估计。这一背景表明,通过将非线性投影替换为线性切空间投影并使用独立样本,可以实现无偏估计。当直接估计采样收益上的 max 时,可利用性和 NashConv 损失会变得有偏。完全可微可利用性在采样下仍然困难,因为它也会评估带有随机收益的 max 算子。基于梯度的 NashConv 需要将随机梯度步投影到单纯形上,这会引入投影偏差。除非先投影无约束坐标,单纯形约束方法会造成采样歧义。
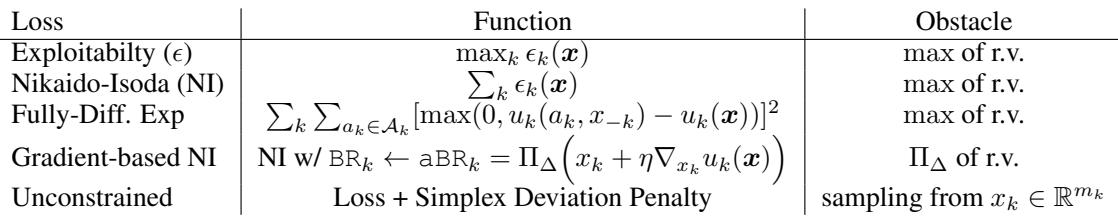
实验考察了为什么常见博弈论损失在从采样博弈估计收益时往往有偏。研究发现,可利用性、NashConv 类目标、完全可微可利用性以及基于梯度的 NashConv 都涉及难以无偏估计的非线性期望或单纯形投影。这些发现支持使用带独立样本的线性切空间投影进行无偏估计,同时表明单纯形约束方法需要谨慎处理以避免采样歧义。