Command Palette
Search for a command to run...
上下文分类任务中数据依赖性与突变学习的机制基础
上下文分类任务中数据依赖性与突变学习的机制基础
Gautam Reddy
摘要
Transformer 模型展现出上下文学习能力:能够基于输入序列中的示例准确预测新查询的响应。上下文学习与传统的在模型权重中习得查询-输出映射关系的方式形成对比。训练数据分布和架构的哪些方面分别有利于上下文学习与权重内学习?近期研究表明,语言固有的特定分布特性——如突发性、大词典规模以及偏斜的秩频分布——控制着这两种学习形式之间的权衡或同时出现。我们首先证明,这些结果可在简化的数据集上训练的最小化纯注意力网络中得到复现。上下文学习(ICL)由归纳头的突变涌现所驱动,随后归纳头与权重内学习展开竞争。通过识别先于上下文学习的进度指标并开展针对性实验,我们构建了一个归纳头的两参数模型,该模型能够复现基于注意力的网络所展现的全部数据分布依赖性。一个关于归纳头形成的现象学模型将其突变涌现追溯到由内在课程所促成的三个嵌套 logit 的依次学习。我们提出,基于注意力的网络中出现的急剧转变源于实现上下文学习所必需的特定多层操作链,该操作链由训练过程中依次习得的嵌套非线性来实现。
一句话总结
普林斯顿大学、NTT Research 和哈佛大学的研究人员揭示了仅注意力 Transformer 中上下文学习的机制基础。研究证明,这种能力之所以会突然涌现,是因为归纳头的形成驱动了这一转变;而归纳头的形成又通过依次学习由内在课程促成的嵌套 logits 来实现。此外,一个仅包含两个参数的最小模型可以复现包括突发聚集性和偏斜秩频分布在内的数据分布效应。
核心贡献
- 该论文在简化数据集上训练的最小仅注意力网络中,复现了影响上下文学习与权重内学习平衡的数据分布依赖性,并表明上下文学习是由归纳头的突然涌现所驱动。
- 这项工作建立了归纳头的两参数模型,并确定了进度指标和针对性实验,用于捕捉突发聚集性、大规模字典和偏斜秩频分布等特征如何塑造学习动态,且该模型能够模拟注意力网络的更广泛分布依赖性。
- 论文构建了损失景观的现象学模型,用以解释上下文学习的突然转变;该转变被描述为由内在课程促成的三个嵌套 logits 的依次学习,从而为 Transformer 训练中的陡峭转变提供了机制性解释。
引言
大语言模型表现出上下文学习,即提示中的示例查询响应配对使模型无需更新权重即可回答新查询。这一点很重要,因为它支持零样本泛化,并经常在训练过程中突然出现,有时还伴随支持简单关联复制的归纳头形成。已有工作识别了偏向上下文学习而非权重内学习的数据分布特征,但这一突然转变的机制来源以及所需的最小电路仍不清楚。作者利用简化的两层仅注意力设置,证明归纳头的形成驱动这一转变,并建立了一个结合损失景观分析的最小模型,以解释嵌套非线性造成的剧烈动态。
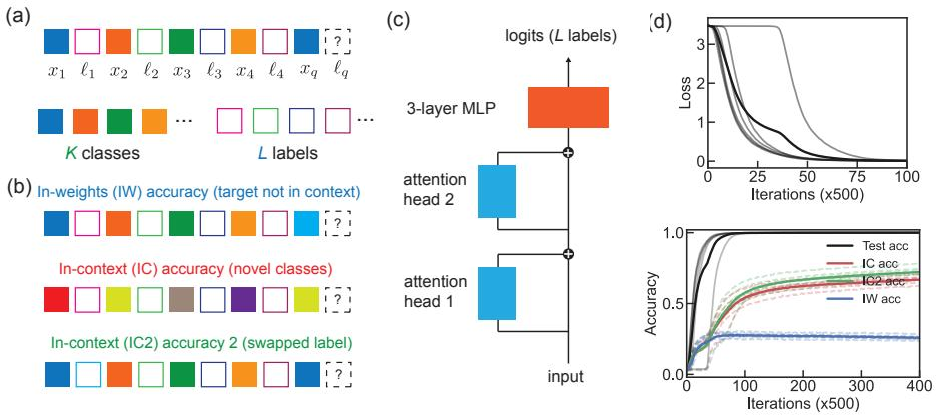
方法
作者使用一个基于因果序列的框架,训练一个类 Transformer 的注意力网络,使其能够从上下文项和标签交替组成的序列中预测目标项的标签。网络观察到形如 x1,ℓ1,x2,ℓ2,…,xN,ℓN,xq,? 的提示,并被训练将目标 xq 分配给 L 个标签之一。前 N 个带标签配对提供上下文信号,而最后未分配标签的查询需要预测。这一设置允许模型依赖权重内学习,即使用参数中记忆化的类结构,或者依赖上下文学习,即使用提示明确提供的标签信息。参见框架图。
每个项目和标签都在 P+D 维度中表示。前 P 个维度编码位置,其余 D 个维度编码内容。位置由一个 one-hot 向量表示,输入序列被放置到位置范围内的一个长度为 2N+1 的随机窗口中。这种随机窗口放置有助于产生平移不变计算,减少对绝对位置线索的依赖,并使任务对项目和标签之间的局部关联结构更敏感。
项目内容由具有 K 个类别的混合高斯模型生成。对于具有平均向量 μk 的类别 k,项目 xi 的归一化内容向量为
x~i=1+ε2μk+εη,其中 η 与 μk 具有相同分布,ε 控制类内变化。归一化使平均项目范数接近 1。类别被分配到 L 个标签,标签向量在训练前也从同一内容分布中采样。在给定提示中,每个标签出现次数相同,而训练目标保证至少有一个上下文项属于目标类。训练对最终标签预测使用交叉熵损失。
除类别数和类内噪声外,数据分布还可以进一步调节。主要控制变量是类别秩频分布和突发聚集性。突发聚集性指定同一类别的重复项目在提示中出现的数量,并且比例为 pB 的训练序列遵循这种突发结构。该参数化使网络能够接触不同强度的上下文冗余和类别不平衡。
为了区分权重内学习与上下文学习,作者使用互补评估协议。对于权重内学习,目标项和上下文项独立采样自训练类别分布,使目标类别很少出现在提示中。网络因此必须依赖编码在权重中的类结构。对于上下文学习,目标项和上下文项属于新类别,只有标签关联可以通过提示获得。网络必须使用提示中的标签结构,而不是记忆化的类知识。第二个上下文指标进一步在评估期间交换标签,从而移除标签记忆化的好处,因此模型必须遵循提示中提供的标签绑定。
架构是一个两层仅注意力编码器,后接分类头。每个注意力层包含一个因果注意力头。给定输入序列 u1,u2,…,un,第一注意力层计算
vi=ui+V1j≤i∑pij(1)uj,第二层计算
wi=vi+V2j≤i∑pij(2)vj.注意力权重定义为
pij(μ)=∑k≤iexp((Kμuk)⊤(Qμui))exp((Kμuj)⊤(Qμui)),其中 Qμ、Kμ 和 Vμ 是第 μ 层的查询、键和值矩阵。最终表示 wn 被传入一个带 ReLU 激活的三层 MLP,并输出关于 L 个标签的 softmax。分类器被刻意设计得较深,以便即使底层类别数量较大,仍可行使较强的权重内分类。
除非另有变化,训练使用固定的核心参数,包括 L=32、N=8、D=63、ε=0.1,以及平坦类别秩频分布指数 α=0。注意力的 query-key 维度和 MLP 隐藏维度均为 128。每个实验在多个随机种子上重复进行,训练使用批量大小 128,并使用学习率为 0.01 的朴素随机梯度下降。训练曲线同时跟踪权重内准确率和上下文准确率,从而能够把模型的学习动态解释为记忆类结构与利用提示中标签关联之间的权衡。
实验
使用在合成序列上训练的简化 Transformer,实验系统改变突发聚集性、类别多样性、类内变化和频率偏斜等数据分布属性,以检验上下文学习和权重内学习何时出现、竞争或共存。结果复现了已知的分布权衡,表明高度偏斜的频率可以促进这两种学习形式,并证明不同机制可以共同获得。注意力动态以及使用最小归纳头模型进行的消融研究表明,初始阶段缓慢学习上下文标签会为网络向结构化注意力和零样本复制的突然转变做准备,支持归纳头形成是上下文学习背后的核心机制。现象学损失景观分析进一步将这种突然性解释为对嵌套决策 logits 的依次优化,并表明更容易的上下文线索可以提供内在课程,以便可靠地获得上下文解。