Command Palette
Search for a command to run...
IS IMAGENET WORTH 1 VIDEO? LEARNING STRONG IMAGE ENCODERS FROM 1 LONG UNLABELLED VIDEO
IS IMAGENET WORTH 1 VIDEO? LEARNING STRONG IMAGE ENCODERS FROM 1 LONG UNLABELLED VIDEO
Shashanka Venkataramanan Mamshad Nayeem Rizve João Carreira Yuki M. Asano Yannis Avrithis
摘要
Self-supervised learning has unlocked the potential of scaling up pretraining to billions of images, since annotation is unnecessary. But are we making the best use of data? How more economical can we be? In this work, we attempt to answer this question by making two contributions. First, we investigate first-person videos and introduce a "Walking Tours" dataset. These videos are high-resolution, hourslong, captured in a single uninterrupted take, depicting a large number of objects and actions with natural scene transitions. They are unlabeled and uncurated, thus realistic for self-supervision and comparable with human learning. Second, we introduce a novel self-supervised image pretraining method tailored for learning from continuous videos. Existing methods typically adapt imagebased pretraining approaches to incorporate more frames. Instead, we advocate a "tracking to learn to recognize" approach. Our method called DORA, leads to attention maps that Discover and tRAck objects over time in an end-to-end manner, using transformer cross-attention. We derive multiple views from the tracks and use them in a classical self-supervised distillation loss. Using our novel approach, a single Walking Tours video remarkably becomes a strong competitor to ImageNet for several image and video downstream tasks. Dataset and code can be found at https://shashankvkt.github.io/dora.
一句话总结
DORA 是一种自监督图像预训练方法,通过 Transformer 交叉注意力在连续的无标注视频中发现并跟踪对象随时间的变化,从跟踪结果中导出多个视图,并将这些视图用于自监督蒸馏损失,使得单个 Walking Tours 视频能够在多个图像和视频下游任务中成为 ImageNet 的强劲竞争者。
核心贡献
-
引入 Walking Tours 数据集,包含 10 段无标注、第一人称、高分辨率、时长数小时且不间断的城市巡游视频,并提供单视频划分与混合视频划分,其中混合划分的规模与 ImageNet 相当。
-
DORA 是从 DINO 改编而来的端到端自监督视觉预训练方法,使用 Transformer 交叉注意力隐式地在帧间发现并跟踪多个对象。它通过对 patch embeddings 进行 Sinkhorn-Knopp 聚类来增加跟踪对象实例的多样性,并通过经典多视图自监督蒸馏损失训练这些实例。
-
仅使用单个 Walking Tours 视频进行 DORA 预训练后得到的图像编码器,在 ADE20k 语义分割和 MS COCO 目标检测上优于使用 ImageNet 预训练的 DINO,尽管预训练数据量远少于后者。
引言
自监督学习已经通过让神经网络在大规模无标注图像数据集上预训练,推动了视觉领域的重大进展。但仅扩展图像规模会带来效率问题,因为人类主要依靠连续的第一人称经验进行视觉学习,而不是依靠静态图像库。早期基于视频的预训练常常表现不如图像预训练模型,因为它们通常依赖以对象为中心的互联网视频,将时间帧视为简单增强,或者仍然依赖大规模 ImageNet 风格数据集和预训练骨干网络。
该工作同时贡献了数据和方法。引入了 Walking Tours,即一组 10 段长、开源、第一人称步行巡游视频,这些视频密集、自然且易于检查。还提出了 DORA,一种受 DINO 启发的自监督预训练方法,该方法在帧间隐式发现并跟踪对象,并使用 Sinkhorn-Knopp 聚类来鼓励多样化实例信号用于识别。该方法能够从单个步行巡游视频产生强大的分割和检测表示,表明这是一种比盲目扩大数据集规模更高效的选择。
数据集
-
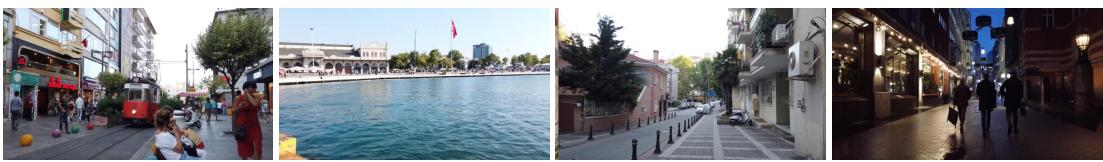
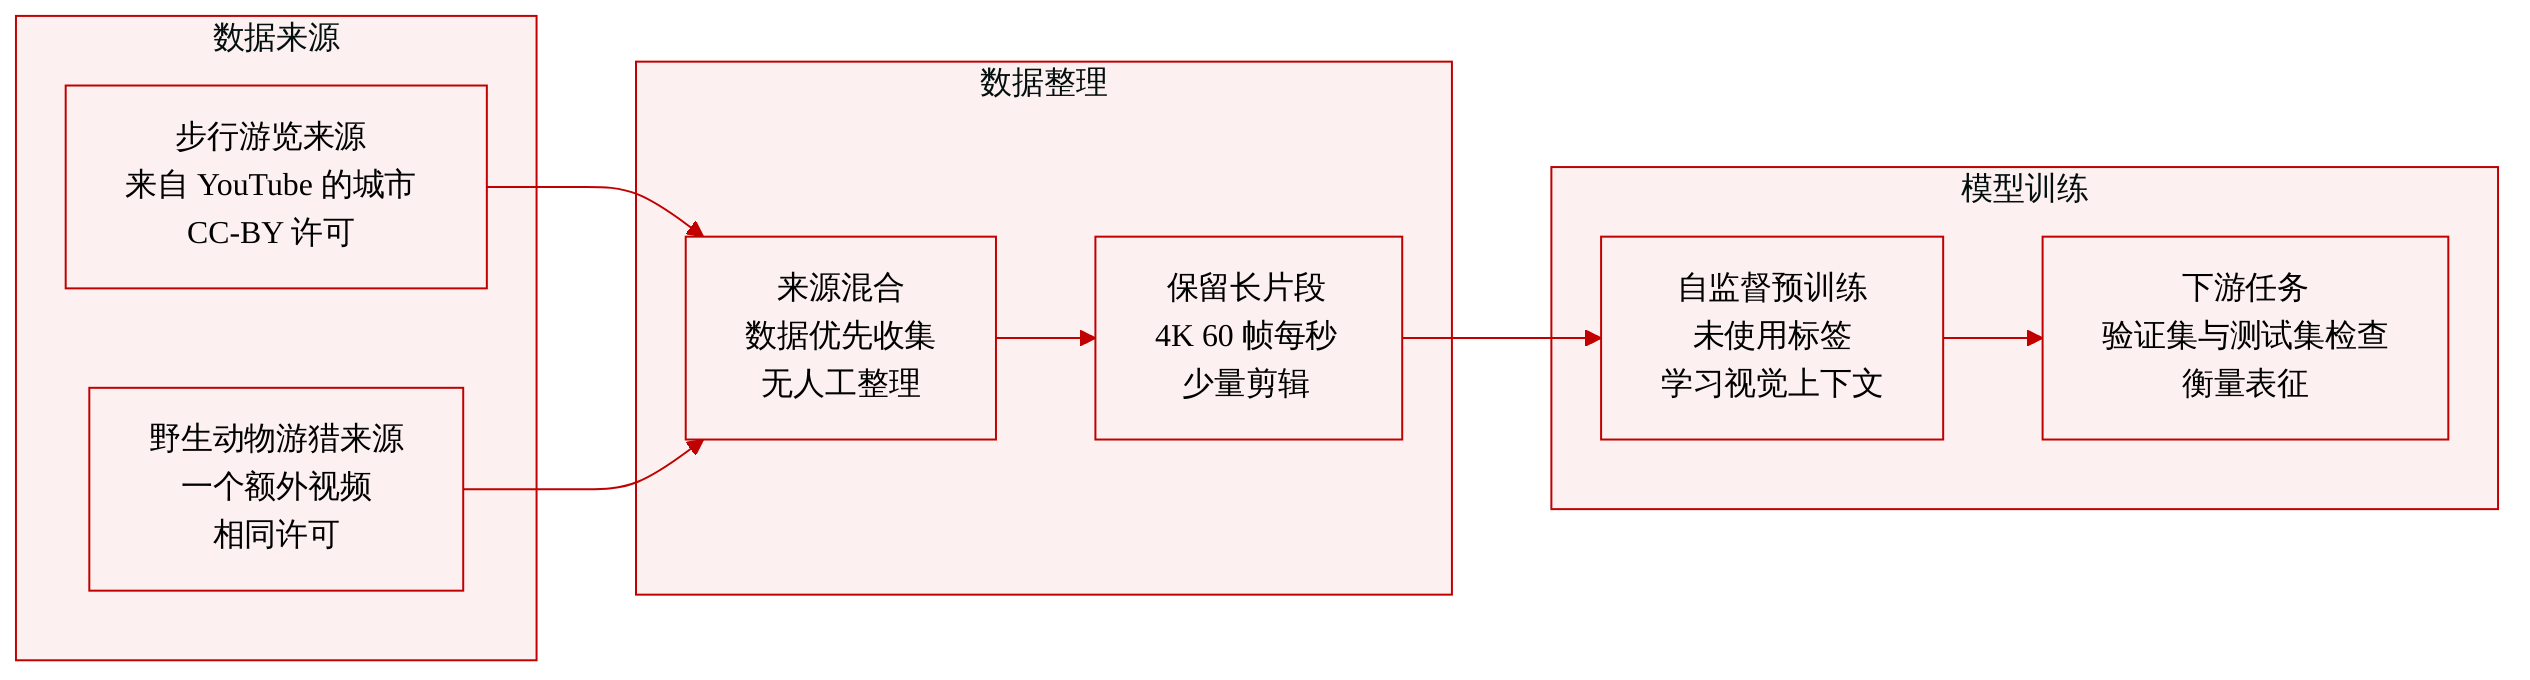
使用 Walking Tours,也称 WTours,这是一个从 YouTube 收集的新第一人称视频数据集。它包含 10 段长步行视频,拍摄地点包括阿姆斯特丹、曼谷、清迈、伊斯坦布尔、吉隆坡、新加坡、斯德哥尔摩、威尼斯和苏黎世,另有一段野生动物园视频。
-
来源是公开可用的 YouTube 影像,采用 Creative Commons CC-BY 许可证发布。该数据集以数据优先的方式收集,不进行人工策展、类别平衡控制、搜索词标注,也不要求人工标注。
-
视频为高分辨率且时长长,以 4K 分辨率拍摄,具体为 3840 × 2160 像素,60 帧每秒。时长范围从野生动物园视频的 59 分钟到曼谷的 2 小时 55 分钟,平均时长为 1 小时 38 分钟。
-
影像大多连续,平均每段视频只有一到两个镜头。作者分析认为,这种缺少剪辑的特点使 WTours 相对于其他视频数据集更适合学习长距离视觉上下文。
-
该数据集视觉密集。目标检测器分析显示,WTours 每帧包含许多对象,平均对象类别数接近 ImageNet。与 Epic-Kitchens 和 AVA 相比,WTours 的独特类别更频繁,每帧独特对象也更多。
-
视频呈现自然变化,而不是经过策展的分布。例子包括从亮到暗再到黑的渐变光照变化、跨越多样场景的转换,以及对象姿态、视点、透视、遮挡、相对位置和背景杂乱的连续变化。
-
论文将 WTours 作为无标注数据,用于无监督或自监督视觉预训练。作者评估从这些视频学习到的表示在下游任务上的表现,并利用数据集长时长、连续且开放式的结构改进视觉表示学习。
-
提供文本没有描述裁剪、元数据构建、训练划分细节或混合比例。重点在于数据集收集、属性,以及作为自监督预训练数据的用途。
方法
作者将 DORA 构建为一种 DINO 风格的自监督视频框架,利用视频时间结构发现并跟踪多个对象,而不使用外部目标检测器、光流网络或预训练跟踪器。该流程把视觉 Transformer 自身的注意力图视为对象证据来源。从单个锚点帧开始,方法识别候选对象区域,细化其空间边界,将其传播到后续帧,转换为任意形状的对象裁剪,并在教师-学生蒸馏损失中使用这些裁剪。
输入是包含 T 帧的视频片段
Xt∈RH×W×C,t∈{1,…,T}.每帧被划分为 N=HW/p2 个大小为 p×p 的不重叠 patch。patch 被线性投影为维度 d 的 token embeddings,并在序列前添加一个 [CLS] token embedding。得到的序列由视觉 Transformer 编码器处理,产生
Zt=gθ(Xt)∈R(N+1)×d.输出被拆分为 [CLS] embedding 和 patch embeddings:
Zt=[Zt[CLS];Z~t],其中 Zt[CLS]∈R1×d,Z~t∈RN×d。遵循 DINO,存在参数为 θ 的学生网络和架构相同、参数为 θ′ 的教师网络,后者通过指数移动平均更新:
θ′←αθ′+(1−α)θ.包含 tokenizer、编码器和预测头的完整映射记为 fθ。预测头包含 MLP 和缩放 softmax,因此 token 输出可解释为概率分布。
对象发现从初始帧 Xt0 开始。在教师网络的最后一层 Transformer 中,计算 query 和 key embeddings:
Q,K∈R(N+1)×d.对于有 m 个头的多头注意力块,这些嵌入被划分为
Q=[Q(1),…,Q(m)],K=[K(1),…,K(m)],其中 Q(r),K(r)∈R(N+1)×d/m。每个头计算自注意力:
A(r)=softmax(dQ(r)(K(r))⊤)∈R(N+1)×(N+1).第 r 个头的 [CLS] 注意力向量是 A(r) 中衡量从 [CLS] 到 patch tokens 注意力的行:
A(r,[CLS])=[a1,2(r),…,a1,N(r)]∈R1×N.作者随机选择 k<m 个头组成的子集 I={i1,…,ik},并堆叠它们的 [CLS] 注意力向量:
AI=[(A(i1))[CLS];…;(A(ik))[CLS]]∈Rk×N.直观上,AI 的每一行对应一个注意力图,能够捕获不同对象或显著区域。为了在嵌入空间中获得对象表示,这些注意力图被用于组合 patch query embeddings:
P=AIQ~∈Rk×d.矩阵 P 充当从初始帧导出的 k 个对象原型的集合。
给定这些原型,时间跟踪的第一步是针对另一帧 t 的 patch keys 使用交叉注意力:
Tt=softmax(dPK~t⊤)∈Rk×N.Tt 的每一行是一个注意力图,旨在在帧 t 中定位一个对象。然而,原始注意力图常在空间上重叠,这意味着单个图可能关注多个对象或背景区域。
为了改进对象分离,作者使用最优传输在对象原型和 patch tokens 之间建立显式对应关系。设锚点帧的教师 patch embeddings 为 Z~t0∈RN×d。目标是找到传输计划
M∈Rk×N使 k 个原型 P 与 N 个 patch Z~t0 对齐。成对相似度成本取为
C=−PZ~t0⊤∈Rk×N.传输计划通过 Sinkhorn-Knopp 归一化获得:
M∗=SK(exp(ϵPZ~t0⊤))∈Rk×N.这里 ϵ 是熵正则化系数。矩阵 M∗ 被约束为非负且具有均匀边缘:行和为 1/k,列和为 1/N。这种均衡分配鼓励每个原型关联到一组不同 patch,同时防止所有原型坍缩到同一对象上。
细化后的对象原型随后由 patch embeddings 的加权组合构成:
P′=M∗Z~t0∈Rk×d.这些细化原型用于在帧 t 上计算改进的交叉注意力图:
Tt′=softmax(dP′K~t⊤)∈Rk×N.细化减少了被跟踪对象之间的空间重叠,并产生更干净的单对象注意力图。原始注意力与细化注意力的比较如下所示。
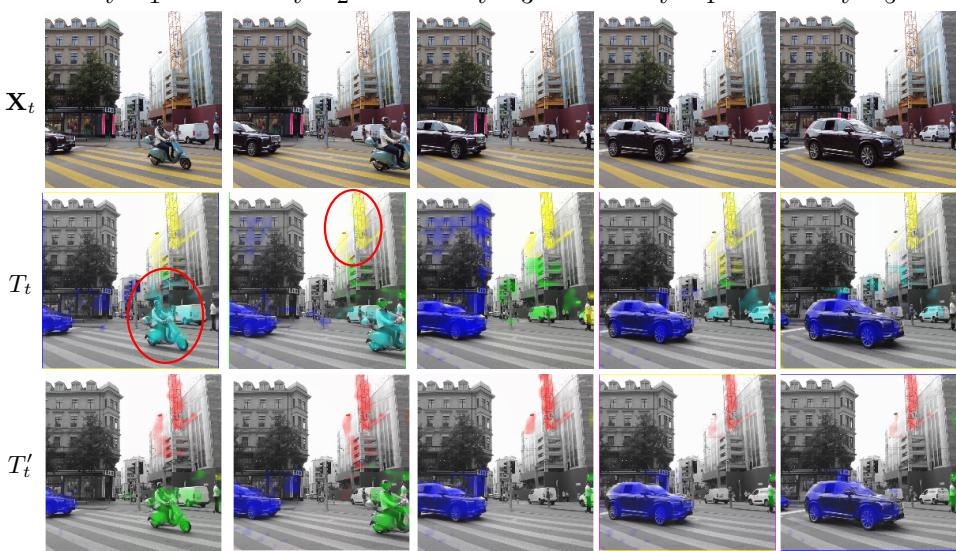
细化后的交叉注意力图随后被转换为学生分支的掩码。对每个对象 i∈{1,…,k},Tt′ 的第 i 行从 N 个注意力值重塑为 H/p×W/p 空间图,并上采样到 H×W,以匹配原始帧分辨率。它在通道维度上平铺形成
Tti∈RH×W×C.对象掩码帧通过 Hadamard product 得到:
Xtoi=Xt⊙Tti.该操作创建了由注意力驱动形状而非矩形框驱动的任意形状对象裁剪。因为原型通过交叉注意力随时间被跟踪,这些裁剪对应时间一致的对象视图。
训练时,方法遵循 DINO 的全局视图方案。对每一帧 Xt,生成两个标准的全局增强视图:
Xta,Xtb.此外,每个全局视图都可以转换为掩码对象视图 Xtv,oi,其中 v∈{a,b} 且 i∈{1,…,k}。多对象蒸馏损失鼓励教师网络对一个视图的全局表示预测学生网络对另一视图的对象掩码版本的表示。对帧 t,多对象损失写为
LtO=u,v∈{a,b},u=v∑i=1∑kCE(fθ′(Xtu)[CLS],fθ(Xtv,oi)[CLS]),其中 CE 表示教师 [CLS] 输出与学生 [CLS] 输出之间的交叉熵。掩码后的学生输入起到类似 DINO 中局部裁剪的作用,但它能跨多帧跟踪对象,并且其非矩形形状由注意力决定。
除了该多对象损失外,作者还按照 multi-crop 自监督训练设计应用局部损失。最终目标是多对象全局损失与局部损失之和,并对片段中的所有帧取平均:
L=T1t=1∑T(LtO+Ltlocal).这形成了一种训练信号,要求模型学习对增强后的全局视图保持不变的表示,同时对由网络内部注意力直接生成的、以对象为中心且时间一致的掩码视图保持准确。
实验
实验通过在对 WTours 视频上进行自监督预训练来评估 DORA,并通过冻结特征分类、无监督对象发现、视频对象分割,以及微调后的密集预测和跟踪来测试所学表示。消融实验显示,单段 WTours 视频比时长相同的以对象为中心或第一人称数据集更有效,跟踪三个对象效果最佳,而多对象掩码对于强对象-patch 对应关系至关重要。与最先进方法的比较显示,DORA 在密集任务和视频任务上泛化良好;非对比预训练在单个 WT 视频上尤其强大,额外的 WTours 数据只带来有限收益。
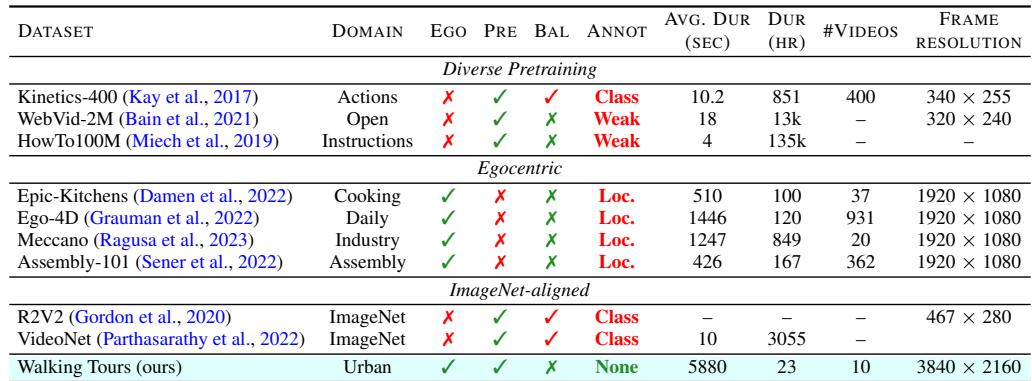
将 Walking Tours 与以往视频数据集比较,它作为连续、更长、更高分辨率的在线视频来源且未经策展。它依赖数据优先的收集方式,而不是搜索词或人工策展,因此可扩展,适合自监督表示学习。下游结果显示,在 Walking Tours 上预训练能够在密集视觉任务和冻结特征任务上取得强大性能。Walking Tours 视频比更早的第一人称数据集更长、更连续且分辨率更高。该数据集未经策展,不需要搜索词或人工标注工作。在 Walking Tours 上预训练的模型相比可比较基线提升了密集预测和特征学习任务。
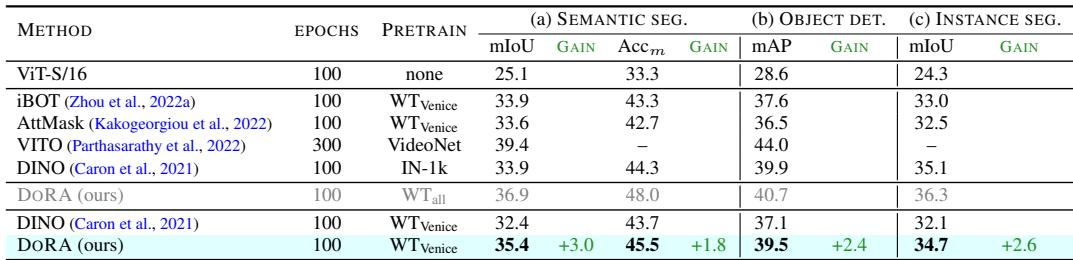
密集感知结果表明,步行巡游视频预训练能改进 ViT-S/16 模型在语义分割、目标检测和实例分割上的表现。在所有 WTours 视频上预训练的 DORA 在这些任务上优于在 ImageNet-1k 上预训练的 DINO,甚至单个步行巡游视频也能产生有竞争力的分割性能。这表明步行巡游预训练为密集预测提供了强且数据效率高的表示。对于相同的 ViT-S/16 骨干网络,步行巡游视频预训练相对于 ImageNet-1k 预训练改进了密集场景理解。在所有 WTours 视频上训练 DORA,在语义分割、目标检测和实例分割上超过在 ImageNet-1k 上训练的 DINO。单个步行巡游视频即可产生有竞争力的分割性能,表明密集预测具有很强的数据效率。
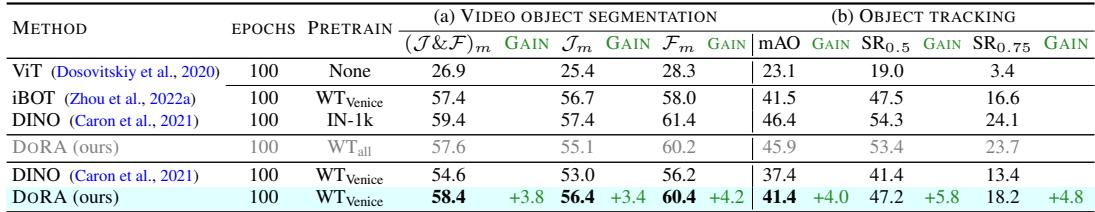
冻结特征下的视频对象分割表明,在相同预训练设置下,使用单个 Walking Tours 视频预训练的 DORA 在区域相似度和轮廓准确率上都优于 DINO。即使使用少得多的预训练数据,它也达到接近 ImageNet 预训练 DINO 的分割性能。面向多对象跟踪的微调使 DORA 在平均重叠和成功率上相对 DINO 获得一致提升。当二者都使用单个 Walking Tours 视频预训练时,DORA 在视频对象分割上优于 DINO。仅使用一个 Walking Tours 视频,DORA 的分割分数接近 ImageNet 预训练 DINO。DORA 在多对象跟踪的重叠和成功指标上比 DINO 提升几分。
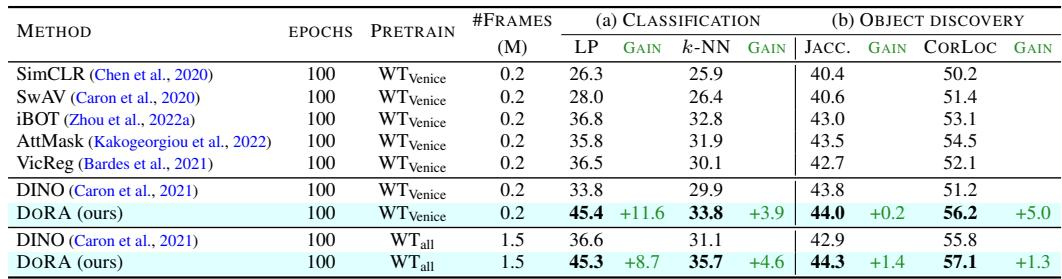
在步行巡游视频上预训练并冻结特征后,非对比方法在图像分类和无监督对象发现上都优于对比方法。DORA 在这些冻结特征评估上相对 DINO 表现出明显优势,而从单个步行巡游视频扩展到完整步行巡游数据集只给 DORA 带来很小的额外提升。在单个步行巡游视频上,非对比预训练比对比预训练带来更强的冻结特征分类和对象发现能力。当在单个步行巡游视频上训练时,DORA 在分类和无监督对象发现上都优于 DINO。完整步行巡游数据集相比单个视频只为 DORA 提供有限额外收益。
实验将 Walking Tours 评估为一种可扩展、未经策展的连续、更长、更高分辨率第一人称视频来源,用于自监督预训练。密集视觉基准表明,在 Walking Tours 上预训练,尤其是采用非对比方法,相对于可比较基线改善了语义分割、目标检测、实例分割,以及冻结特征视频对象分割和跟踪,即使使用有限的预训练数据也是如此。冻结特征评估进一步表明,这些表示在图像分类和无监督对象发现上具有强大质量,而超出单个视频的更大数据集只带来很少额外收益。