Command Palette
Search for a command to run...
元持续学习再探:通过方差缩减隐式增强在线 Hessian 近似
元持续学习再探:通过方差缩减隐式增强在线 Hessian 近似
Yichen Wu Long-Kai Huang Renzhen Wang Deyu Meng Ying Wei
摘要
基于正则化的方法一直是持续学习领域事实上的主流选择。近期的理论研究表明,这些方法本质上均依赖于模型权重的 Hessian 矩阵近似。然而,由于训练过程中 Hessian 估计是固定不变的,这些方法在知识迁移与灾难性遗忘之间只能取得次优的权衡。另一条看似平行的研究路线——元持续学习(Meta-CL)算法,强制要求先前任务的梯度与当前任务的梯度保持一致。在本工作中,我们重新审视了 Meta-CL,并首次将其与基于正则化的方法建立联系。具体而言,Meta-CL 以在线方式隐式地近似 Hessian 矩阵,这种方式既能享受及时自适应的优势,同时也面临着随机记忆缓冲区采样所导致的高方差问题。因此,我们致力于将两者的优势相结合,提出了方差缩减元持续学习(VR-MCL),以实现既及时又准确的 Hessian 近似。在三个数据集及多种实验设置下的全面实验中,我们一致观察到 VR-MCL 优于其他 SOTA 方法,这进一步验证了 VR-MCL 的有效性。
一句话总结
香港城市大学、Tencent AI Lab、西安交通大学等机构的研究人员提出了 Variance Reduced Meta-CL(VR-MCL)。该方法通过证明 Meta-CL 隐含地执行在线 Hessian 近似,并对记忆缓冲区采样施加方差缩减,从而连接 Meta-Continual Learning 与基于正则化的方法,实现及时且准确的 Hessian 估计。
核心贡献
-
Meta-CL 通过将其超梯度刻画为在线、隐式 Hessian 近似,与基于正则化的持续学习联系起来,从而实现及时二阶适应,同时暴露随机记忆缓冲区采样带来的方差。
-
VR-MCL 引入一种基于动量的超梯度方差缩减技术,用于稳定在线 Hessian 估计,惩罚错误的低曲率更新,并更好地保留对先前任务重要的权重。
-
理论分析表明,该方差缩减等价于对隐式估计的 Hessian 施加惩罚,并给出 regret 上界;在三个数据集和多种持续学习设置下的实验表明,该方法相较于最先进方法取得一致提升。
引言
持续学习的目标是让系统从不断变化的数据流中按顺序学习,同时保留较早学到的知识,这对标准 i.i.d. 监督学习假设失效的真实世界自适应模型非常重要。先前基于正则化的方法通过基于 Hessian 的重要性度量来估计任务重要性,从而保护重要参数,但这些估计在训练后固定,并随着模型参数漂移而变得不够准确。Meta-Continual Learning 使用记忆缓冲区样本通过超梯度在线更新二阶信息,然而不完整或有偏的记忆采样会引入高方差和有害的 Hessian 估计。作者利用 Meta-CL 的在线二阶视角,将其与基于正则化的 Hessian 近似联系起来,并提出 Variance-Reduced Meta-CL。这是一种基于动量的方法,能够降低超梯度方差,并起到对估计 Hessian 的隐式正则化作用,从而帮助抑制过度更新并保留先前学到的知识,同时提供理论保证和实验验证。
方法
作者利用统一的迭代更新视角,连接基于正则化的持续学习、meta continual learning 以及所提出的方差缩减算法。在持续学习中,模型接收任务序列 T1,T2,…,TN,其中第 i 个任务包含样本 (xni,yni)。理想目标是学习参数 θ,使其最小化所有已观察任务上的平均经验风险:
θminj1i=1∑jLi(θ).然而,当模型在当前任务 Tj 上训练时,无法直接访问先前任务 T[1:j−1] 的原始数据。因此,基于正则化的方法转而近似先前任务风险,而不是直接优化该风险。围绕训练任务 Ti 后得到的参数 θ^i 做二阶泰勒展开,先前风险可以近似为
Lj−1prox(θ)=i=1∑j−1constant termLi(θ^i)+gradient term(θ−θ^i)⊤∇θLi(θ^i)+Hessian term21(θ−θ^i)⊤Hi(θ−θ^i),其中 Hi=∇θ2Li(θ^i) 是任务 Ti 的 Hessian 矩阵。第一项不依赖于 θ,而梯度项通常接近零,因为每个任务通常会训练到收敛。因此,最重要的近似是 Hessian 项。由此得到统一的正则化更新规则
θ≈θ−α(i=1∑j−1Hi)−1∇θLj(θ),其中 α 是学习率。在该更新中,具有较大 Hessian 曲率的方向对应于先前任务的重要权重。将梯度乘以逆 Hessian 会抑制沿这些高曲率方向的更新,同时允许沿低曲率方向进行更大的更新,因为低曲率方向更符合当前任务。
从这个角度看,许多基于正则化的方法可以被视为不同的 Hessian 近似设计。例如,对角 Fisher 信息矩阵、对角重要性估计和 Kronecker 分解近似都可用于替代或近似累积的 Hessian。核心设计原则是:更好的曲率估计能够在旧任务上的稳定性与新任务上的可塑性之间取得更好的权衡。
Meta continual learning 将同一问题重新表述为双层优化。它不是显式存储或估计每个任务的 Hessian,而是计算一个超梯度,将来自未来内循环更新的信息传播回当前模型参数。具体而言,给定存储先前任务样本的记忆缓冲区 M,该方法优化
θminL[1:j](θ(K))s.t.θ(K)=UK(θ;Tj),其中 UK 表示在当前任务上的 K 步内循环更新。一步内循环更新写为
U(θ(k);T(k)j)=[θ−β∇θL(k)j(θ)]θ=θ(k−1),其中 β 是内循环步长,T(k)j 是从 Tj 中采样的 minibatch。
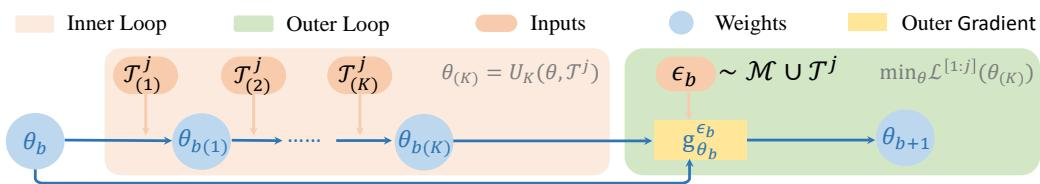
Meta-CL 的迭代更新可以分为内循环和外循环。在内循环中,模型从 θb(0)=θb 开始,使用当前任务样本进行 K 步更新,得到 θb(K)。在外循环中,从当前任务和记忆缓冲区 M 的并集中采样数据 ϵb,并相对于起始参数 θb 计算超梯度
gθbϵb=∂θb∂L(θb(K);ϵb).随后使用该超梯度更新模型。如图所示:
作者进一步证明,在单内步简化下,Meta-CL 也遵循相同的 Hessian 式更新规则:
θ≈θ−α(HMj)−1∇θLj(θ).这里,HMj 是从记忆缓冲区 M 中采样的样本估计出的隐式 Hessian。这使 Meta-CL 相比经典正则化方法具有优势,因为 Hessian 信息可以持续更新,而不是在每个先前任务结束时固定。
然而,这种基于记忆的估计也引入了弱点。如果 M 不包含来自某个先前任务的足够代表性样本,那么隐式 Hessian 可能错误地把低曲率分配给对该任务实际重要的权重。在这种情况下,沿这些方向的更新不会被充分抑制,从而导致遗忘。因此,降低超梯度方差也会降低隐式估计 Hessian 的方差。
为解决这一问题,作者提出 Variance Reduced Meta Continual Learning,简称为 VR-MCL。标准方差缩减方法(如 SAG、SAGA 和 SVRG)需要任务中所有样本的全批量梯度,这在线持续学习中很难实现,因为数据以 minibatch 形式到达,且完整任务集可能永远不可见。VR-MCL 转而采用基于动量的方差缩减设计。在外层迭代 b,它保留来自上一次迭代的动量分量,并复用当前外层数据来评估一个修正项。
第 b 次迭代的更新流程如图所示:
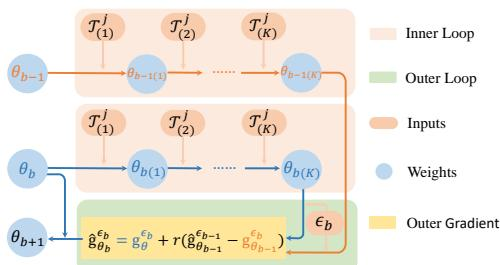
在该框架中,g^θb−1ϵb−1 存储来自前一个外层步的缩减梯度,gθb−1ϵb 表示使用当前外层数据 ϵb 在先前参数轨迹上评估得到的超梯度,gθbϵb 表示在当前参数轨迹上评估得到的超梯度。方差缩减后的更新梯度为
g^θbϵb=gθbϵb+r(g^θb−1ϵb−1−gθb−1ϵb),其中 r 是动量比例。该更新利用存储的前次缩减梯度与在前一参数处新计算的超梯度之间的差异来纠正采样噪声。最终模型参数可以更新为
θb+1=θb−αg^θbϵb.方差缩减分析考察估计梯度与未知全批量梯度方向之间的差异。令
Δb=g^θbϵb−Gθb,其中 Gθb 表示 θb 处的真实全批量梯度方向。代入 VR-MCL 更新得到
Δb=rΔb−1+(1−r)(gθbϵb−Gθb)+r(gθbϵb−gθb−1ϵb−(Gθb−Gθb−1)).第二项可以通过 r 控制,而当连续迭代之间的参数变化较小时,第三项预计较小。因此,估计误差保持有界,并可以被驱动到更小的残差,这解释了方差缩减效果。
从 Hessian 角度看,方差缩减后的梯度更新等价于修改 Meta-CL 中使用的逆隐式 Hessian。具体而言,VR-MCL 更新可以写为
θ≈θ−α(HVRj)−1∇θLj(θ),其中缩减后的逆 Hessian 具有近似形式
(HVRj)−1=(HMbj)−1+r((HMb−1j)−1−(HMb−1j)−1).这里,HMbj 是根据外层数据 ϵb 计算得到的当前 Hessian 近似,HMb−1j 对应于动量项从前一步携带的 Hessian 信息,HMb−1j 对应于使用当前数据在先前参数处评估的 Hessian。
该公式表明,VR-MCL 像是对隐式 Hessian 的正则化。如果 Meta-CL 因记忆样本不足而错误地将某个方向估计为低曲率,修正项可以降低该方向的逆曲率。在特征值记号下,当先前重要的权重被错误地赋予非常小的曲率 vb,而动量项暗示大得多的曲率 v^b−1 时,调整后的逆曲率近似为
vb−1+r((v^b−1)−1−(vb−1)−1)≤vb−1.这会使可能存储重要旧任务知识的方向上的更新更小。相反,当当前估计与先前估计之间的 Hessian 特征值已经一致时,修正项接近零,因此沿高曲率方向的更新仍然保持谨慎。这样,该算法将方差缩减视为曲率稳定化。
在随机在线设定下的光滑性、有界性和强凸性假设下,作者还推导出如下形式的 regret 上界
CRj=O(T),其中 T 是训练迭代次数,CRj 衡量已学习模型的累积损失与所观察任务的最佳固定模型之间的差距。该上界通过表明降低超梯度方差可以在线持续学习表述中带来接近最优的 regret 行为,支持了所提出训练过程的有效性。
实验
在 Seq-CIFAR10、Seq-CIFAR100 和 Seq-TinyImageNet 上的在线持续学习实验使用平均准确率和任意时刻准确率,将 VR-MCL 与代表性正则化方法、元学习方法和最先进基线进行比较。结果表明,VR-MCL 在不同基准、更小记忆缓冲区、多种骨干网络架构以及越来越不平衡的非平稳设置中均能持续提升性能,并优于其他方差缩减策略。消融实验进一步证实,该方法有效降低梯度方差并更好地利用二阶信息,支持其鲁棒性和实际有效性。
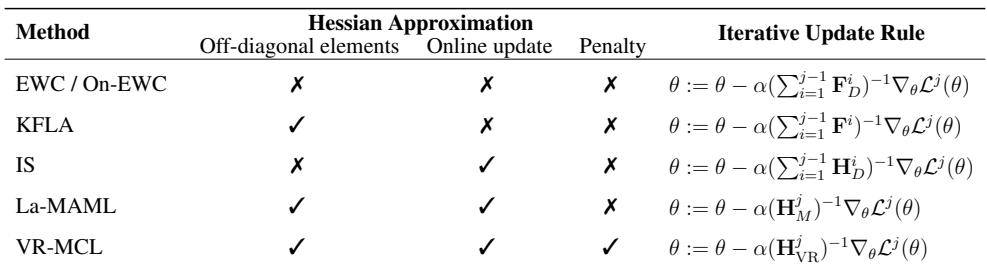
该表比较了持续学习方法,并将其表达为不同迭代更新,这些方法在近似 Hessian 曲率的准确性和自适应性上有所不同。更简单的正则化方法使用静态对角 Fisher 估计,而更高级的变体纳入完整 Fisher 信息、在线 Hessian 估计,并最终采用正则化在线 Hessian。VR-MCL 使用的正则化在线 Hessian 旨在在线持续学习条件下降低方差并提高稳定性。EWC 和 On-EWC 在统一更新规则中使用有限的对角 Fisher 近似。KFLA 通过包含非对角 Fisher 信息扩展比较。重要性采样和 La-MAML 使用在线更新,其中 La-MAML 还捕捉非对角结构。VR-MCL 结合在线 Hessian 估计、非对角结构和惩罚项,从而获得更稳定的更新。论文报告称,正则化 Hessian 近似有助于在线持续学习、不平衡任务流和更小骨干网络上的表现。
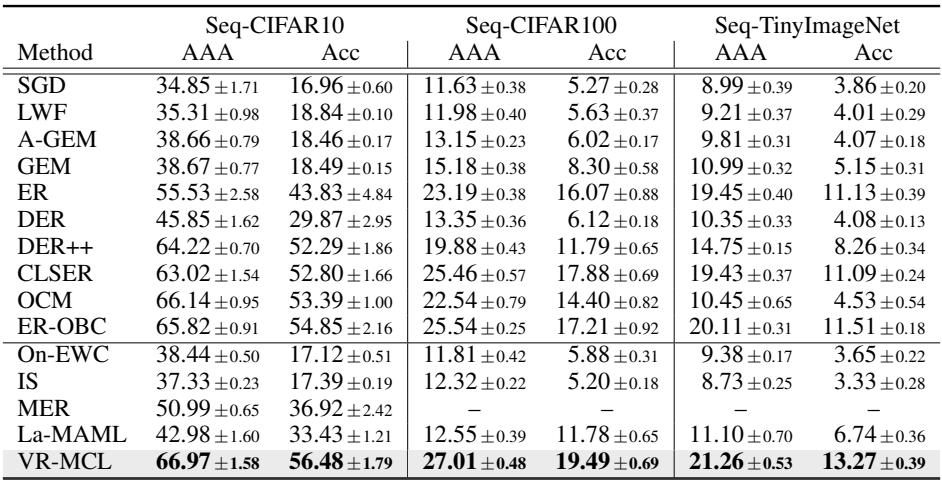
在使用较小记忆缓冲区的 reduced ResNet-18 上,回放方法和梯度约束方法在 Seq-CIFAR10、Seq-CIFAR100 和 Seq-TinyImageNet 上均优于普通 SGD。经验回放带来最大提升,而所有方法在任务序列变长且数据集更复杂时表现更差。最终准确率始终低于平均任意时刻准确率,表明在流式训练过程中性能会退化。经验回放是三个在线持续学习基准中最具竞争力的基线。GEM 优于普通 SGD,并且在更长任务序列上变得更加有用。DER 仍明显弱于经验回放,使单独回放成为所列方法中更强的方法。从 Seq-CIFAR10 转向 Seq-CIFAR100 和 Seq-TinyImageNet 时,准确率会显著下降。
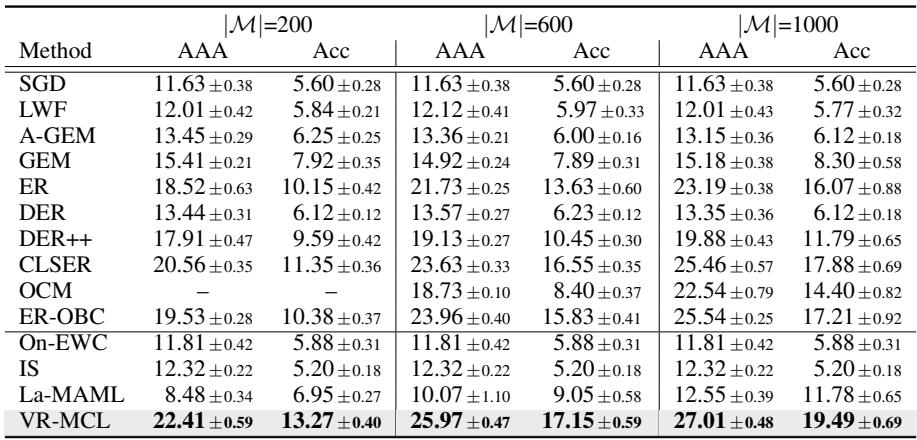
该表报告了在 Seq-CIFAR100 上使用 reduced ResNet-18 得到的平均最终准确率和任意时刻准确率,并带有 95% 置信区间,不稳定结果被省略。在不同缓冲区大小下,ER 是唯一在两个指标上都随缓冲区增大而清晰提升的方法,而其他多个基线保持不变或波动。这表明,当方法能够有效利用回放样本时,更大的记忆更有帮助。ER 在平均任意时刻准确率和最终准确率上都能随着记忆缓冲区从小变大持续提升。SGD、LWF、A-GEM、GEM 和 DER 从增大记忆规模中获得的收益不明显。
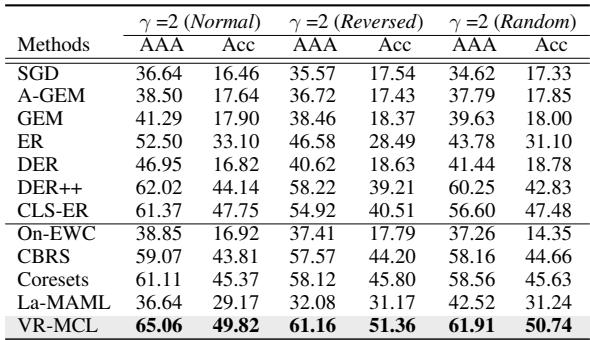
在 ratio 2 的不平衡 Seq-CIFAR10 设置中,回放方法通常在正常、逆向和随机顺序下都优于基本 SGD 和梯度投影基线。对大多数方法而言,最终准确率始终低于平均任意时刻准确率,表明后期不平衡会削弱对早期任务的保持。周围分析指出,VR-MCL 在该不平衡设置下仍然是最强方法,即使与专门为不平衡持续学习设计的方法相比也是如此。在可见结果中,ER 和 DER++ 等回放式基线相比基于正则化的方法和朴素基线表现出更清晰的提升。对大多数基线而言,正常顺序通常给出高于逆向顺序和随机顺序的平均准确率。
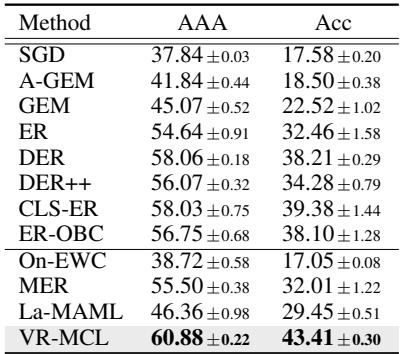
在使用 200 个记忆样本的小 PcCNN 网络上的 Seq-CIFAR10 中,回放基线优于普通 SGD 和仅基于正则化的方法。论文报告称,VR-MCL 在平均任意时刻准确率和最终准确率上均比最佳基线提升约 3 个百分点。这些比较基于 5 次运行的平均值和 95% 置信区间。在小骨干网络上,回放方法比普通 SGD 达到更强准确率。VR-MCL 在两个准确率指标上均比最佳基线提升近 3 个百分点。CLS-ER 和 DER 是最强报告基线之一。
实验在小 ResNet-18 和紧凑 PcCNN 上比较了在线持续学习基准以及消融,评估回放、正则化和梯度投影在标准任务流和不平衡任务流下的表现。这些测试验证了回放通常能够稳定性能,并从更大记忆中受益最多,而准确率在更长或更难序列上下降,并在从任意时刻准确率变为最终准确率时下降。实验表明,相比传统基线,VR-MCL 提供更稳定的在线更新和更强性能,尤其是在不平衡任务流和更小骨干网络设置中。