Command Palette
Search for a command to run...
不要从零训练:长序列模型的公平比较需要数据驱动的先验
不要从零训练:长序列模型的公平比较需要数据驱动的先验
Ido Amos Jonathan Berant Ankit Gupta
摘要
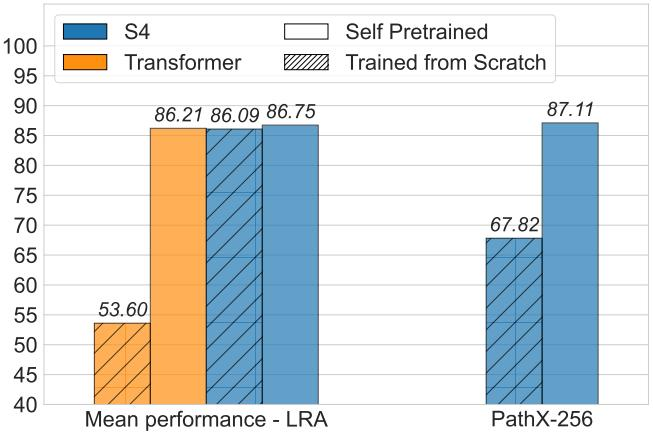
对序列中长程依赖的建模是机器学习领域长期以来的目标,并催生了如状态空间模型等在长序列上大幅超越 Transformer 的架构。然而,这些显著的实证提升主要是在基准测试(如 Long Range Arena)上展示的,其中模型被随机初始化并训练以从输入序列预测目标标签。在本工作中,我们表明随机初始化导致对架构之间差异的严重高估,而仅使用下游任务数据、以标准去噪目标进行预训练,则在多种架构上带来了显著提升,并使 Transformer 与状态空间模型(SSM)之间的差距变得极小。与先前工作形成鲜明对比的是,我们发现经过适当预训练的原始 Transformer 在 Long Range Arena 上能够匹配 S4 的性能,并将 SSM 在 PathX-256 任务上的最佳报告结果提升了 20 个百分点。随后,我们分析了先前为 SSM 提出的结构化参数化的效用,并表明在通过预训练获得的数据驱动初始化存在的情况下,这些参数化变得基本冗余。我们的工作表明,在监督任务上评估不同架构时,通过预训练引入数据驱动的先验对于可靠的性能估计至关重要,且可以高效地完成。
一句话总结
随机初始化会严重高估 Transformers 与状态空间模型在 Long Range Arena 等基准上的架构差距,而仅使用下游任务数据、以去噪目标进行预训练,可使原始 Transformers 达到与 S4 相当的性能,并使 SSM 在 PathX-256 上的结果绝对提升 20 个点。
核心贡献
-
本文表明,长程基准上的随机初始化会严重低估架构差异,并提出使用标准去噪目标在下游任务数据上进行监督预训练,以学习数据驱动先验,从而实现可靠评估。
-
在 Long Range Arena 上,预训练使原始 Transformers 的平均绝对性能提升超过 30%,使其在无需架构改动的情况下达到 S4 等先进 SSM 的水平,并在六项任务中的五项上提升 S4 性能,包括在 PathX-256 上从 67 提升到 87,绝对提升 20 个点。
-
本工作分析了结构化 SSM 参数化,发现一旦预训练学习了数据驱动初始化,它们大多变得冗余;在 Transformers 和对角线性 RNN 上可获得具有竞争力的 Long Range Arena 结果,并使用学习到的卷积核揭示学习到的长程先验。
引言
自监督预训练在机器学习中被广泛使用,下游模型通常从预训练检查点进行微调,以获得强性能。这对于长程依赖建模尤其重要,Long Range Arena 等基准表明,标准 Transformers 存在困难,从而推动设计带有手工归纳偏置的新架构。然而,从头训练这些架构,可能将架构选择导致的性能差异与缺少有用预训练目标混为一谈。作者表明,这种差异在很大程度上来自训练与评估实践,并提出自预训练,这是一种简单的数据驱动方法,直接在下游训练数据上应用去噪目标。这在不要求大规模预训练语料或架构修改的情况下产生更好的归纳偏置,在 Long Range Arena 上改进 Transformers 和状态空间模型,并表明许多手工偏置变得不必要。
实验
实验在长程序列任务上评估 Transformers 和状态空间模型,包括 Long Range Arena 和额外模态,主要通过比较从头训练的模型与在任务专属数据上自预训练的模型。结果表明,自预训练显著提高了比较的可靠性,并显示 Transformers 无需专门架构假设即可学习有效的长程依赖。在不同模型选择、数据规模和模态上,研究发现数据驱动先验在捕捉序列结构方面通常可与手工设计的偏置相媲美,甚至更有效。
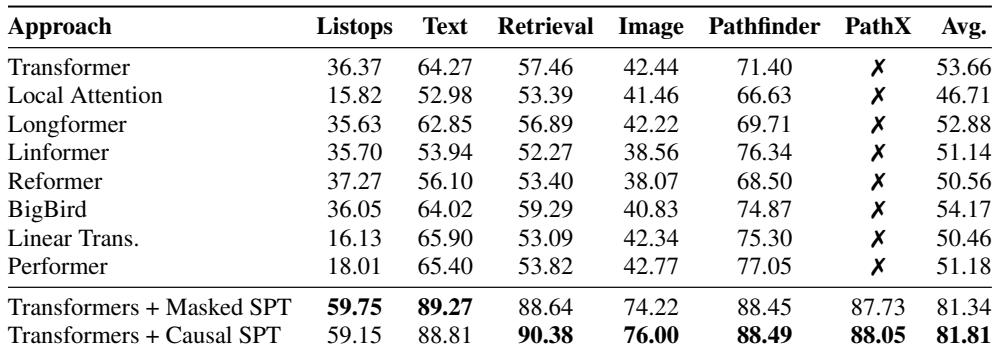
在 Long Range Arena 上,先对 Transformers 在任务数据上进行自预训练再微调,相比从头训练带来大得多的增益,使平均准确率约提升 30%。这些提升在因果目标和掩码目标下都会出现,包括 LISTOPS 等上下文可能无法为 token 预测提供很强支持的任务,这表明自预训练学习到的先验是更可靠评估的核心。与随机初始化相比,自预训练显著改善 Transformers 在 Long Range Arena 各任务上的表现。因果自预训练与掩码自预训练带来相似的增益,即使是在因果模型没有明显优势的任务上也是如此。从头训练的 Transformers 基线结果不均衡,并在 PathX 上仍处于随机猜测准确率水平。
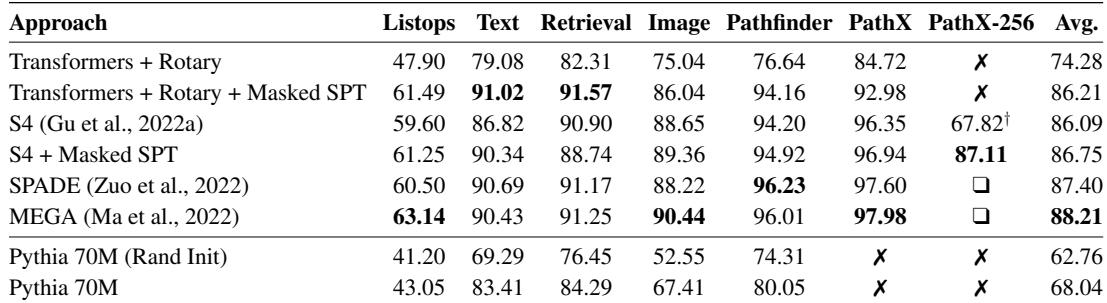
自预训练显著增强 Transformers 在序列建模任务上的能力,缩小了与强结构化序列模型的差距,并表明所需的大量归纳偏置可从数据中学习。S4 也从自预训练中受益,尤其是在最长的 Pathfinder 任务上,而文本预训练的 Transformers 仍然有用,但不如直接在目标模态上预训练有效。结果表明,在任务专属预训练下,纯注意力模型具有竞争力。掩码自预训练在整个基准上为使用旋转位置编码的 Transformers 带来广泛增益。自预训练总体上对 S4 只有适度帮助,但在最长的 Pathfinder 任务上效果很强。
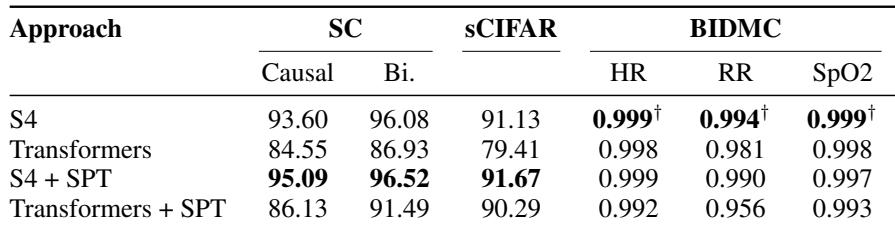
在 Speech Commands 和 sequential CIFAR 上,SPT 为 Transformers 带来很大改进,并为 S4 带来较小增益。该方法还缩小了从头训练的 Transformers 与 S4 之间的差距,并降低了语音任务上因果 S4 与双向 S4 的差异。在 BIDMC 回归任务上,所有模型已接近性能上限,因此 SPT 的收益难以观察。SPT 在 Speech Commands 和 sequential CIFAR 上为 Transformers 带来很大增益。SPT 适度提升 S4,并缩小 Transformers 与 S4 的性能差距。两类模型在 BIDMC 上的得分都非常高,限制了可见的 SPT 改进。
实验在 Long Range Arena、序列建模、Speech Commands、sequential CIFAR 和 BIDMC 上评估微调前的任务专属自预训练,比较随机初始化的 Transformers、S4 变体以及文本预训练模型。结果表明,在目标任务数据上进行预训练会显著增强 Transformers,并使学习到的先验成为可靠评估的核心,同时因果目标与掩码目标表现相似。自预训练还缩小了 Transformers 与更强结构化序列模型之间的差距,为 S4 带来适度或依任务而定的增益,并优于基于文本的预训练,而接近性能上限的 BIDMC 结果限制了可见改进。