Command Palette
Search for a command to run...
摊销大语言模型中难解的推断
摊销大语言模型中难解的推断
Edward J. Hu Moksh Jain Eric Elmoznino Younesse Kaddar Guillaume Lajoie Yoshua Bengio Esmeralda S. Whitammer
摘要
自回归大语言模型(LLM)通过下一词元条件分布压缩其训练数据中的知识。这将可解的知识查询限制为从头到尾的自回归采样。然而,许多感兴趣的任務——包括序列续写、填充以及其他形式的受限生成——涉及从难解的后验分布中采样。我们通过使用摊销贝叶斯推断从这些难解的后验分布中采样来克服这一限制。这种摊销在算法层面通过多样性导向的强化学习算法——生成流网络(GFlowNet)——对 LLM 进行微调来实现。我们通过实验证明,这种分布匹配的 LLM 微调范式可以作为最大似然训练和奖励最大化策略优化的有效替代方案。作为一个重要应用,我们将思维链推理解释为潜变量建模问题,并证明我们的方法能够以数据高效的方式使 LLM 适应需要多步推理和工具使用的任務。
一句话总结
来自 Mila 魁北克人工智能研究所、蒙特利尔大学和牛津大学的研究人员使用生成式流网络(GFlowNets)对 LLM 进行微调,以实现摊销贝叶斯推断,使难以直接采样的后验变为可处理采样,从而作为最大似然训练和奖励最大化训练的一种数据高效分布匹配替代方案,并应用于思维链推理和工具使用。
核心贡献
-
一种贝叶斯推断形式将查询自回归 LLM 进行序列续写、填空和受约束生成建模为从潜在序列或输出的难处理后验分布中采样。
-
GFlowNet 微调使用寻求多样性的强化学习和流匹配目标来训练 LLM,使其从目标后验分布中采样,而不是仅最大化似然或选择高奖励输出。
-
实验表明,GFlowNet 微调在文本生成中带来更好的保真度与多样性权衡,相比最大似然训练或奖励最大化策略优化提高了样本效率和下游泛化,并通过将推理链视为潜在变量,实现了面向思维链推理和工具使用的高效数据自适应。
引言
自回归 LLM 编码了广泛的世界知识,但许多有用应用需要对潜在续写进行推断,例如填空、受约束生成、长度或词汇约束,以及寻找可能的序列续写。这些任务可以被建模为从难处理的后验分布中采样,包括思维链推理中的潜在推理链,其中目标后验仅知道到一个未归一化似然。已有方法存在局限:提示不能准确采样后验,MCMC 可能较慢且对提议分布敏感,奖励最大化的强化学习倾向于坍缩到高奖励模式,而不是覆盖整个分布。作者利用 GFlowNet 微调将语言模型训练为针对这些 LLM 后验的摊销采样器,显示在保真度与多样性权衡、样本效率、分布外泛化方面有所改进,并在推理、填空、算术和工具使用中取得经验收益。
方法
作者将若干有挑战性的语言建模任务重新表述为在自回归大语言模型下从难处理的分布中采样。标准自回归模型将序列分解为
p(w1:N)=p(w1)p(w2∣w1)⋯p(wN∣w1:N−1),这使得基于前缀条件的生成变得可处理。然而,许多有用任务需要从全局条件分布中采样,例如低温度续写、在给定前文和后文时生成填空序列、以答案为条件的反向生成,或如下形式的受约束生成问题
q(Z)∝pLM(Z)c(Z).这些分布需要对所有可能的潜在 token 序列进行归一化,因此直接从它们采样通常难以处理。该方法不依赖逐 token 温度调节、束搜索或手工提示工程,而是学习一个能够从这些目标分布生成样本的摊销采样器。
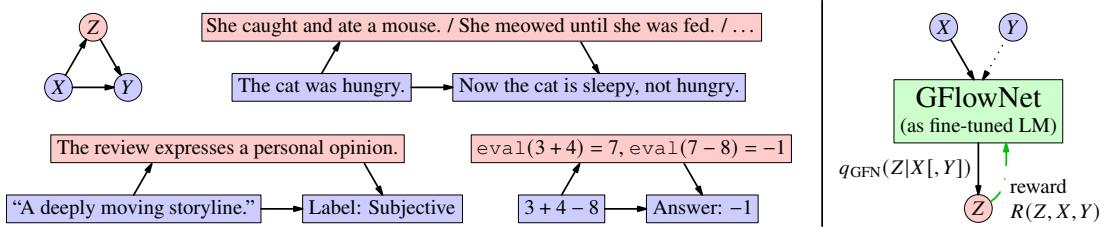
该方法围绕一种潜在变量视角下的推理构建。对于给定的输入上下文 X 和期望输出 Y,潜在序列 Z 表示中间推理、填空、解释或理由。目标后验为
pLM(Z∣X,Y)=∑Z′pLM(XZ′Y)pLM(XZY)∝pLM(XZY).其中,pLM(XZY) 是预训练语言模型赋给拼接序列 XZY 的未归一化联合似然。从该后验采样对应于寻找合理的潜在链,使得在给定输入 X 时,期望输出 Y 更可能。
整体框架如下图所示:
该采样器被实现为一个生成式流网络。GFlowNet 策略被参数化为一个自回归语言模型,并逐个 token 生成 Z。从空字符串开始,它采样
zi∼qGFN(zi∣conditioning context,z1:i−1)直到发出终止停止符号。因此,一个已完成潜在序列的边际概率是 token 级策略概率与终止概率的乘积:
qGFN⊤(Z)=i=1∏nqGFN(zi∣z1:i−1)qGFN(⊤∣z1:n).训练目标是拟合策略,使该边际似然与某个奖励成正比:
qGFN⊤(Z)∝R(Z).对于后验采样,奖励被设置为完整拼接序列的语言模型似然:
R(Z)=pLM(XZY),或者,当涉及约束、惩罚或外部评估时,设置为等价的特定任务分数。
为了训练这个摊销采样器,作者使用一个修改后的子轨迹平衡目标,该目标考虑到序列可以在不同中间状态终止这一事实。对于已完成序列 Z=z1:n⊤,目标为
L(Z;θ)=0≤i<j≤n∑(logR(z1:j⊤)qGFN(⊤∣z1:i)R(z1:i⊤)∏k=i+1jqGFN(zk∣z1:k−1)qGFN(⊤∣z1:j))2.该目标在所有子轨迹之间强制奖励、延续概率和终止概率保持一致。收敛时,当该目标可被最小化为零,策略将按照终止状态的奖励比例进行采样。
训练流程使用轨迹混合,以改善在组合巨大的 token 序列空间中的探索。每个批次由当前 GFlowNet 策略生成的样本、该策略经过温度调节后的版本生成的样本,以及存储在重放缓冲区中的历史轨迹组成。这种混合很重要,因为后验采样需要在指数级庞大的可能集合中发现高似然潜在序列。
条件设定取决于任务。当潜在序列用于泛化时,例如思维链推理或分类,GFlowNet 策略仅以输入 X 为条件。它被初始化为预训练语言模型的副本,然后使用 GFlowNet 目标进行微调。在推理时,从 qGFN(Z∣X) 中抽取潜在序列 Z,然后从 pLM(Y∣XZ) 中采样输出,这相当于对潜在推理链求平均。当目标输出 Y 已知且目标是采样潜在序列本身时,例如填空或反向生成,GFlowNet 策略以 X 和 Y 同时为条件,通常通过包含这两种上下文的提示来实现。在这种设定下,策略直接从后验 pLM(Z∣X,Y) 采样。
同一后验采样器还可支持变分期望最大化风格的训练循环。在期望步骤中,潜在序列 Z 从摊销后的 GFlowNet 后验中抽取。在最大化步骤中,可以更新原始语言模型,以提高所构造联合序列 XZY 的似然。因此,该框架将关于难处理潜在变量的摊销推断与语言模型微调结合起来,使模型能够在期望的目标分布下学习采样合理的推理链、填空结果或其他潜在结构。
实验
实验在文本生成和推理任务上评估 GFlowNet 微调,包括句子续写、故事填空、低数据主观性分类和逐步算术问题求解。在这些设置中,该方法表明匹配语言模型后验可以产生高质量样本、更连贯的生成文本,以及比标准提示或微调基线更强的性能。具体而言,它提高了续写生成中的多样性和似然,为分类支持潜在理由搜索,并在工具辅助推理中比奖励优化方法泛化更稳健。
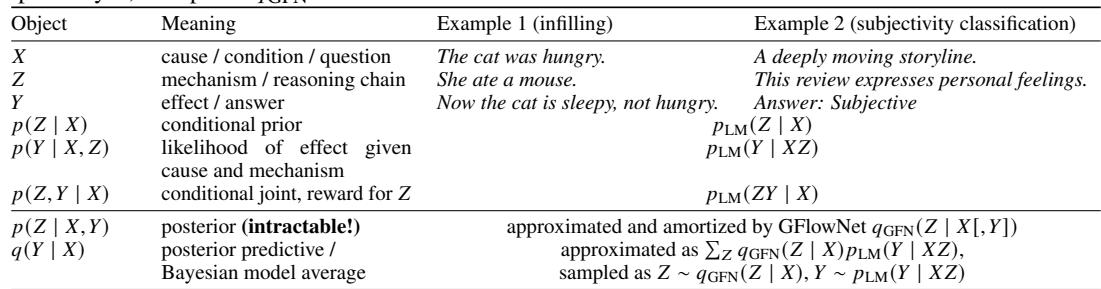
该表格将若干语言模型采样任务表述为在问题或上下文以及结果或答案条件下对机制变量进行推断。它将预训练语言模型视为提供未归一化分数,同时训练 GFlowNet 以近似并摊销否则难以处理的条件后验。算术实验支持这一观点,因为使用 GFlowNet 微调匹配完整目标分布比提示、监督微调和 PPO 产生更可靠的工具使用推理。给定前缀和目标续写,推理链或机制上的后验是难处理的,因此需要摊销采样。温度调节采样、填空、反向生成和受约束生成可以视为从语言模型条件分布或受约束分布中采样。在算术工具使用中,GFlowNet 微调通过避免坍缩到虚假的高奖励理由,比提示、监督微调和 PPO 具有更好的泛化能力。
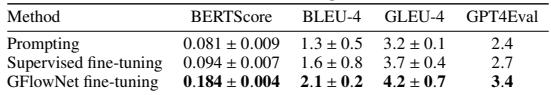
在自动指标和 GPT-4 评判下,GFlowNet 微调产生的故事填空比提示或监督微调更接近参考填空。这种改进表明,同时以开头和结尾为条件的采样有助于模型创建更连贯的故事中间部分,包括转折点。在所比较的方法中,GFlowNet 微调在 BERTScore、BLEU-4、GLEU-4 和 GPT-4 评估得分上均最高。它在所有报告的评估指标上都优于提示和监督微调。这些增益符合生成连接给定开头和结尾的第四句这一任务目标。
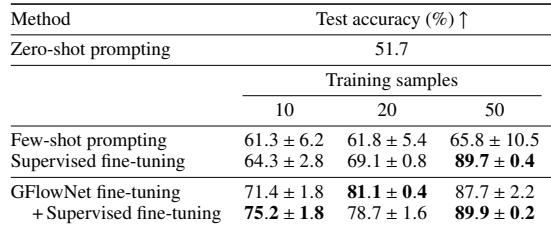
在 SUBJ 上,零样本提示的性能接近随机,而少样本提示只带来有限提升。相比提示,GFlowNet 微调带来大幅提升,尤其是在仅有少量有标签样本时可用。在 GFlowNet 微调基础上加入监督微调获得最强的整体测试准确率。GFlowNet 微调大幅优于零样本和少样本提示。GFlowNet 微调在低数据设定下最具优势。将 GFlowNet 微调与监督微调结合达到报告中的最佳准确率。
结果显示,零样本思维链提示在整数算术上较弱,而添加上下文示例会随着示例数量增加而提高准确率。监督微调在训练长度表达式上的增益大于在更长的分布外表达式上的增益,而 PPO 微调表现不佳,因为其奖励模型无法可靠区分有效推理与虚假输出。据报告,GFlowNet 微调对奖励误设更鲁棒,并且在分布内和分布外样本上都更强。上下文示例始终比零样本提示提高算术准确率。相比分布内表达式,监督微调对更长表达式的泛化能力较差。PPO 受到奖励校准不佳的影响,并可能产生高奖励但无效的工具使用序列。GFlowNet 避免了奖励模式坍缩,并在分布内和分布外都获得更强性能。
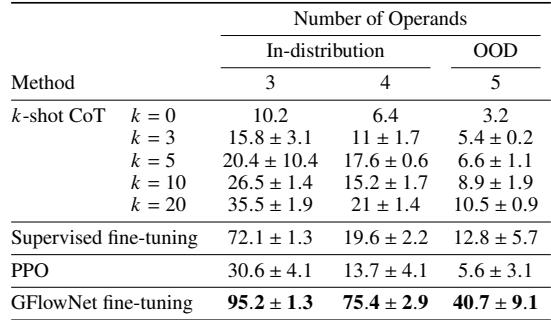
实验在算术工具使用、故事填空和主观文本分类上评估 GFlowNet 微调,并将其与提示、监督微调和 PPO 进行比较。结果表明,GFlowNet 能更有效地从难处理的条件分布中采样,产生更连贯的填空结果,提升低数据性能,并更可靠地处理受约束推理。总体而言,这些发现表明,摊销后验采样减少对虚假奖励信号的依赖,并带来更强的泛化,尤其是在较小数据设定下与监督微调结合时。