Command Palette
Search for a command to run...
证明黑盒语言模型中的测试集污染
证明黑盒语言模型中的测试集污染
Yonatan Oren Nicole Meister Niladri Chatterji Faisal Ladhak Tatsunori B. Hashimoto
摘要
大语言模型在海量互联网数据上训练,引发了其是否记忆了公开基准的担忧与猜测。然而,从猜测走向污染的严格证明极具挑战性,因为专有模型使用的预训练数据通常不公开可获取。我们证明,无需访问预训练数据或模型权重,即可为语言模型中的测试集污染提供可证明的保证。我们的方法基于以下事实:当不存在数据污染时,可交换基准的所有排列顺序应当具有相等的概率。相比之下,语言模型倾向于记忆样本顺序,这意味着被污染的语言模型会将某些规范排序视为远比其他排序更可能出现。当规范排序的基准数据集的似然值显著高于打乱样本顺序后的似然值时,我们的检测方法即标记潜在污染。我们证明了该程序具有足够的灵敏度,能够在具有挑战性的场景中可靠地证明测试集污染,包括参数量仅为 14 亿的模型、仅含 1000 个样本的小规模测试集,以及仅在预训练语料中出现少量次数的数据集。利用我们的检测方法,我们对四个流行的公开可访问语言模型进行了测试集污染审计,发现普遍污染的证据很少。
一句话总结
斯坦福大学与哥伦比亚大学提出一种方法,通过比较规范排序基准与打乱排序的似然,可证明地检测黑盒语言模型中的测试集污染,利用记忆倾向使特定排序具有不成比例的高似然,并使用该测试审计四个流行模型,检测灵敏度可低至 14 亿参数和 1000 个样本的规模。
核心贡献
-
论文引入一种黑盒统计测试,用于检测基准污染,仅使用对数概率,并利用干净语言模型不应强烈偏好基准原始示例顺序这一事实。当规范排序测试集的似然显著高于打乱排序时,该测试会标记可能的污染,而不需要访问预训练数据或模型权重。
-
论文开发分片测试,从基准示例的可交换性构造精确零分布,提供假阳性保证,并提高检测精度和灵敏度。金丝雀实验显示,即使在具有挑战性的场景中也能检测污染,包括 14 亿参数模型、1000 个示例的测试集,以及仅在训练语料中出现若干次的数据集。
-
论文将该审计应用于四个公开可访问语言模型,发现几乎没有普遍测试集污染的证据。该审计展示了仅使用对数概率的第三方测试。
引言
大语言模型通常在广泛网络数据上训练,这些数据可能意外包含评测基准,使得难以判断高分是反映真实泛化还是记忆测试示例。以往污染审计常依赖提供方披露、定向过滤、n-gram 重叠、提示词或启发式对数概率信号,这些方法可能不可靠、局限于已知基准,或无法提供强统计证据。作者利用数据集可交换性并仅使用模型对数概率查询,构建黑盒统计测试:如果模型对基准公开排序相比打乱排序表现出强烈偏好,则可能表明数据集在训练期间被看过。其主要贡献是具有受控假阳性率的分片假设检验,可证明地识别小规模和部分重复数据集中的基准污染。
方法
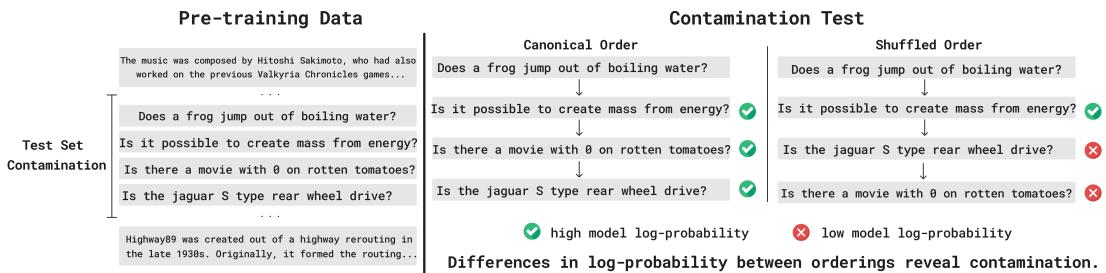
作者利用基于似然的统计框架检测大语言模型中的逐字测试集污染。核心前提是干净数据集在目标模型下不应相对于自身的随机置换版本具有异常高的对数概率。如果模型记忆了规范排序,则预期模型会给原始序列分配明显高于许多打乱变体的对数概率。
该方法可以理解为一系列模块。首先,候选数据集被组装成 token 序列 X。模型 θ 使用其规范排序的对数概率为该序列评分,
logpθ(seq(X)).然后,作者将该量与在同一数据集随机置换下计算得到的对数概率进行比较。零假设是数据集具有可交换性,意味着其排序不携带与模型对数概率相关的信息。在该假设下,原始排序的似然不应系统性地大于置换排序的似然。
直接方法是置换检验。对每个置换 π,作者计算
logpθ(seq(Xπ)).然后估计规范排序的对数概率低于随机置换版本的概率:
p:=E[1{logpθ(seq(X))<logpθ(seq(Xπ))}].因为枚举所有置换不可行,该期望被使用 m 个采样置换的蒙特卡洛估计替代。由此得到的 p 值估计量为
p^:=m+1∑i=1m1{logpθ(seq(X))<logpθ(seq(Xπi))}+1.当 p^ 小于选定显著性水平 α 时,检验拒绝干净数据的零假设。该公式概念简单,并在标准置换检验理论下给出有限样本有效性。然而,它具有重要计算和统计限制。运行时间随置换数量和序列长度增长,在对数概率评估方面约为 O(m∣X∣)。更重要的是,可达到的最小 p 值受 1/(m+1) 下界限制,对于需要非常严格显著性阈值或多重假设检验校正的应用而言可能过大。
为了提高该测试的实用价值,作者提出分片似然比较过程。该测试不询问规范排序是否具有高于几乎所有置换排序的似然,而是询问它是否具有高于平均置换排序的似然。这是一个更弱但更易实践的条件。它不要求原始排序占据置换分布的极端尾部。相反,它只要求模型平均而言一致地偏好规范排序,而不是随机打乱版本。
分片方法首先将数据集中的示例划分为连续分片。如果数据集包含 X1,…,Xn,作者将相邻示例分组成分片,例如
S1=(X1,X2,…,Xk),其中每个分片在总共 r 个分片中包含至少 k=n/r 个示例。这些分片被设计为统计聚合的独立单元。关键思想是在分片内应用随机置换,而在原始排序与平均置换排序的蒙特卡洛估计之间进行比较。
对每个分片,该方法计算似然比较统计量:
si:=logpθ(seq(X))−Meanπ(logpθ(seq(Xπ))).这里,Meanπ 表示在多个随机置换上的平均对数概率。si 的正值表明模型给规范排序分配的对数概率高于打乱变体,这是反对零假设的证据。
然后在所有分片上使用均值聚合分片统计量,
s=r1i=1∑rsi.最后,作者使用单边 t 检验测试 s 是否与零均值量一致。如果检验强烈拒绝 s 为零的零假设,该方法得出结论:模型似乎给原始数据集排序分配异常高的似然,这可能表明污染。
这个分片似然比较检验保留置换检验的核心直觉,同时改变统计机制。它将单个基于秩的比较转化为一系列基于均值的比较,然后聚合。这种设计降低置换分布尾部的负担。该检验不要求规范对数概率超过几乎每个置换对数概率。它只要求规范排序一致地获得比平均置换排序更高的对数概率。
从计算角度看,当使用 m 个置换时,分片方法仍然需要 O(m∣X∣) 次对数概率评估。然而,由此产生的 p 值不受限制朴素置换检验的相同有限样本下界约束。在实践中,分片检验产生的 p 值可以衰减得快得多,使该方法在研究者需要很小显著性值或采用严格评估协议时更有用。
作者还为分片检验提供假阳性保证。在零假设下,假设数据集是 i.i.d. 且相关对数概率具有有限二阶矩,聚合统计量预期表现得像零均值随机变量。因为示例被划分到不相交分片,分片级统计量是独立的。根据中心极限定理,聚合统计量收敛到高斯分布,使单边 t 检验能够产生渐近有效的 p 值。这为该方法在干净数据假设下提供正式校准属性,尽管该保证是渐近而非有限样本。
实验
实验首先在已知基准示例以不同重复率插入而训练的模型上验证污染测试,表明该方法可高效检测大量重复,并能识别少量污染,同时分片和置换选择保持稳健。消融实验表明检测随适度分片和更多置换而改善,超过适度置换数量后收益递减。当应用于公开模型和基准时,该流程通常未发现普遍逐字污染,除一个模型与基准组合中的边缘迹象外;在处理非可交换性后,它对 MMLU 给出轻微的启发式污染证据。
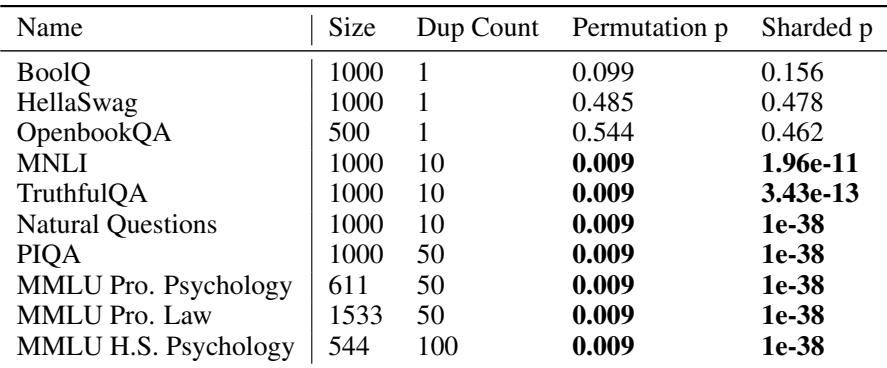
用少量注入基准子集训练 14 亿语言模型表明,当测试集在预训练中多次出现时,污染测试变得强烈显著。在低重复次数下,置换和分片似然 p 值通常不显著,但一旦重复达到十次或更多,检测变得非常清晰。结果提示该测试可以在现实模型和数据集规模中识别适度污染。检测强度随重复次数急剧上升。约 1000 个示例的小型注入集在十次或更多重复时产生显著 p 值。单副本注入不提供可靠污染信号。
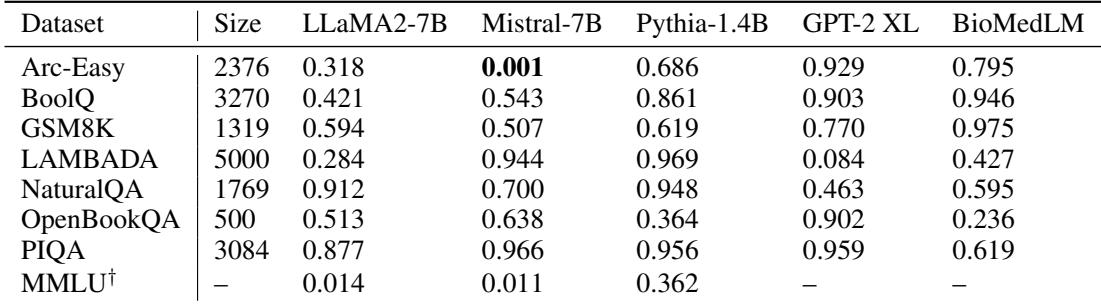
污染测试显示,在所评估开放模型和公开基准中 p 值大多不显著,没有强烈证据表明普遍测试集污染。Mistral 在 ARC 上得到较低 p 值结果,但作者指出其接近统计显著性边界,应谨慎解释。对于 MMLU,过滤并聚合后的结果对 LLaMA2 和 Mistral 产生小 p 值,与轻度污染的报告一致。所评估模型和基准的大部分 p 值不显著。BioMedLM 负控制也产生不显著值,提示被测试基准没有广泛触发假阳性。过滤后的 MMLU 测试提示 LLaMA2 和 Mistral 可能存在轻度污染。
实验首先通过将基准示例注入 14 亿模型验证污染检测,显示信号仅在大量重复后急剧出现,而单副本仍不可靠。在公开开放模型和基准上,测试大多给出非显著结果,表明没有广泛测试集泄漏,尽管观察到 MMLU 在 LLaMA2 和 Mistral 上可能存在轻度污染,并注意到 ARC 的边界情况。BioMedLM 上的负控制支持该方法不会广泛产生假阳性。