Command Palette
Search for a command to run...
迈向弱监督下数据选择的统计理论
迈向弱监督下数据选择的统计理论
Germain Kolossov Andrea Montanari Pulkit Tandon
摘要
给定一个样本量为 N 的样本,从中选取大小为 n < N 的子样本用于统计估计或学习通常十分有用。这种数据选择步骤有助于降低数据标注需求和学习的计算复杂度。假设给定 N 个未标注样本 {x_i}{i ≤ N},并可访问一个'替代模型',该模型预测标签 y_i 的能力优于随机猜测。我们的目标是选出一个样本子集,记为 {x_i}{i ∈ G},其大小满足 |G| = n < N。随后为该子集获取标签,并通过正则化经验风险最小化训练模型。通过在真实数据与合成数据上的数值实验以及低维与高维渐近情形下的数学推导相结合,我们证明了:(i) 数据选择可以非常有效,在某些情况下甚至优于在完整样本上训练;(ii) 某些流行的数据选择方法(如无偏重加权重采样或基于影响函数的重采样)可能显著次优。
一句话总结
Granica Computing, Inc. 的研究人员开发了一种弱监督下数据选择的统计理论,表明通过代理模型从 N 个未标注样本中选择一个大小为 n<N 的子集,并使用正则化经验风险最小化进行训练,可以优于全样本训练,同时显示诸如无偏重加权子采样或基于影响函数的子采样等流行策略可能严重次优。
核心贡献
-
一项关于使用代理模型从未标注样本中选择已标注子集的理论和经验分析表明,数据选择可以优于全样本训练,并且小至 0.4 的数据子集也能产生更低的测试误差。
-
对于凸 M 估计量,低维和高维渐近分析确立了无偏重加权子采样和基于影响函数的选择可能明显次优,而有偏选择可以改善期望风险的曲率,并且最优概率非平凡地依赖于子采样比例 n/N。
-
该分析确定基于不确定性的子采样是一种有效的实际规则,并表明更好的代理模型并不总能改进插件式选择。真实数据和合成实验进一步表明,最优选择可能偏向困难样本或简单样本,具体取决于低维或高维情形。
引言
标注工作耗费人力,而基于数据选择的学习通过从一个固定的未标注样本池中选择一小部分有信息量的样本,对其进行标注,然后通过加权经验风险最小化进行训练,从而应对这一成本。这一设定对于基于样本池的主动学习很重要,因为目标是在标签数量少得多的情况下保持接近全样本的准确率。先前的方法,例如贝叶斯不确定性采样、梯度或损失启发式方法、杠杆分数、影响函数和基于间隔的选择,通常依赖于特定假设、问题表述或小的子采样情形,并且许多理论处理会强制要求无偏权重与选择概率的倒数成正比。这些限制会使选择变得次优,特别是在保留样本是数据的固定比例,并且每个点的效用取决于目标选择率时。作者利用低维和高维渐近下有偏和无偏加权 ERM 的统一分析,表明比例感知、基于代理模型的选择规则可以超越标准无偏方案,不确定性可以指导有效选择,并且良好的子采样有时可以优于全样本训练。
方法
所提出的方法是一个免标注的选择性经验风险最小化框架。其核心设计是将昂贵的标注和完整训练过程分离为轻量级代理预测阶段、数据评分与子采样阶段,以及最终缩减数据训练阶段。给定一个大的未标注样本池 x1,…,xN,该方法假设可以访问代理概率核 Psu(dy∣x)。代理模型可以近似标签的真实条件分布,也可以是较弱预测模型。最终模型在大小为 n<N 的子集上训练,该子集仅使用特征向量和代理输出进行选择,不使用真实标签。
选择过程通过随机变量 Si(xi)≥0 编码,这些变量依赖于 xi、代理预测 Psu(⋅∣xi) 以及样本间的独立随机性。最终估计量最小化选择性加权经验风险
R^N(θ)=N1i=1∑NSi(xi)L(θ;yi,xi)+λΩ(θ),L(θ;y,x):=ℓ(y,f(x;θ)).这里 λΩ(θ) 是正则项。子采样预算在期望意义下通过下式满足
n=i=1∑NEπ(xi),π(xi):=P(Si(xi)>0∣X,y).一个核心设计选择是选择方案是否无偏。无偏方案满足
E{S(x)∣X,y}=1.在这种情况下,权重补偿采样概率,实际上保留期望风险。在经典固定维数情形中,最优无偏方案由条件影响函数类分数确定。定义条件梯度协方差和 Hessian
G(x):=E{∇θL(θ∗;y,x)∇θL(θ∗;y,x)⊤∣x}, H(x):=E{∇θ2L(θ∗;y,x)∣x}.最优无偏采样概率具有如下形式
πunb(x)=min(1,c(γ)Z(x)1/2),其中
Z(x):=Tr(G(x)H−1QH−1).常数 c(γ) 强制满足目标子采样比例 γ=n/N。等价地,在代理预测下,算法会选择在代理下期望平方影响较大的样本。对于广义线性模型,该分数简化为一个自然几何分数,涉及模型曲率和代理条件不确定性。例如在线性回归中,该分数正比于总体杠杆分数。
该方法进一步研究有偏非重加权方案,这类方案在实践中更简单,因为被选中的样本以权重 1 使用。在这种设计中,选择规则仅由概率 π(x) 定义,因此
S(x)={1,0,with probability π(x),otherwise.这避免修改训练目标,因此可以直接集成到标准机器学习流程中。然而,由于不应用重加权,有效 Hessian 和梯度协方差不再是总体完整分布下的那些量。相反,它们在被选中分布下计算:
Gπ:=EπG(x),Hπ:=EπH(x),其中 Eπ 表示在 π 诱导的分布下的期望。最优有偏选择规则使用阈值分数
Z(x;π):=−Tr{G(x)Hπ−1QHπ−1}+2Tr{H(x)Hπ−1QHπ−1GπHπ−1}.在满足目标样本量的前提下,最优非重加权概率选择 Z(x;π) 较大的样本。这产生一个基于困难或有信息量样本的贪婪选择规则,但分数本身与最终被选中的分布耦合。因此,最优子集非平凡地依赖于目标比例 γ,并且选择最不确定或分数最高的样本并不总是最佳策略。
相同原理被扩展到高维设置,其中特征维数 p、样本池大小 N 和子集大小 n 同时趋于无穷。对于响应依赖于一维投影 ⟨θ0,x⟩ 的广义线性模型,代理模型由两个量概括:与真实投影方向的对齐程度以及正交误差分量的范数。渐近测试误差由一个鞍点问题刻画,该问题涉及损失函数、选择规则以及依赖代理模型的统计量。这使得比较强调困难样本、不确定样本或更平衡不确定性分数的选择规则成为可能,并且不需要真实标签的准确知识。
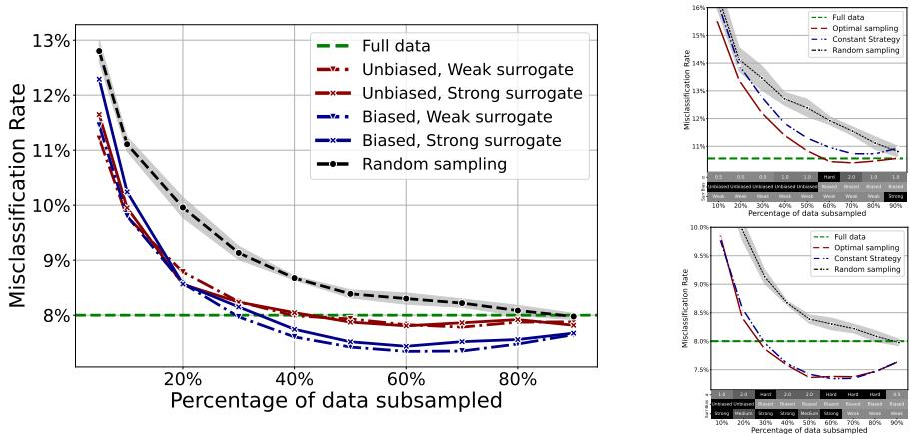
该框架的实际结果是,数据选择并不仅是计算上的捷径。作者证明,相对于在全数据集上训练,选择一个更小、更具信息量的子集可以提高最终精度。这之所以可能,是因为有偏选择可以改变期望风险的有效曲率。无偏选择保留原始总体曲率,而有偏选择可以偏好特征空间中能够提高统计效率的区域。因此,该方法被设计为代理模型驱动的过滤工作流:首先训练一个小的弱或强代理模型,在未标注样本池上计算条件预测或不确定性分数,根据有偏或无偏评分规则选择子集,并使用正则化经验风险最小化在被选中子集上训练最终模型。
方法的实证表现反映了其设计。弱代理模型仍可以产生有效的选择规则,有偏选择可以优于无偏重加权,并且被选中子集可以得到比使用所有可用样本更低的测试误差。如下图所示:
在所描述的设置中,该流程使用图像嵌入和简单最终分类器。评分模块可以通过指数参数强调困难样本,而训练模块优化岭正则损失。该比较说明,最终模型的质量不仅取决于使用的数据量,还取决于代理模型强度、选择偏差、正则化和目标子采样比例之间的交互作用。
实验
评估结合了低维和高维理论渐近、合成模拟以及一个真实数据自动驾驶汽车分类任务,并测试面向逻辑回归的基于不确定性的单参数子采样。实验验证了渐近预测,表明有偏子采样可以比无偏方案更准确,并且样本效用取决于采样比例,而非仅取决于代理模型质量。在不同设置中,即使比例很小,不确定性驱动的选择常常接近或超过全样本性能,尽管对简单样本或困难样本的最优偏差会随维度、模型误设和预算而变化。