Command Palette
Search for a command to run...
扩散模型的泛化能力源于几何自适应调和表示
扩散模型的泛化能力源于几何自适应调和表示
Zahra Kadkhodaie Florentin Guth Eero P. Simoncelli Stéphane Mallat
摘要
为图像去噪任务训练的深度神经网络(DNN)能够利用基于分数函数的反向扩散算法生成高质量样本。这些令人瞩目的能力似乎表明深度神经网络已摆脱了维度灾难的困扰,但近期关于模型记忆训练集的报告引发了一个关键问题:这些网络是否真正学习了数据的连续密度函数?本文证明,当训练图像数量足够大时,在数据集不相交子集上训练的两个 DNN 会学习到几乎相同的分数函数,从而得到相同的密度。在这种强泛化状态下,扩散生成的图像与训练集不同且具有较高的视觉质量,表明 DNN 的归纳偏置与数据密度高度契合。我们对学习到的去噪函数进行分析,发现归纳偏置导致在适应底层图像的基上执行收缩操作。对这些基的检查表明,其沿轮廓和均匀区域呈现振荡的调和结构。我们证明,训练后的去噪器在归纳偏置上倾向于这些几何自适应调和基,因为不仅在照片图像上训练时会出现这种结构,而且当网络训练于低维流形支撑的图像类别(此时调和基并非最优)上时同样会出现。最后,我们证明,当在已知最优基为几何自适应调和基的规则图像类别上训练时,网络的去噪性能接近最优。
一句话总结
纽约大学、Flatiron Institute 和 Collège de France 的研究人员证明,扩散模型的泛化源于 DNN 去噪器学习到几何自适应谐波基,表明在互不相交子集上训练的网络会收敛到相同的分数函数,并且这种归纳偏置在规则图像类别上产生近乎最优的去噪效果。
核心贡献
-
论文表明,扩散模型训练呈现相变现象:在大规模、互不重叠子集上训练的两个 DNN 会学到几乎相同的分数函数,因此也学到几乎相同的密度;与此同时,扩散生成的样本仍不同于训练集,并保持较高的视觉质量。
-
对训练后的去噪器进行分析揭示了这样一种归纳偏置:它在适应图像轮廓和均匀区域的几何自适应谐波基中对含噪系数进行收缩。这种基既出现在照片图像中,也出现在支撑于低维流形上的图像类别中,表明它是学习到的去噪器所固有的。
-
在已知最优基的图像类别上的评估表明,当最优基是几何自适应且谐波时,例如具有类似 bandlet 基的 C^alpha 图像,去噪性能接近最优;而支撑于流形上的类别则在额外的 GAHB 分量上表现出次优的残余噪声。这种对比支持如下假设:DNN 去噪器的 GAHB 归纳偏置同时解释了强性能与有限性能。
引言
扩散生成模型使用深度神经网络去噪器估计含噪图像分布的分数,并通过反向扩散生成新样本,因此它们是高质量图像生成的核心。关键挑战在于,在高维空间中学习连续密度十分困难,已有结果表明,当训练集相对于模型容量较小时,这些模型会记住训练样本而非泛化。论文表明,在足够大的数据集下,DNN 去噪器会在互不重叠的训练集上收敛到几乎相同的去噪函数,并生成几乎相同的图像,从而为强泛化提供直接证据。论文还利用去噪与密度估计之间的联系,揭示了一种几何自适应谐波基归纳偏置,其中去噪器在适应图像几何的基中对含噪系数进行收缩。
方法
该工作利用一种基于分数的生成流程,其中模型不直接近似干净图像密度。相反,它学习被噪声污染的图像分布的分数。从未知的干净密度 p(x) 出发,该方法观察含噪图像
y=x+z,z∼N(0,σ2Id),因此含噪密度是干净密度的高斯卷积,
pσ(y)=∫p(y∣x)p(x)dx=∫gσ(y−x)p(x)dx.族 {pσ} 构成 p(x) 的尺度空间表示,类似于扩散过程的演化。学习目标是分数模型 sθ(y)≈∇logpσ(y),它在不同噪声水平上给出估计。这些分数定义反向扩散过程,从而为干净数据分布诱导出模型 pθ(x)。生成模型的质量由积分分数误差控制,
DKL(p(x)∥pθ(x))≤∫0∞Ey[∥∇logpσ(y)−sθ(y)∥2]σdσ.为了学习分数,该方法使用恒等式
∇logpσ(y)=σ2Ex[x∣y]−y.这使得分数学习等价于学习一个去噪器 fθ(y),后者近似后验均值 Ex[x∣y]。训练目标是均方误差
MSE(fθ,σ2)=Ex,y[∥x−fθ(y)∥2],估计分数通过去噪器输出恢复为
sθ(y)=σ2fθ(y)−y.由此得到的密度近似满足以下界
DKL(p(x)∥pθ(x))≤∫0∞(MSE(fθ,σ2)−MSE(f⋆,σ2))σ−3dσ,其中 f⋆(y)=Ex[x∣y] 是最优去噪器。这表明生成建模精度由所有噪声水平上的去噪最优性决定。
训练流程通过比较训练集规模增大时训练样本和测试样本上的去噪性能来分析。下图展示了多个训练集大小下输出 PSNR 与输入 PSNR 的关系。对于非常小的数据集,模型会记住训练样本,导致训练性能高而测试性能差。随着数据集规模增加,测试性能提升并最终与训练性能一致,表明去噪器进入泛化阶段而非记忆阶段。
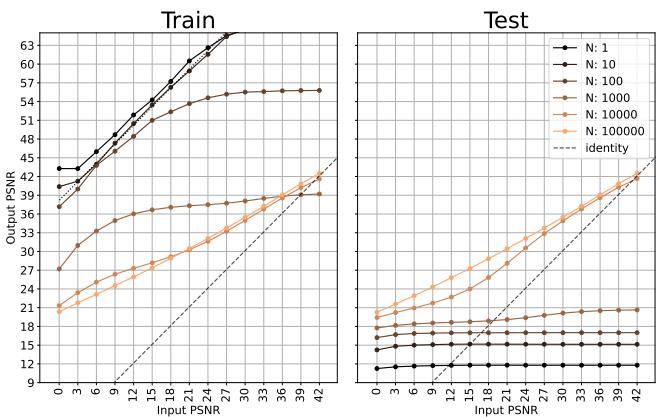
这种泛化行为是框架的核心,因为若没有强归纳偏置,高维密度估计在一般情况下无法进行。学习到的去噪器,例如 UNet,作为核心生成模块。其架构和优化过程限制了能够表示的分数估计。当这些约束与图像结构一致时,去噪器学习到能够良好泛化并产生多样生成样本的分数;当不一致时,模型可能记住有限数据,或者在学习到的密度中引入显著的模型偏差。
该方法随后通过局部雅可比分析检查去噪器的内部结构。给定去噪估计器 x^=f(y),作者研究 ∇f(y)。如果网络没有加性偏置参数,该映射为分段线性,去噪器可通过其雅可比矩阵的特征分解表示为
f(y)=∇f(y)y=k∑λk(y)⟨y,ek(y)⟩ek(y).这里 λk(y) 是特征值,ek(y) 是特征向量。这种表示揭示了方法的核心机制:去噪被解释为在自适应基中的收缩。特征向量定义局部坐标系,而特征值决定保留或抑制多少局部分量。基和收缩因子都依赖于含噪图像 y。
MSE 目标自然地促使这种收缩行为。利用 Stein 无偏风险估计,去噪误差可写为
MSE(f,σ2)=Ey[2σ2tr∇f(y)+∥y−f(y)∥2−σ2d].最小化 MSE 需要在雅可比矩阵的秩(以特征值之和衡量)与残余去噪误差之间取得权衡。因此,去噪器在局部表现为对子空间的软投影,该子空间的维度对应雅可比矩阵的秩。对于最优去噪器,雅可比矩阵具有直接的概率解释:
∇f⋆(y)=Id+σ2∇2logpσ(y)=σ−2Cov[x∣y].因此,最优自适应基与在给定含噪观测下干净图像的后验协方差相关联。最优 MSE 满足
MSE(f⋆,σ2)=σ2Ey[k∑λk⋆(y)],因此,较低的去噪误差对应于近似低秩的雅可比矩阵,并且许多特征值较小。
作者还将这种局部基视角与经典稀疏去噪联系起来。在固定正交归一化基 ek 中,oracle 收缩规则为
λk(x)=⟨x,ek⟩2+σ2⟨x,ek⟩2.这相当于软阈值:信号能量占主导的系数被保留,而弱系数被抑制。如果 x 的系数按 k−(α+1) 衰减,则所得去噪误差按 σ2α/(α+1) 缩放,对应 α/(α+1) 的 PSNR 斜率。该分析将这一思想扩展到从字典中选择的自适应基,其中自适应性能够产生更稀疏的表示和更好的渐近去噪速率。
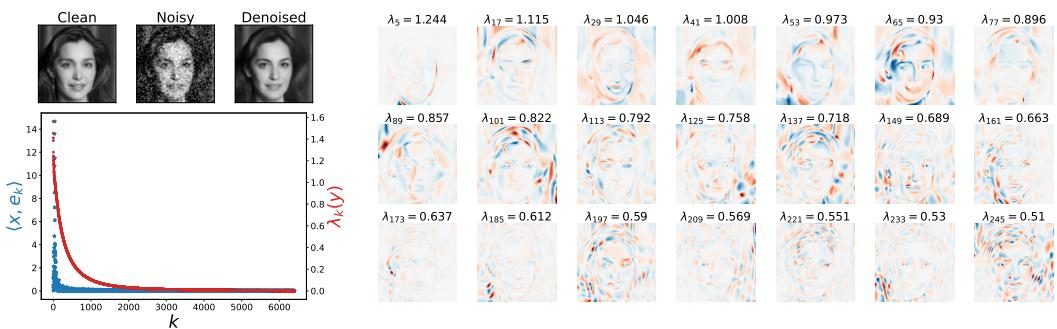
实证设计分析研究学习到的 DNN 去噪器是否表现出这种自适应稀疏行为。对于在人脸图像上训练的去噪器,雅可比特征向量包含与图像轮廓和平滑区域对齐的振荡模式。特征值快速衰减,并且干净图像在该基中的系数是稀疏的。这表明去噪器使用几何自适应谐波基,这是一种适应形状结构和区域平滑性的局部基。
如下图所示,上排比较干净、含噪和去噪图像,下排绘出收缩因子和信号系数的衰减。右侧显示的特征向量呈现谐波式振荡,沿人脸轮廓和更平滑区域分布。它们的频率随收缩因子减小而增加。
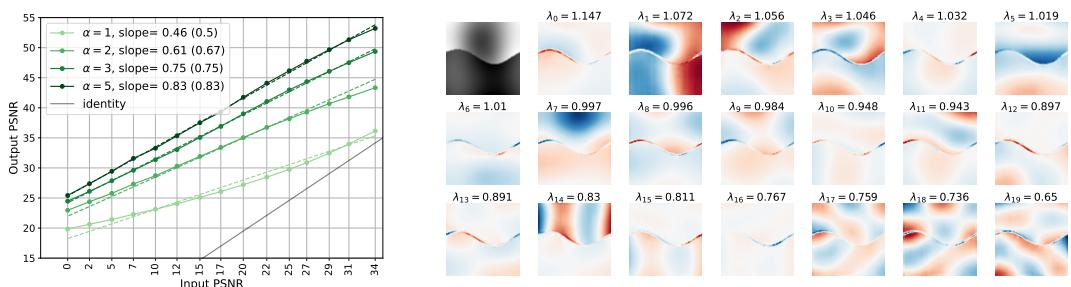
为了评估这种基结构是否反映有利的归纳偏置,作者测试了几何图像类别,其中已知最优稀疏表示。在几何 Cα 设定中,图像在规则背景上包含规则轮廓,规则性由 α 控制。该类别的最优稀疏表示通过 bandlet 基获得,其中系数衰减导致渐近 PSNR 斜率 α/(α+1)。当 UNet 去噪器在这些合成数据上训练时,其 PSNR 曲线逼近不同 α 值对应的理论最优斜率。学习到的特征向量类似 bandlet,在区域内部和边界之间具有谐波结构,但具有更灵活的几何。
下图展示了多个规则性水平的 PSNR 曲线,以及一张 Cα 图像对应的前导特征向量。经验斜率与理论值吻合,并且基向量显示随频率增加而变化的区域式谐波。
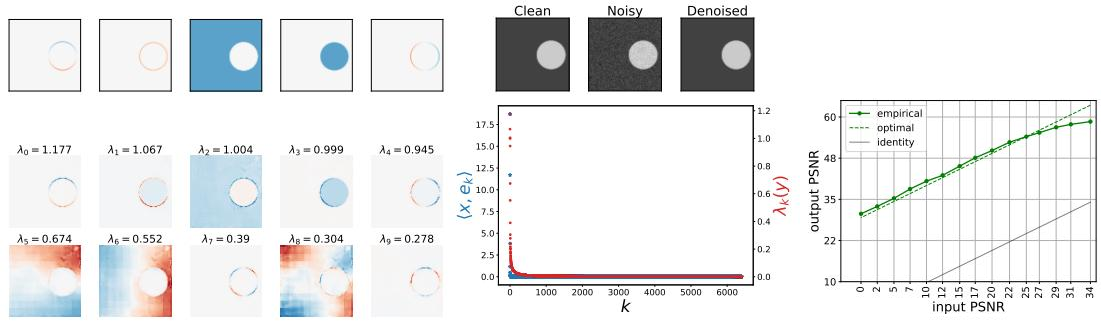
作者还检查数据分布位于低维流形上的情况,例如位置、大小和强度变化的圆盘图像。在小噪声极限下,最优去噪器应投影到局部切空间,只产生少数不可忽略的特征值,并得到 1.0 的 PSNR 斜率。训练后的去噪器确实恢复一些切方向,但也会产生额外的非零特征值,其特征向量具有几何自适应谐波结构。这些额外分量增加雅可比矩阵的有效秩,并导致低于理论最优值的次优 PSNR 斜率。
下图展示了干净、含噪和去噪的圆盘图像,收缩因子与系数的衰减,学习到的基的前导特征向量,以及去噪性能曲线。前导基向量与圆盘流形的切空间紧密对应,而后面的向量遵循轮廓和背景振荡,而非纯粹的低维流形方向。
实验
比较在小到大大图像子集上训练的去噪器的实验验证了从记忆到泛化的转变:小训练集产生训练数据特定的样本和较差的测试性能,而更大的数据集使训练和测试行为一致,并在互不相交子集上产生几乎相同的生成结果,表明收敛到共同的分数函数。额外实验分析学习到的去噪基,并在具有几何结构的合成图像类别上进行测试。结果表明,DNN 去噪器学习到与轮廓对齐的振荡基,这些基符合自然图像的规则性假设,在几何规则的合成数据上实现接近最优的行为;但当数据结构与这些谐波归纳偏置冲突时,其性能变成次优。