Command Palette
Search for a command to run...
Vision Transformer 需要寄存器
Vision Transformer 需要寄存器
Timothee Darcet Maxime Oquab Julien Mairal Piotr Bojanowski
摘要
Transformer 近期已成为学习视觉表征的强大工具。本文识别并刻画了监督式和自监督式 ViT 网络特征图中的伪影现象。这些伪影对应于推理过程中出现的高范数 token,主要出现在图像中低信息量的背景区域,这些 token 被重新用于内部计算。我们提出了一种简单而有效的解决方案,即在 Vision Transformer 的输入序列中提供额外的 token 来承担该角色。实验表明,该方案彻底解决了监督式和自监督式模型中的这一问题,在稠密视觉预测任务上为自监督视觉模型设立了新的最优结果,使更大规模模型的目标发现方法成为可能,更重要的是,生成了更平滑的特征图和注意力图,有利于下游视觉处理。
一句话总结
FAIR (Meta) 与 Univ. Grenoble Alpes/Inria 提出向 Vision Transformer 输入序列添加专门的寄存器 tokens,以吸收损害特征图的高范数伪影,在监督式和自监督式 ViT 中完全消除这些伪影,在密集预测任务上创下新的 state of the art,并使注意力图更平滑,从而改善下游视觉处理。
核心贡献
-
该论文识别并刻画了 Vision Transformer 特征图中的伪影,指出低信息量背景区域中的高范数 outlier tokens 会在推理期间被内部重新利用;该论文还描述了基于 outlier token 范数的简单检测方法。
-
该工作引入用于 Vision Transformer 的寄存器 token 机制,附加不作为输出也不添加信息的输入 tokens,使模型能够存储和取回内部计算,而不是劫持 patch tokens;这会生成更平滑的特征图和注意力图。
-
结果显示,寄存器 token 方法在自监督和监督 ViT 模型中均移除了伪影,提升密集视觉预测和目标发现性能,在密集预测任务上为自监督视觉模型创下新的 state of the art,并可推广到 DINOv2、DeiT-III 和 OpenCLIP 等模型。
引言
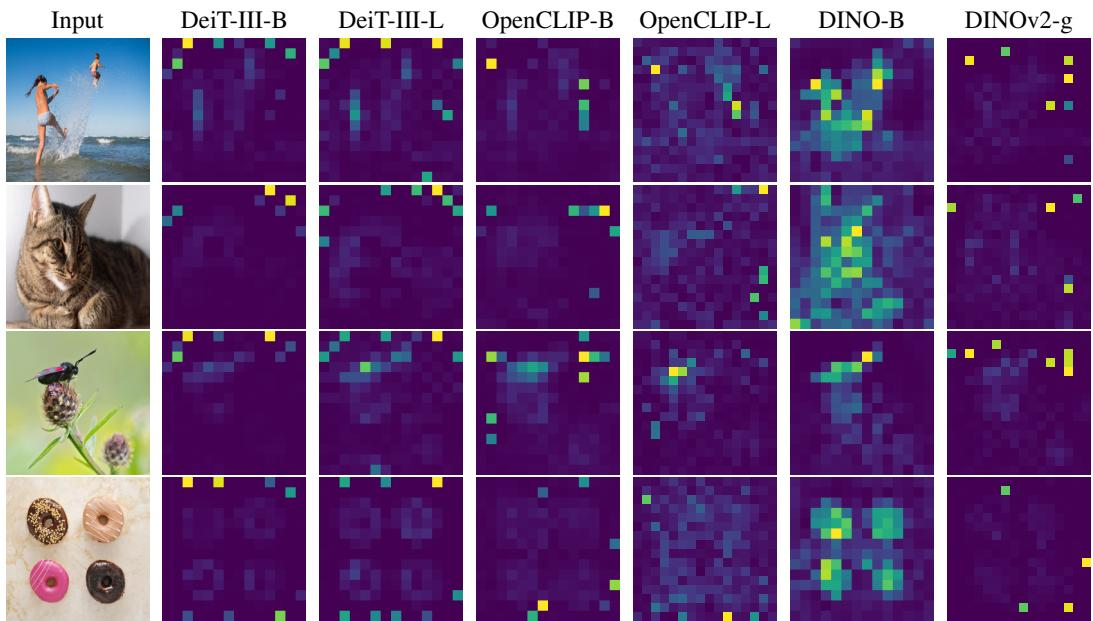
将图像嵌入到可复用的视觉特征中是计算机视觉的核心能力,因为专用领域中的标注数据常常稀缺或昂贵。现代方法通常预训练强模型,例如监督式或自监督式 Transformer,并将其用作下游任务的冻结特征提取器。然而,作者发现强大的现代视觉 Transformer,包括 DINOv2、DeiT-III 和 OpenCLIP,可能产生异常高范数的伪影 tokens,尤其是在更大和训练更久的模型中。这些伪影把全局图像信息集中在局部内容很少的 patch 中,可能损害密集预测和目标发现。作者通过向序列添加额外的寄存器 tokens 解决该问题,给模型提供存储全局信息的专门位置,并把伪影从 patch 特征中移除。
数据集
-
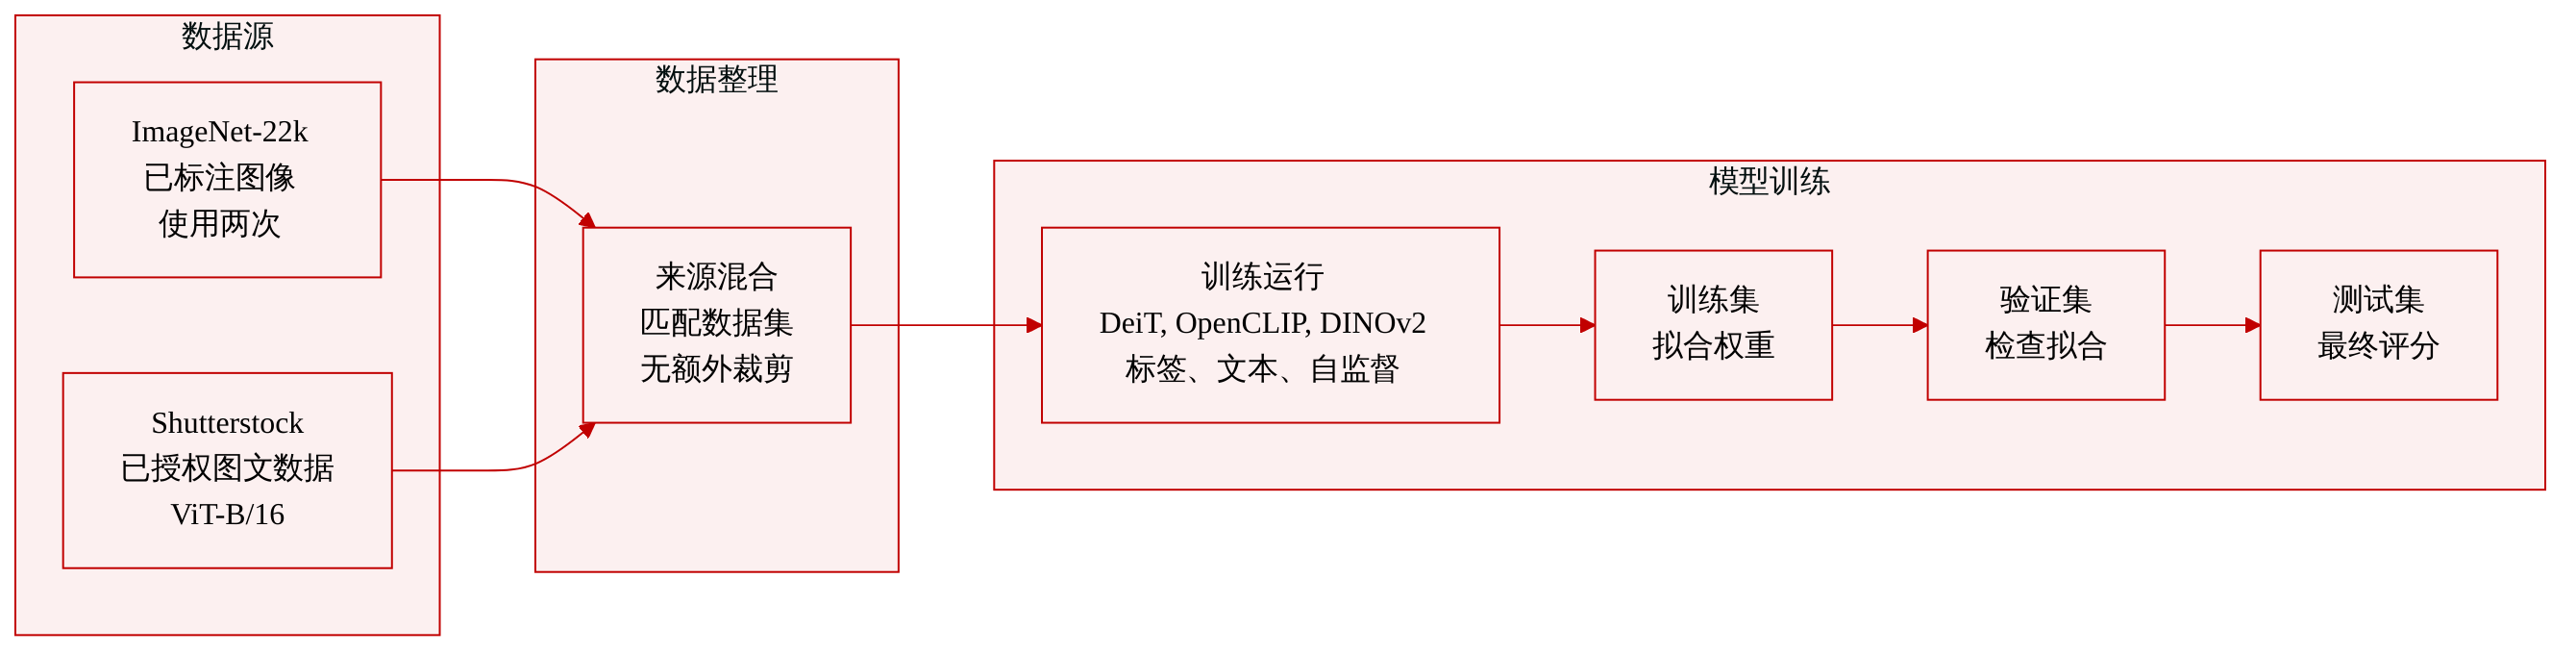
作者围绕用于评估其方法的三种训练设置构建数据集:标签监督、文本监督和自监督学习。
-
在标签监督训练中,作者使用 ImageNet-22k,并采用 DeiT-III 训练配方和 ViT-B 配置。该数据集为标准的分类训练提供带标签图像。
-
在文本监督训练中,作者使用基于 Shutterstock 的图文对齐语料。该子集只包含已获得授权的图像-文本对,用于训练或修改采用 ViT-B/16 图像编码器的 OpenCLIP 风格模型。
-
在自监督训练中,作者同样使用 ImageNet-22k,但采用 ViT-L 配置和 DINOv2 设置。其中,图像用于从无标签数据学习视觉特征。
-
总体上,论文使用了三个数据源或变体:ImageNet-22k 用于监督和自监督实验,Shutterstock 授权图文语料用于文本监督训练。文中所述数据用途主要在于将每个数据集与相应的训练方法和模型规模相匹配,没有提供额外的裁剪或元数据构建细节。
方法
作者关注现代视觉 Transformer 中的一个诊断问题:当模型变得足够大并训练足够久时,一些 patch tokens 会出现异常大的 embedding 范数,并表现得像注意力异常值。这些 tokens 经常出现在视觉冗余或同质区域中,说明网络并不只是在局部特征提取上失败,而是将低信息 patch 重新用作全局信息的非正式存储槽。这种 patch 序列内部的角色重新分配可能损害局部特征,并影响密集预测任务。如下图所示:
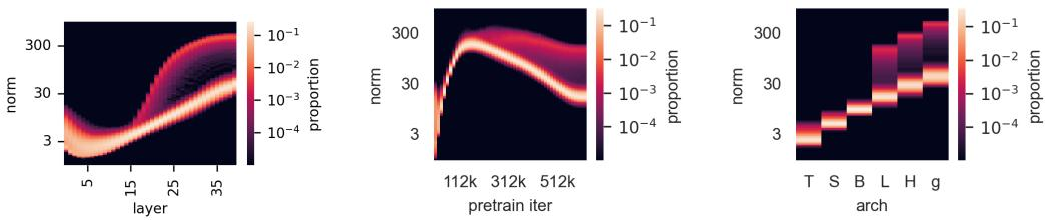
训练动态进一步澄清了问题来源。高范数 outlier tokens 不会在初始化后立即出现。它们通常出现在中间编码器层中,发生在预训练已经进行了相当大比例之后,并且在更大的模型架构中尤其明显。这表明该行为是学习到的优化结果,而不是视觉 Transformer 架构本身固有的特性。预训练目标会影响该现象的出现时间,但模型容量和训练时长也是决定性因素。参见以下分析:
基于这一诊断,作者提出一种简单的架构修复方案:把隐式寄存器机制显式化。模型不再允许任意 patch tokens 吸收全局状态,而是获得专门的寄存器 tokens。在 patch embedding 层之后,输入序列会被附加可学习的 tokens;这些 tokens 在 Transformer 编码器中的参与方式与其他 tokens 完全相同,但不被用作图像输出。
设一张图像的 patch embeddings 为
zi∈Rd,i=1,…,N,并设一个全局 classification token 为 xcls∈Rd。作者添加 R 个寄存器 tokens
rj(0)∈Rd,j=1,…,R,其初始值是学习得到的参数,在理念上类似于 classification token。编码器输入变为
X0=[xcls,z1,…,zN,r1(0),…,rR(0)].这些寄存器 tokens 与序列其余部分一起通过相同的 Transformer 块。通过自注意力,它们可以聚合全局上下文,与 patch tokens 交互,并将信息广播回序列。由于它们不绑定到特定空间 patch,因此为模型提供了中性位置,使其能够进行全局存储和取回,同时不破坏 patch 特征。
在视觉 Transformer 的输出端,寄存器 tokens 被丢弃。最终表示只由更新后的 classification token 和 patch tokens 构成:
Xout=[xcls′,z1′,…,zN′].在训练期间,寄存器 embeddings 与模型其余部分一起端到端学习。在推理时,可以以可忽略的架构代价将它们移除。该设计保留标准视觉 Transformer 工作流,同时防止模型把冗余 patch tokens 变成事实上的记忆寄存器。
实验
作者通过将寄存器 tokens 整合进监督式 DeiT-III、文本监督式 OpenCLIP 和自监督式 DINOv2 训练来验证寄存器 tokens,并结合定性可视化、特征范数和下游评估。研究发现,添加寄存器可以大幅移除高范数伪影并改善局部特征图,而不损害表示质量;单个寄存器已经能提供大部分收益,多个寄存器在部分任务上带来提升。进一步测试表明,寄存器增强了 DINOv2 和 DeiT-III 的无监督目标发现,对 OpenCLIP 则结果不一,注意力图显示寄存器能够自然地对不同目标专门化。
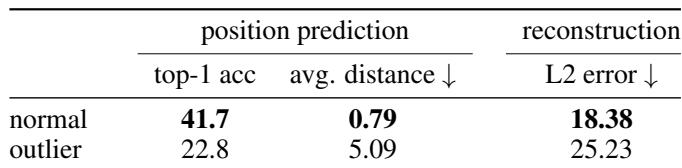
对 patch tokens 进行线性探针发现,正常 tokens 比异常值 tokens 保留更多局部信息。异常值 tokens 更难用于位置预测和输入 patch 重建,其预测特征对原始 patch 的忠实度更低。这表明类伪影 tokens 存储较少局部 patch 信息。异常值 patch tokens 在位置预测和输入 patch 重建上的准确率更低。异常值 patch tokens 的重建距离更大,L2 误差也高于正常 patch tokens。
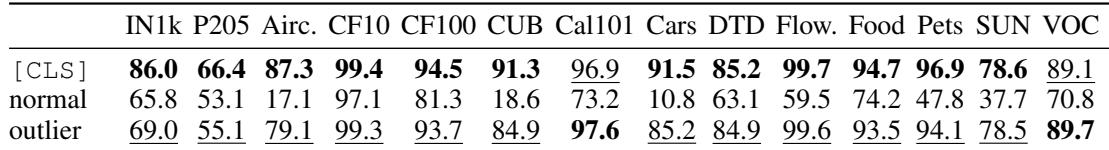
对 patch tokens 的线性探针显示,在所列基准上,高范数异常值 patch 的图像分类准确率远高于普通 patch。它们的性能远比正常 patch tokens 更接近 class token,说明这些伪影存储了大量全局图像信息。这表明最强的类别级线索是由一小部分异常局部特征携带的,而不是由大多数 patch 表示携带的。在所有所示基准上,异常值 patch tokens 的图像分类准确率都高于正常 patch tokens。class token 仍在许多数据集上领先,但异常值 tokens 通常接近其性能。正常 patch tokens 携带的类别信息明显更弱,这表明有用的全局图像细节可能集中在异常值 tokens 中。
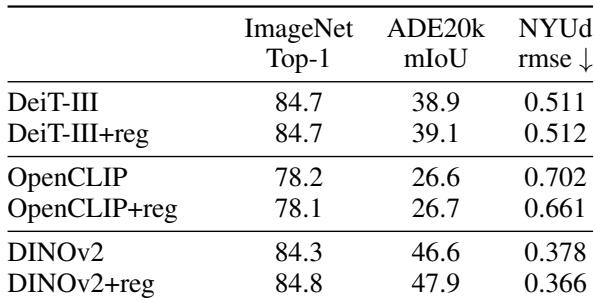
向训练好的模型添加寄存器主要在分类和密集预测任务上保持下游性能。最大收益出现在 DINOv2 的语义分割和深度估计任务上,而 OpenCLIP 也在深度预测上有所提升。对于 DeiT-III,寄存器保持分类性能不变,并带来轻微分割提升。寄存器没有普遍损害下游准确率,且常常改善密集任务指标。DINOv2 从寄存器中获益最多,尤其是在分割和深度评估上。尽管分类表现相似,OpenCLIP 在使用寄存器后深度性能仍略好。
实验比较了有和没有寄存器 tokens 训练的特征骨干网络在 PASCAL VOC 和 COCO 上通过 LOST 进行的无监督目标发现。寄存器 tokens 明显改善 DeiT-III 和 DINOv2 的发现性能,但使 OpenCLIP 略有下降。总体上,寄存器通常使骨干网络更适用于目标发现,尽管效果并非普遍正面。在所有数据集上,寄存器在 DINOv2 上带来最大收益。添加寄存器后,DeiT-III 性能显著提高。使用寄存器时,OpenCLIP 性能略低。
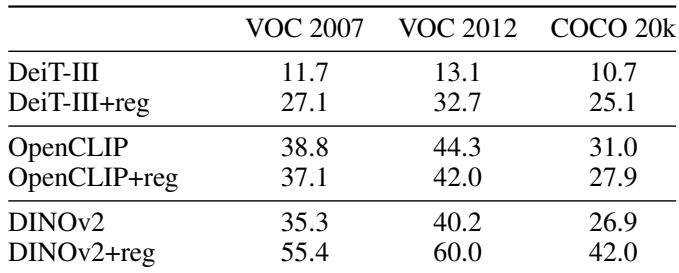
实验通过线性探针评估 patch tokens 如何编码信息,并评估添加寄存器 tokens 对下游视觉任务和无监督目标发现的影响。探针结果显示,正常 patch tokens 保留更多局部 patch 信息,而异常值或高范数 tokens 编码较弱局部细节但更强全局类别线索,通常接近 class token 性能。添加寄存器通常保持分类准确率,并经常改善密集预测,尤其对 DINOv2 如此;它也让特征骨干网络更适合 DINOv2 和 DeiT 的目标发现,仅对 OpenCLIP 略有下降。