Command Palette
Search for a command to run...
基于深度卷积生成对抗网络的无监督表示学习
基于深度卷积生成对抗网络的无监督表示学习
Alec Radford Luke Metz Soumith Chintala
摘要
近年来,基于卷积神经网络(CNN)的监督学习在计算机视觉应用中得到了广泛采用。相比之下,基于 CNN 的无监督学习受到的关注较少。本文期望帮助弥合 CNN 在监督学习与无监督学习之间成功差距。我们提出了一类称为深度卷积生成对抗网络(DCGAN)的 CNN,它具有某些架构约束,并证明其是无监督学习的有力候选方案。通过在多种图像数据集上进行训练,我们提供了令人信服的证据,表明我们的深度卷积对抗学习对能够在生成器和判别器中均学习到从物体部件到场景的层次化表示。此外,我们将所习得的特征用于新任务,证明了其作为通用图像表示的适用性。
一句话总结
来自 indico Research 和 Facebook AI Research 的研究人员提出了 DCGAN,这是一类具有特定架构约束的深度卷积生成对抗网络,能够从物体部件到场景学习分层表示,并生成可用于新任务的通用图像特征。
核心贡献
-
论文提出深度卷积 GAN,对卷积 GAN 增加架构约束以稳定训练,并将 CNN 在监督视觉任务中的成功与无监督表示学习联系起来。
-
在图像数据集上的实验表明,训练后的生成器和判别器能够从物体部件到场景学习层次化特征,并且判别器特征可以作为具有竞争力的通用图像表示用于分类。
-
论文进一步表明,GAN 滤波器对应可识别物体,并且生成器潜在空间算术能够对生成样本进行语义操控,证明所学特征的有效性。
引言
从大规模无标注图像数据集中学习的可复用特征在计算机视觉中很有价值,因为它可以减少对标注数据的需求,并改善图像分类等监督任务。生成对抗网络是一种有吸引力的生成式替代方案,但此前的 GAN 方法通常不稳定,生成的样本有噪声或模糊,也很少揭示网络内部学到的表示。作者通过提出深度卷积 GAN 来解决这一问题,这是一种使卷积 GAN 训练更稳定的约束架构。他们将训练后的判别器用作无监督特征提取器进行分类,对所学滤波器进行可视化以揭示有意义的物体模式,并展示生成器能够通过潜在空间算术支持语义操控。
数据集
-
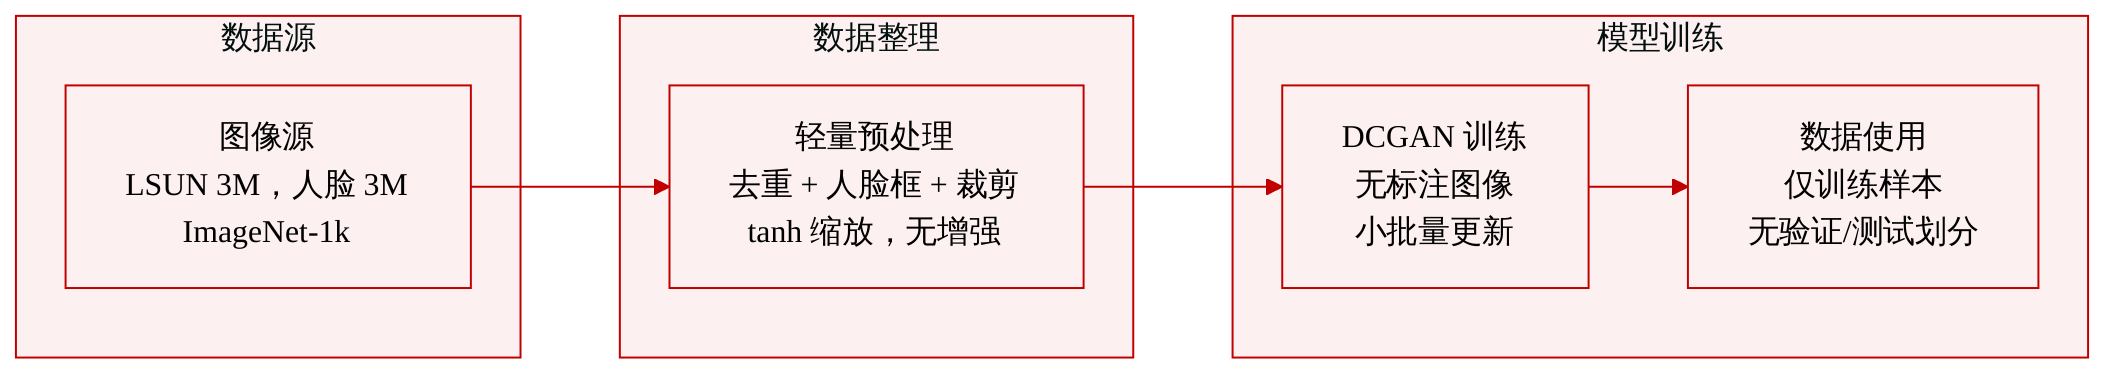
作者使用三个图像数据集对 DCGAN 进行无监督训练:LSUN bedrooms、新构建的 Faces 数据集和 ImageNet-1k。文中未描述训练/测试划分;这些数据被用作训练样本。
-
常见的预处理非常简单。图像被缩放到 tanh 激活范围,并且所有数据集均未应用数据增强。
-
LSUN bedrooms 提供略多于 300 万个训练样本。作者用它展示规模扩展和高分辨率生成,包括训练一个 epoch 后以及收敛后的样本。他们通过图像去重降低记忆风险:在 32x32 下采样中心裁剪上拟合自编码器,通过对 ReLU 激活进行阈值化来二值化潜在激活,并移除了约 27.5 万个近似重复样本。
-
Faces 数据集通过抓取随机人名查询得到的网络图像构建。人名来自 dbpedia,并限制为现代时期出生的人物。初始集合包含 10000 个人的 300 万张图像。作者运行 OpenCV 人脸检测器,并保留分辨率足够高的检测结果,得到约 35 万个用于训练的人脸框。
-
ImageNet-1k 用作自然图像来源。训练时,作者使用 32x32 最小边缩放中心裁剪。未应用数据增强。
方法
作者使用一种深度卷积生成对抗网络,旨在以比此前卷积 GAN 方法所能可靠实现的分辨率更高的水平稳定生成图像。该模型遵循对抗训练框架,其中生成器学习将潜在噪声映射为合成图像,判别器学习区分生成图像与真实图像。核心优化问题可写为
GminDmaxEx∼pdata[logD(x)]+Ez∼pz[log(1−D(G(z)))]其中 z 从潜在分布采样,G(z) 是生成图像。
该架构围绕三个主要设计选择构建:可学习重采样、移除隐藏全连接层以及归一化。对于生成器,确定性池化被分数步长卷积替代,使网络能够学习自身的空间上采样。对于判别器,空间下采样通过步长卷积执行,而不是固定池化。输入噪声向量通过线性层投影并重塑为四维张量,成为卷积堆栈的起始。判别器将最终卷积特征图展平,并映射为 sigmoid 输出。参见用于场景建模的生成器框架图:
如下所示:
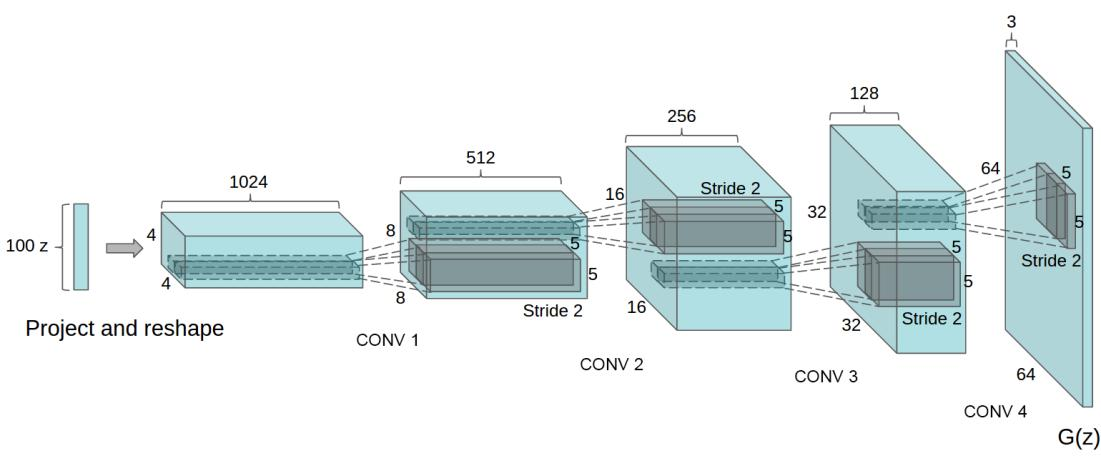
图中所示的生成器接收 100 维均匀潜在向量,将其投影为 1024 个特征图的 4×4 特征表示,并通过分数步长卷积扩展为 64×64 的 RGB 图像。值得注意的是,生成器不使用池化层或隐藏全连接层。这种全卷积结构允许网络直接从数据中学习空间上采样。
批归一化被应用于生成器和判别器中的大多数卷积层,以稳定梯度流动并降低对初始化的敏感性。然而,生成器输出层和判别器输入层有意省略批归一化,因为直接在这些层上应用批归一化会导致振荡和不稳定。在生成器中,内部层使用 ReLU 激活,而输出层使用 tanh,使生成像素落在目标图像范围内。在判别器中,全程使用 LeakyReLU 激活,泄漏斜率为 0.2。
对抗训练流程从最简图像预处理开始。训练图像被调整并缩放到 tanh 输出激活所期望的范围。对于人脸数据,候选图像通过人脸检测器处理,仅将分辨率足够高的检测结果保留为训练样本。对于大规模卧室图像数据,作者还在训练前使用去重流程,以降低生成器记忆重复训练样本的可能性。
去重工作流在 128 维编码的下采样中心裁剪上拟合自编码器。通过对 ReLU 激活进行阈值化来二值化编码层激活,为每张图像生成紧凑的二进制签名。这些签名用于高效的语义哈希和近似重复移除。该过滤步骤通过抑制可能诱发捷径学习的冗余样本,提升训练池质量。
在优化方面,所有模型均使用批量为 128 个样本的随机梯度下降进行训练。Adam 优化器的学习率为 0.0002,同时一阶矩系数从 0.9 降至 0.5,以提高稳定性。网络权重从标准差为 0.02 的正态分布初始化。核心训练运行期间未应用数据增强。
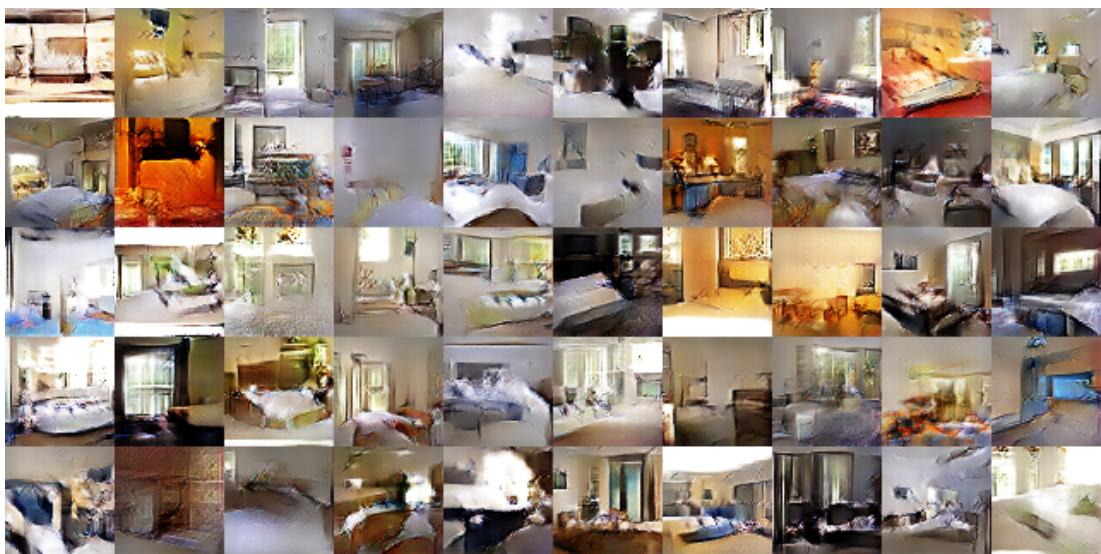
训练进展通过比较早期和后期生成样本进行监控。即使在只完成一轮数据遍历后,早期样本已经呈现出可识别的场景结构。如下所示为训练一轮后生成的卧室图像:
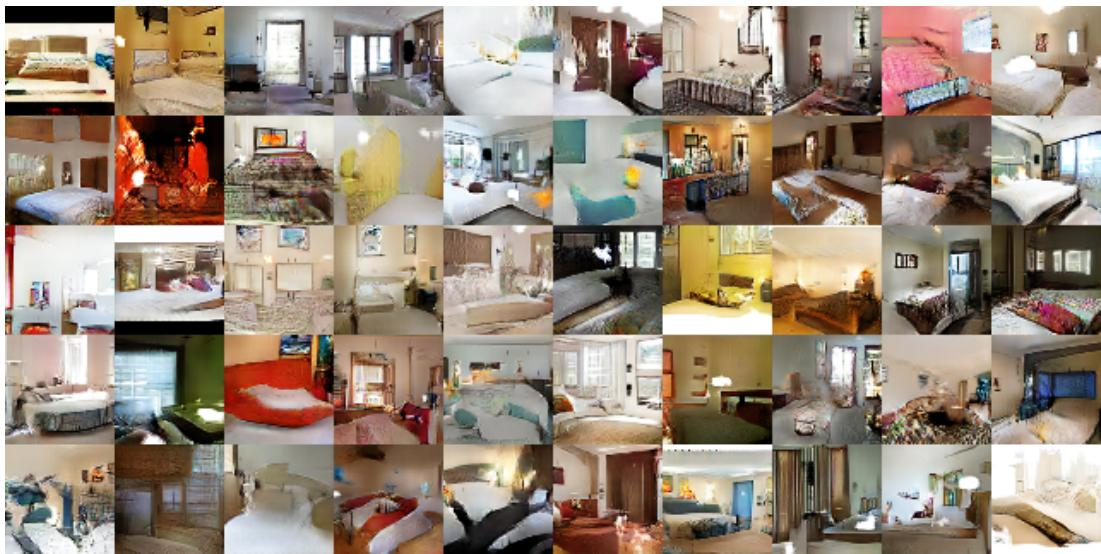
随着对抗训练继续,样本变得更加连贯和精细,尽管仍可能残留一些局部伪影。如下所示为额外训练轮次后生成的卧室图像:
实验
实验在大规模高分辨率卧室数据集上评估模型,以衡量规模扩展和记忆效应,并通过 CIFAR-10 和 SVHN 上的迁移分类测试所学特征。这些评估表明,强生成能力并非仅仅由于过拟合,所学表示能够跨域迁移并在低标签场景下保持有效,而且性能不能仅由网络架构解释。额外的潜在空间、特征可视化和生成器操控分析揭示了平滑且语义组织良好的表示,支持对物体和属性进行可解释编辑。
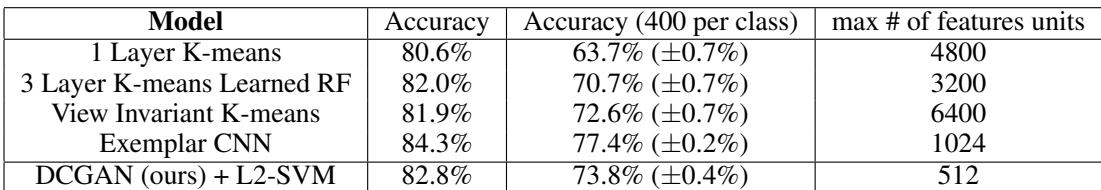
该表比较了用于 CIFAR-10 分类的特征方法,包括在 ImageNet 上学习并直接应用于 CIFAR-10、且未进行 CIFAR-10 预训练的 DCGAN 特征。DCGAN 加 L2-SVM 的组合与其他基线方法相当,同时使用相对较少的特征单元,特别是在 400-per-class 设置下。Exemplar CNN 取得最高总体准确率,而 DCGAN 方法在该设置下优于 K-means 基线。在 ImageNet 上训练的 DCGAN 特征可迁移到 CIFAR-10 分类。DCGAN 加 L2-SVM 使用的特征单元少于 K-means 基线。Exemplar CNN 实现最强总体准确率。
使用 1000 个标签的 SVHN 分类结果表明,SWWAE 模型的错误率显著低于 KNN、TSVM 及其中间组合。在 SWWAE 中加入 dropout 进一步降低错误率,表明其优于无 dropout 的变体。在报告的模型中,带 dropout 的 SWWAE 具有最低错误率,而无 dropout 的 SWWAE 仍优于基线和中间方法。将 M1 与 KNN 或 TSVM 结合,相比原始 KNN 和 TSVM 基线带来中等提升。M1+M2 优于 M1+TSVM,但准确性仍低于 SWWAE 变体。
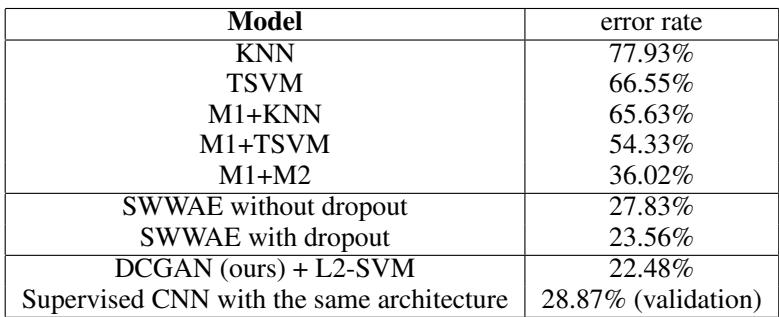
实验比较了 CIFAR-10 的可迁移特征表示与 SVHN 的概率模型。在 CIFAR-10 上,ImageNet 训练的 DCGAN 特征结合 L2-SVM,尽管使用更少特征单元,仍与基线方法相当,并在有限标签设置下优于 K-means 方法,尽管 Exemplar CNN 总体仍最强。在 SVHN 上,SWWAE 模型显著优于 KNN、TSVM 及其中间组合,dropout 可进一步提升性能。