Command Palette
Search for a command to run...
基于深度强化学习的连续控制
基于深度强化学习的连续控制
Timothy P. Lillicrap Jonathan J. Hunt Alexander Pritzel Nicolas Heess Tom Erez Yuval Tassa David Silver Daan Wierstra
摘要
本文将深度 Q 学习背后的思想推广至连续动作域。我们提出了一种基于确定性策略梯度的 Actor-Critic 无模型算法,能够在连续动作空间上运行。使用相同的学习算法、网络架构和超参数,该算法鲁棒地求解了超过 20 项物理仿真任务,包括倒立摆起摆、灵巧操作、足式运动和汽车驾驶等经典问题。我们的算法能够找到性能可与具备域动力学及其导数完整访问权限的规划算法所找到的策略相竞争的解。我们进一步证明,对于其中许多任务,该算法能够“端到端”地学习策略:即直接从原始像素输入中学习。
一句话总结
Google DeepMind 提出了一种基于确定性策略梯度的无模型 actor-critic 算法,将 Deep Q-Learning 扩展到连续动作空间,稳健地求解超过 20 项模拟物理任务,其性能可与拥有完整动力学信息的规划方法相媲美,并能够从原始像素输入端到端地学习策略。
核心贡献
- DDPG 是一种 actor-critic、无模型算法,基于确定性策略梯度,将 Deep Q-Learning 的思想适配到连续动作域,并稳健求解超过 20 项模拟物理任务,包括 cartpole 摆动、灵巧操作、腿足运动和汽车驾驶。
- 在单一算法、网络架构和超参数设置下,DDPG 学习得到的策略可与能够完全访问环境动力学及导数的规划算法相媲美,其中包括从原始像素输入端到端学习得到的策略。
- 结果表明,无需针对环境进行专门修改即可稳定学习,并且几乎所有任务都能在 250 万步经验数据内完成求解,这大约比 Deep Q-Learning 获得良好 Atari 解决方案所需的步数少 20 倍。
引言
深度强化学习使 agents 能够直接从像素等高维观测中学习复杂的物理控制任务,这对机器人技术具有重要意义,因为它消除了手工设计状态特征的需要,并且能够处理感知丰富的环境。然而,广泛使用的 Deep Q Network (DQN) 框架依赖于最大化学习到的动作价值函数,因此最适合离散动作空间,难以直接应用于连续高维控制。简单地将连续动作离散化会导致可能动作数量爆炸,使探索效率低下,并忽略动作空间中有用的结构;而早期的 actor-critic 和策略梯度方法在搭配深度神经网络时往往不稳定或扩展性较差。作者利用这些洞见提出 Deep Deterministic Policy Gradient (DDPG),一种面向连续控制的无模型、off-policy actor-critic 算法,并采用深度函数近似器。该方法将确定性策略梯度与 DQN 风格的稳定性机制结合,包括经验回放缓冲区和目标网络,再加上批归一化,从而从低维状态输入和原始像素中学习稳健的物理控制策略。
方法
该方法是一种面向连续动作空间的深度 actor-critic 强化学习框架。当动作连续时,标准 Q-learning 难以直接应用,因为在每一步计算贪心动作都需要在动作空间中求解一个优化问题。为避免这一问题,作者使用 actor-critic 架构,其中确定性 actor 将状态映射到动作,critic 估计状态-动作对的价值并指导 actor 改进。
actor 参数化为
μ(s∣θμ)并为给定状态输出确定性动作。critic 参数化为
Q(s,a∣θQ)并使用 Bellman 式价值更新进行学习。actor 通过经由 critic 对期望回报关于 actor 参数求导来更新。使用链式法则,actor 梯度可写为
∇θμJ≈Est∼ρβ[∇θμQ(s,a∣θQ)s=st, a=μ(st∣θμ)]或等价地,
∇θμJ=Est∼ρβ[∇aQ(s,a∣θQ)s=st, a=μ(st∣θμ)∇θμμ(s∣θμ)s=st].这里,critic 提供关于动作的梯度信号,actor 则被更新以产生能够提高 critic 价值估计的动作。
完整方法被称为深度确定性策略梯度,并通过若干设计选择扩展这一思想,使神经网络在大型连续状态和动作空间中学习更稳定。
使用经验回放缓冲区收集 agent 生成的转移:
(st,at,rt,st+1).缓冲区会在许多回合中存储这些转移。在每个更新步骤中,actor 和 critic 会在缓冲区中均匀采样的小批量上训练。这有两个作用。首先,它打破连续环境转移之间的强时间相关性,这很有用,因为随机优化方法通常假设小批量样本近似独立。其次,它支持高效的小批量学习,而不是完全在线的单个转移更新。
critic 被训练以使用目标值估计动作价值函数。为减少不稳定,引入 actor 和 critic 的目标副本:
μ′(s∣θμ′)andQ′(s,a∣θQ′).这些目标网络用于为 critic 更新计算稳定目标。不是定期复制在线网络权重,而是通过缓慢跟踪在线网络来软更新目标网络:
θ′←τθ+(1−τ)θ′,其中 0<τ≪1。这使得目标在训练期间逐渐变化,并将价值学习变成更监督、方差更低的优化问题。为 actor 和 critic 都使用目标副本很重要,因为目标动作价值同时依赖目标 actor 和目标 critic。如果任一目标组件变化过于突然,critic 目标可能变得不稳定,训练可能发散。
批归一化也被整合进网络设计。在低维连续控制任务中,状态特征可能具有不同物理单位以及差异很大的取值范围,例如位置与速度。这会使学习对特征缩放和超参数敏感。为缓解这一问题,使用批归一化在整个小批量上归一化激活值,使其近似零均值和单位方差。具体而言,归一化应用于状态输入、actor 网络的内部层,以及在动作输入加入之前 critic 网络的相关层。这减少了对手工特征缩放的需求,并提高了在不同状态尺度任务间的泛化能力。
探索与确定性策略分开处理。由于学习到的 actor 将每个状态映射到单一动作,可通过在 actor 输出中加入随机噪声构造探索策略:
μ′(st)=μ(st∣θμ)+N,其中 N 从所选噪声过程中采样。这使得 agent 能在连续动作空间中探索,同时仍从确定性策略表示中学习。对于具有惯性或平滑动力学的控制任务,更偏好时间相关噪声,因为纯独立随机扰动可能产生低效或不真实的控制信号。在这种情况下,可以使用 Ornstein-Uhlenbeck 噪声过程生成更平滑、具有自相关性的探索动作。
总体而言,该方法将确定性策略学习与 off-policy 经验回放、软更新目标网络、批归一化和随机探索结合起来。这些组件共同使神经 actor-critic agent 能够从与环境顺序交互中学习稳定的连续控制策略。
实验
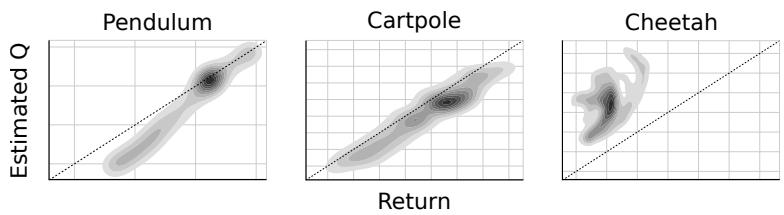
实验在模拟 MuJoCo 控制任务和赛车游戏中评估 DDPG,同时使用低维状态和像素观测,并进行周期性策略测试、消融实验、基线比较和价值估计分析。结果表明,目标网络和批归一化等算法组件对稳定学习很重要;在较简单任务上,基于像素的学习可与基于状态的学习相媲美,在更困难的环境中仍能得到有用策略。与朴素基线和基于模型基线的比较表明,学习得到的控制器普遍有效;Torcs 实验进一步证明了通用性,尽管不同训练副本之间性能存在差异。
在列出的模拟任务中,DDPG 通常能从低维状态和像素观测中取得正的归一化性能,最佳运行有时超过规划基线。在部分较简单任务中,基于像素的学习可以与低维状态持平或更优,但平均性能在不同环境中波动更大。原始 DPG 风格控制器的平均性能通常较弱,尽管某些最佳运行仍具竞争力。在较简单环境中,像素观测可以与低维状态观测相媲美,某些情况下甚至更优。尽管偶尔有强势的最佳表现,原始 DPG 风格控制器的平均稳定性仍低于 DDPG。
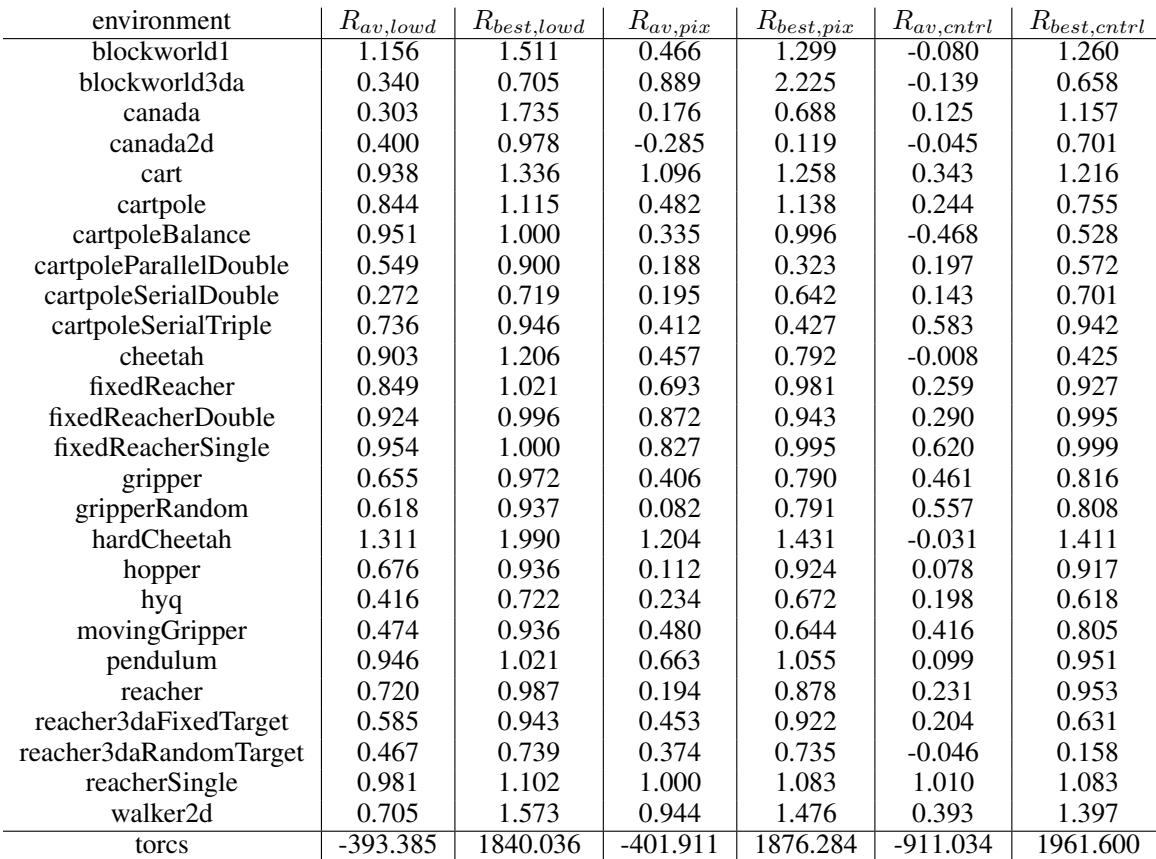
在模拟连续控制任务上的实验比较了 DDPG、基于像素的变体以及原始 DPG 风格控制器。DDPG 通常能从低维状态和像素观测中取得正的归一化性能,偶尔超过规划基线;在较简单任务中,像素观测可以与状态输入持平或更优,尽管波动更大。原始 DPG 风格控制器的平均稳定性和平均性能均弱于 DDPG,尽管某些最佳运行仍具竞争力。