Command Palette
Search for a command to run...
通过联合学习对齐与翻译实现神经机器翻译
通过联合学习对齐与翻译实现神经机器翻译
Dzmitry Bahdanau KyungHyun Cho Yoshua Bengio
摘要
神经机器翻译是近期提出的一种机器翻译方法。与传统的统计机器翻译不同,神经机器翻译旨在构建一个单一神经网络,通过联合调优来最大化翻译性能。近期提出的神经机器翻译模型大多属于编码器–解码器家族,其将源语言句子编码为一个固定长度的向量,然后由解码器从该向量生成翻译。本文推测,使用固定长度向量是提升该基本编码器–解码器架构性能的瓶颈,因此提出对这一架构进行扩展,允许模型自动进行(软)搜索以寻找源语言句子中与预测目标词相关的部分,而无需显式地将这些部分切分为硬片段。采用这一新方法,我们在英法翻译任务上取得了与现有最先进的基于短语系统相当的翻译性能。此外,定性分析表明模型所发现的(软)对齐与我们的直觉高度吻合。
一句话总结
Bahdanau 等人(Jacobs University Bremen 和 Université de Montréal)提出了一种用于神经机器翻译的注意力机制。该机制通过允许解码器对相关源语言位置进行软搜索,克服了固定长度向量瓶颈,并在英法翻译上取得了与当时先进的基于短语系统相当的翻译性能。
核心贡献
-
论文提出了 RNNsearch,这是一种基于注意力机制的神经机器翻译模型。该模型在预测每个目标词时,对源词或编码器注释进行软搜索,从而扩展了标准的编码器-解码器架构。这一设计无需将整个源句子编码为单个固定长度向量,并将对齐与翻译联合训练。
-
在英法翻译任务上,RNNsearch 显著优于传统的编码器-解码器模型 RNNencdec,并且据报告对源句子长度更具鲁棒性。其结果还达到了与基于短语的统计机器翻译系统相当的翻译质量。
-
定性分析表明,RNNsearch 生成的软对齐通常与人类直觉一致,能够将生成的目标词与相关的源词或注释联系起来。这一证据支持了注意力机制在翻译生成过程中学习到了有用的对齐信息。
引言
神经机器翻译的目标是构建一个单一的大型网络,该网络读取源句子并直接生成翻译,使机器翻译比传统的基于短语系统更加端到端。早期的编码器解码器模型在解码之前会将整个源句子压缩为一个固定长度向量,这限制了长句子上的性能,因为模型必须将所有信息存储在一个瓶颈中。作者通过引入一个联合学习对齐和翻译的模型来解决这一问题。该模型使用软搜索,使每个生成的目标词能够关注相关的源词,从而消除固定长度瓶颈,并提升翻译质量,尤其是在较长句子上。
数据集
-
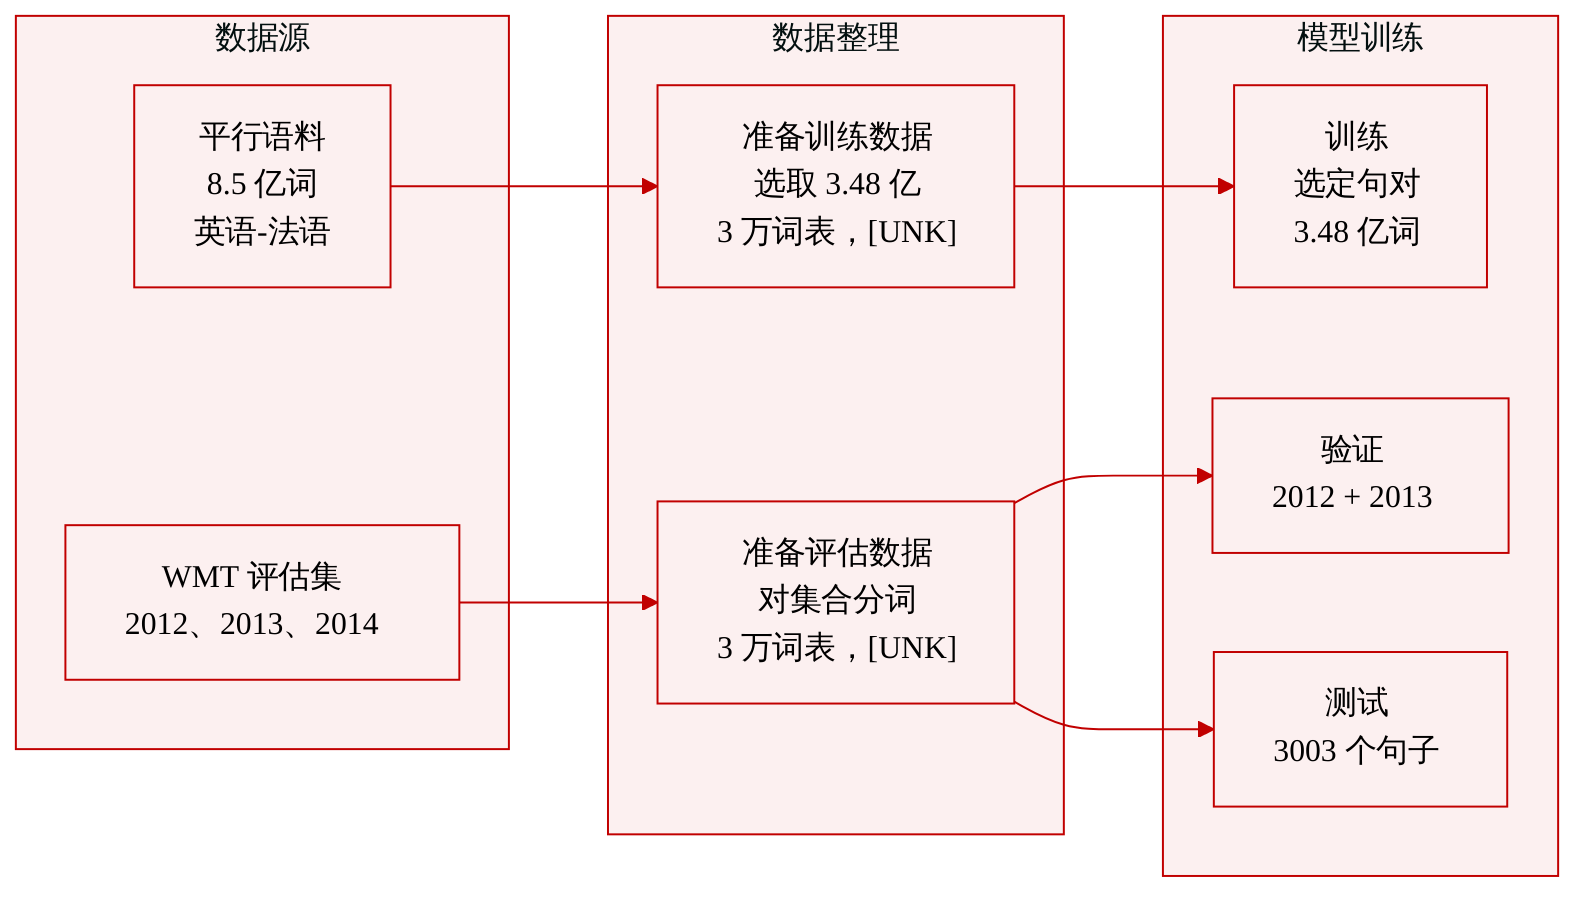
数据集来自 WMT ’14 英法平行语料库。它包括 Europarl(61M 词)、新闻评论(5.5M 词)、UN(421M 词)以及两个爬取语料库(90M 和 272.5M 词),总计 850M 词。
-
作者没有使用这些平行语料库之外的单语数据。为了管理语料库规模,他们按照 Cho 等人描述的流程,采用 Axelrod 等人(2011)的数据选择方法,将合并后的训练数据减少到 348M 词。
-
训练集是筛选后的英法平行语料库。开发(验证)集由 news-test-2012 和 news-test-2013 拼接而成。最终评估在 WMT ’14 测试集上进行,该测试集包含未出现在训练数据中的 3003 个句子。
-
在处理方面,作者应用标准分词,并为每种语言构建一个由出现频率最高的 30,000 个词组成的词表。所有未登录词都被映射到一个特殊 token:[UNK]。
-
未应用其他预处理,例如小写化或词干提取。
方法
作者在一个编码器解码器结构上构建翻译系统,但将传统模型使用的固定长度摘要向量替换为一个与语言模型联合学习的动态注意力机制。整体目标保持不变:给定源句子 x=(x1,…,xTx),通过将序列概率分解为如下形式来生成目标句子 y=(y1,…,yTy)
p(y)=i=1∏Typ(yi∣y1,…,yi−1,x).在标准 RNN 编码器解码器中,编码器首先将输入句子压缩为一个单一上下文向量,然后解码器使用该固定表示来预测每个目标词。作者提出为每个目标位置生成单独的上下文向量。这使得解码器在生成下一个词时能够有选择地查看源序列。
请参考框架图。
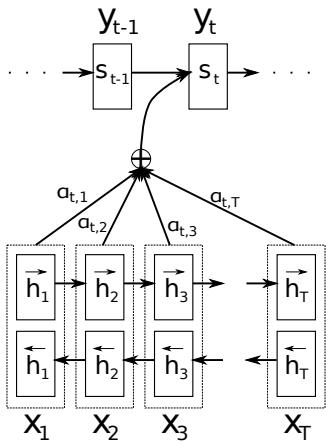
编码器是一个双向循环神经网络,它从两个方向读取源句子,并为每个源语言 token 生成一个注释。对于位置 j,正向 RNN 产生正向隐藏状态 hj,反向 RNN 产生反向隐藏状态 hj。它们被拼接为注释向量
hj=[hj⊤;hj⊤]⊤.由于每个注释都概括了前文和后文的信息,它能够更丰富地表示 xj 周围的源语言上下文。
解码器维护一个 RNN 隐藏状态 si,并根据下式预测下一个目标词 yi
p(yi∣y1,…,yi−1,x)=g(yi−1,si,ci),其中 si 的更新方式为
si=f(si−1,yi−1,ci).关键变化在于,ci 不再是所有解码步骤共享的全局向量。它被计算为源语言注释的加权组合:
ci=j=1∑Txαijhj.权重 αij 由对齐模型确定,该模型对生成 yi 之前源位置 j 与当前解码状态的匹配程度进行评分。分数定义为
eij=a(si−1,hj),最终注意力权重通过 softmax 归一化得到:
αij=∑k=1Txexp(eik)exp(eij).在这一公式中,αij 可以被解释为目标词 yi 对齐到源词 xj 的概率,而 ci 是该分布下的期望注释。与传统机器翻译流程不同,对齐不被视为需要离散推断的隐变量。它是一种连续的、可微分的软对齐,因此翻译损失产生的梯度可以直接传播到对齐模型和编码器中。
这一设计使编码器无需将整个源句子编码为一个固定长度向量。信息被保留在注释序列中,解码器可以在每个生成步骤中选择性地检索源序列的相关部分。
实验
实验在 WMT ’14 数据上评估英法翻译,并在匹配的训练和评估设置下,将提出的 RNNsearch 模型与标准 RNN 编码器解码器进行比较。结果验证了所提出架构的整体有效性,尤其是在长句上,基线模型在这些句子上会出现性能下降,并开始遗漏或改变含义。定性对齐分析进一步支持了如下解释:注意力权重提供了有用的软对齐,既捕获单调对应关系,也捕获翻译所需的非单调重新排序。
基于注意力机制的 RNNsearch 模型取得了比相应编码器解码器基线更高的 BLEU 分数,尤其是在不包含未知词的翻译上。更长的 RNNsearch 变体经过延长训练后进一步提升性能,并在已知词句子上接近基于短语的 Moses 基线。这些提升与所报告的长句翻译优势一致,因为在基线模型中,保真度会随着输入长度增长而下降。RNNsearch 在全部句子和已知词子集上都优于 RNNencdec。在没有未知词的句子中,RNNsearch 接近 Moses 系统,尽管 Moses 使用了额外的单语数据。训练更长的 RNNsearch 模型进一步提升了翻译质量,并支持其对长句的鲁棒性。
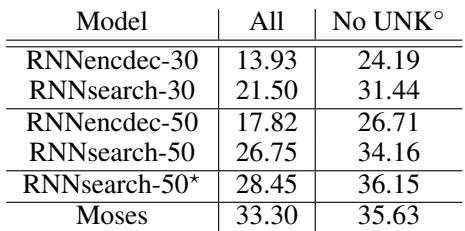
实验比较了基于注意力机制的 RNNsearch 模型、编码器解码器基线以及基于短语的 Moses 系统,使用 BLEU 分数评估全部句子以及不包含未知词的子集。RNNsearch 持续优于编码器解码器基线,在已知词翻译以及较长输入降低基线保真度的句子上提升更明显。对更长的 RNNsearch 变体进行进一步训练后,性能提升,并在已知词句子上接近 Moses,尽管 Moses 利用了额外的单语数据。这表明注意力机制提升了具有挑战性的长翻译的鲁棒性。