Command Palette
Search for a command to run...
神经网络的有趣特性
神经网络的有趣特性
Christian Szegedy Wojciech Zaremba Ilya Sutskever Joan Bruna Dumitru Erhan Ian Goodfellow Rob Fergus
摘要
深度神经网络是表达能力极强的模型,近期在语音和视觉识别任务上取得了最优性能。虽然其强大的表达能力是其成功的原因,但也导致其学习到了不可解释的解,这些解可能具有违反直觉的特性。本文报告了其中两种特性。首先,我们发现根据多种单元分析方法,不存在单个高层单元与高层单元随机线性组合之间的区别。这表明在神经网络的高层中,包含语义信息的是空间本身,而非单个单元。其次,我们发现深度神经网络学到的输入-输出映射在很大程度上是相当不连续的。我们可以通过施加一种几乎不可察觉的扰动来使网络对图像产生错误分类,这种扰动是通过最大化网络的预测误差找到的。此外,这些扰动的特定性质并非学习的随机产物:同样的扰动可以使一个在不同数据子集上训练的不同网络对同一输入产生错误分类。
一句话总结
来自 Google、纽约大学、蒙特利尔大学和 Facebook 的研究人员表明,深度网络中的语义信息存在于表示空间中,而不是个别高层单元中,并发现了这样的对抗样本:通过最大化网络预测误差找到的微小且几乎不可察觉的扰动会导致错误分类,并能在独立训练的网络之间迁移。
核心贡献
- 单元分析表明,个别高层单元与高层单元的随机线性组合无法区分,说明语义信息编码在表示空间中,而不是孤立单元中。
- 一种优化过程通过产生几乎不可察觉的扰动来找到对抗样本,使原本正确分类的图像被错误分类,展示了深度网络输入输出映射在训练样本附近存在显著不连续性。
- 同一扰动可使在不同数据集子集上训练的不同网络对相同输入产生错误分类,表明对抗扰动不是随机学习伪影,并支持将其用于类似困难负例挖掘的建设性训练方案。
引言
深度神经网络已成为视觉和语音识别的核心,因为它们可以通过大量并行非线性运算学习复杂映射,而反向传播使这一过程在实践中有效。然而,它们的内部表示和决策边界难以解释,先前工作通常假设单个神经元具有明确语义含义,并且微小输入变化不应影响分类。这项研究表明这些假设可能失效:语义信息更适合由整体激活空间刻画,而不是特定单元,并且精心选择的微小扰动能够制造对抗样本,改变预测并在模型之间迁移。
方法
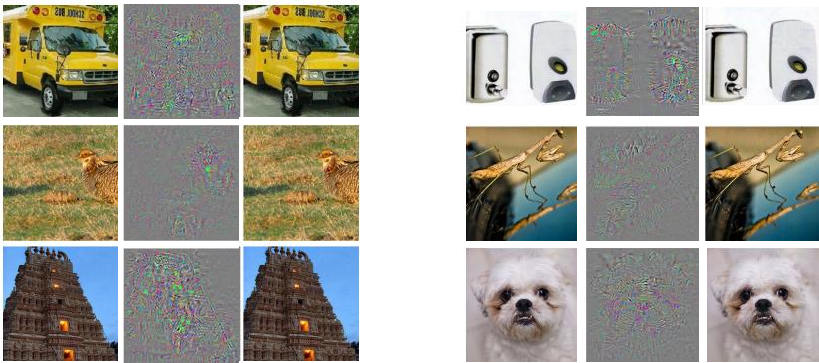
该方法围绕三个紧密相关的想法组织:检查单个激活单元、通过最近图像优化构建盲区对抗样本,以及通过分层谱界衡量网络不稳定性。这些组件共同定义了一套工作流,用于分析决策边界、识别高维输入空间中的脆弱区域,并量化微小扰动在深度架构中的传播方式。
基本记号为:图像表示为向量 x∈Rm,而 ϕ(x) 表示所选隐藏层产生的激活值。第一个分析模块将隐藏层激活视为候选特征,并搜索强烈激活个别单元的图像。这遵循传统的特征检查视角:如果 ϕ(x) 中的某个单元对应可解释模式,则可以搜索最大化该单元响应的输入。形式化地,对于激活空间的第 i 个坐标,该方法检查形如下式的输入
x′=x∈Iargmax ⟨ϕ(x),ei⟩,其中 ei 是选择第 i 个激活坐标的基向量,I 表示有效图像空间。该过程生成的可视化能够揭示哪些局部笔画模式、空间构型或低维结构驱动特定单元。对于手写数字模型,此类可视化可以分离对圆弧笔画、对角线段或数字上、下部件的敏感性。
对于更大的分类器,该方法将网络视为标签预测器
f:Rm→{1,…,k},并配有针对目标标签 l 的连续代理损失 lossf(x,l)。核心盲区构造要求找到最小的加性扰动 r,迫使分类器将图像 x 分配给不同标签 l。这被表述为箱约束最近图像问题:最小化 ∥r∥2,满足
f(x+r)=l,以及
x+r∈[0,1]m.由此得到的扰动图像记为 D(x,l),表示 f 分类为 l 且与 x 最接近的图像。如果 f(x)=l,问题变得平凡,因此该方法关注 f(x)=l 的情况。由于精确计算最近决策边界对深度非凸网络困难,作者在有约束惩罚框架内使用箱约束 L-BFGS 求解器近似 D(x,l)。他们找到一个足够大的标量 c>0,使得如下表达式的极小值点
c∥r∥2+lossf(x+r,l)满足目标标签约束。惩罚项鼓励小扰动,而损失项推动网络朝向目标类别。对于凸损失,这可以恢复精确最近边界点,但对于神经网络,它产生实用近似。
架构模块支持跨模型族进行分析。对于较小的数字模型,该方法检查带 softmax 输出的全连接网络,以及在自编码器之上训练的分类器。对于自然图像模型,该方法检查更深的卷积架构,包括标准监督网络和非常大的无监督网络。MNIST 实验还包括权重衰减正则化,以及可选地将训练集划分为互不相交的训练和评估分区,从而使分析能够观察扰动行为和单元敏感性如何响应训练约束的变化。
最后一个模块通过各层的谱性质分析不稳定性。如果网络有 K 层,其激活映射可写为组合
ϕ(x)=ϕK(ϕK−1(⋯ϕ1(x;W1);W2)⋯;WK),其中 ϕk 使用参数 Wk 将第 k−1 层映射到第 k 层。作者用每层 Lipschitz 常数的乘积来界定整个网络的加性稳定性。对每一层,他们定义 Lk,使得
∀x,r,∥ϕk(x;Wk)−ϕk(x+r;Wk)∥≤Lk∥r∥.整个网络随后满足
∥ϕ(x)−ϕ(x+r)∥≤L∥r∥,其中
L=k=1∏KLk.因此,对抗敏感性可被解释为沿分层信号路径的放大。如果早期层具有较大的扩张因子,微小输入变化可以在后续激活中产生较大变化,并最终影响 logits。
对于半整流层,无论全连接层还是卷积层,其映射形式为
ϕk(x;Wk,bk)=max(0,Wkx+bk).由于整流器 ρ(u)=max(0,u) 是压缩的,该层满足
∥ϕk(x;Wk)−ϕk(x+r;Wk)∥≤∥Wkr∥≤∥Wk∥∥r∥.因此,一个简单的上界为
Lk≤∥Wk∥,其中 ∥Wk∥ 是算子范数,也就是最大奇异值。这提供了一种从学习到的权重估计不稳定性的直接机制。
该分析还考虑池化和归一化。最大池化是压缩的,因为其雅可比选择坐标子集,而不是扩展输入扰动:
∀x,r,∥ϕk(x)−ϕk(x+r)∥≤∥r∥.对于如下形式的对比归一化层
ϕk(x)=(ϵ+∥x∥2)γx,其中 γ∈[0.5,1],作者推导出界
∀x,r,∥ϕk(x)−ϕk(x+r)∥≤ϵ−γ∥r∥.这表明归一化选择如何影响稳定性界。
对于卷积层,算子范数可以通过谱估计。具有 C 个输入特征、D 个输出特征、空间支持 N×N 以及步幅 Δ 的卷积,可以用卷积核 wc,d 写为
Wx={c=1∑Cxc⋆wc,d(n1Δ,n2Δ), d=1,…,D}.使用 Parseval 公式,算子范数变为
∥W∥=ξ∈[0,NΔ−1)2sup∥A(ξ)∥,其中 A(ξ) 是一个 D×(C⋅Δ2) 矩阵,其第 d 行为
A(ξ)d=(Δ−2wc,d(ξ+l⋅N⋅Δ−1), c=1,…,C, l=(0,…,Δ−1)2).这里 wc,d 表示卷积核 wc,d 的二维傅里叶变换:
wc,d(ξ)=u∈[0,N)2∑wc,d(u)e−2πi(u⋅ξ)/N2.该卷积范数计算将不稳定性分析转化为对已学习滤波器的谱检查。早期层中的大算子范数表明网络能够放大微小输入扰动,这与优化模块发现的盲区样本存在性一致。然而,这些界是保守的:较大的界本身并不能证明对抗样本存在,而较小的界表明在该 Lipschitz 度量下不会发生此类样本。这一观察启发了正则化路径:在训练过程中惩罚上界 Lipschitz 界,以降低加性不稳定性。
实验
在 MNIST、ImageNet 和大规模 YouTube 图像样本上,实验检查了全连接、自编码器、AlexNet 和 QuocNet 模型中的激活模式与对抗行为。随机激活方向产生的图像具有语义意义,可与来自个别单元的图像相媲美,这表明网络并未沿自然基方向清晰分离变化因子。小且视觉上细微的扰动持续导致错误分类,并常常在不同架构、超参数和训练集上仍然有效,这表明对抗样本反映的是通用模型盲区,而非对单一设置的过拟合;同时,初步的对抗样本增广似乎能提升鲁棒性。谱稳定性分析表明敏感性可在深度网络早期产生,并提出 Lipschitz 风格正则化作为可能的缓解方案。
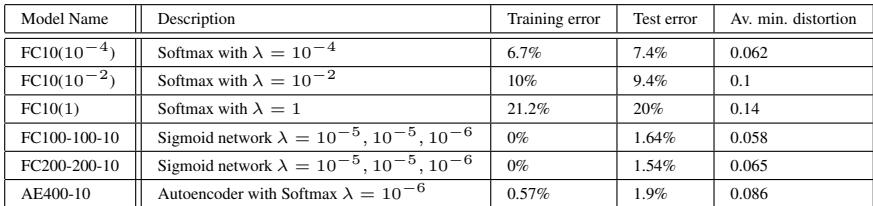
在所考虑的 MNIST 模型中,可以用较小平均最小失真生成对抗样本,并且这些低失真扰动出现在简单 softmax 模型和更深 sigmoid 或自编码器模型中。测试性能较好的模型倾向于表现出低失真,而强正则化的 softmax 变体具有更高测试误差和更大失真值。也报告了相对较大比例的对抗样本能泛化到在不同超参数或不相交训练集上训练的网络。许多 MNIST 网络允许存在接近原始输入的对抗样本,其度量依据是小的平均最小失真。更强的 softmax 正则化与更差测试误差和更大最小失真同时出现,而准确的 sigmoid 模型保持低失真。
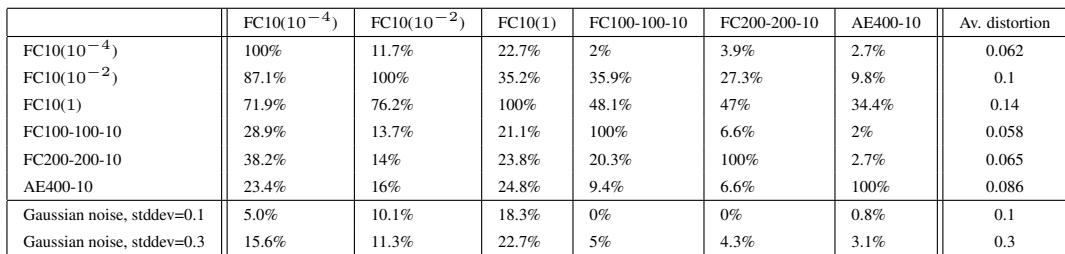
结果表明,为一个网络生成的小对抗失真经常导致采用不同架构或超参数训练的其他网络错误分类,表明跨模型泛化。这种效应在变体中在全连接模型之间最强,并且比可比随机噪声的影响更显著,而平均失真保持较小。为一个模型生成的对抗样本经常迁移到具有不同全连接配置的模型。迁移的错误分类比高斯噪声错误更明显,这表明结构化失真揭示了共享盲区。平均失真值保持较低,因此这些样本仍接近原始训练数据。
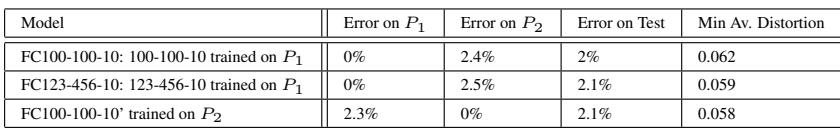
被评估的全连接模型在无扰动分区和公共测试集上实现低误差,同时只需要小的平均扰动即可创建对抗样本。这些证据表明,此类样本能够泛化到具有不同层大小的模型,甚至泛化到在不相交分区上训练的模型。所测试模型上的无扰动基线误差保持较低。小的平均扰动足以创建对抗样本。对抗错误分类在超参数变化和不相交训练集上发生迁移。
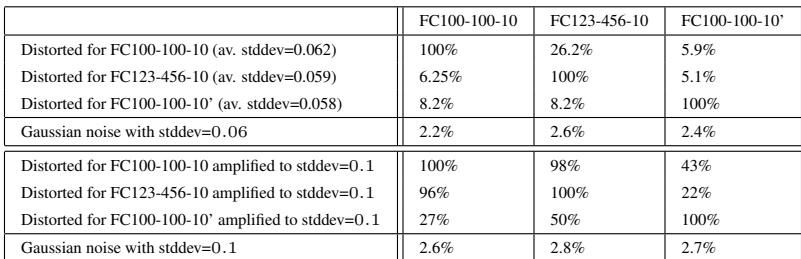
为一个全连接网络生成的对抗扰动会导致其完全错误分类目标样本,同时较小但可察觉比例也会欺骗其他在不同条件下训练的网络。这种跨模型效应远强于类似失真大小的随机噪声,并且在扰动被放大时更加明显。这些结果支持定性发现,即小对抗扰动可以泛化到生成它们的模型之外。对抗样本对生成它们的模型非常有效。相当比例的对抗样本也会导致从零开始、使用不同超参数或训练数据训练的相关网络出现错误。定向对抗扰动相比可比高斯噪声产生更高的跨模型误差。增加扰动幅度会显著增强迁移的错误分类效应。
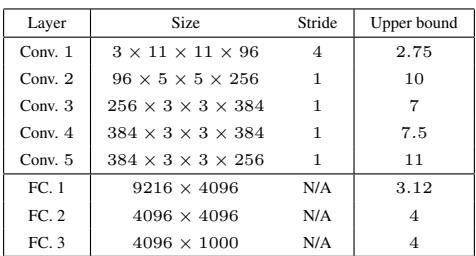
该表报告了网络中整流卷积层和全连接层 Lipschitz 常数的上界。这些界通常大于一,表明小输入扰动可被分层映射放大。这些界是保守诊断:较大值暗示可能不稳定,而较小值提供针对此类扰动的保证。整流卷积层和全连接层的 Lipschitz 上界大于一,表明可能放大小扰动。第一卷积层已经具有大于一的界,因此不稳定性可能出现在网络早期。若干卷积层的界大于全连接层,表明卷积阶段可能强烈促生不稳定性。
对 MNIST 分类模型的实验比较了简单 softmax、sigmoid 和自编码器架构,以及带有 Lipschitz 诊断的全连接层和卷积层。结果表明,表现良好的网络可能被非常小的输入扰动误导,并且这些对抗样本经常迁移到具有不同架构、超参数或训练集的模型。这种迁移远强于可比随机噪声,并随扰动大小增长,同时 Lipschitz 界揭示了整流层能够放大小扰动并引入不稳定性。