Command Palette
Search for a command to run...
Fast R-CNN
Fast R-CNN
Ross Girshick
摘要
本文提出了一种快速区域卷积网络(Fast R-CNN)方法用于目标检测。Fast R-CNN 在先前工作的基础上,利用深度卷积网络高效地对候选区域进行分类。与先前工作相比,Fast R-CNN 采用了多项创新技术,在提升训练和测试速度的同时也提高了检测精度。Fast R-CNN 训练 VGG16 网络的速度比 R-CNN 快 9 倍,测试速度快 213 倍,并且在 PASCAL VOC 2012 上取得了更高的 mAP。与 SPPnet 相比,Fast R-CNN 训练 VGG16 的速度快 3 倍,测试速度快 10 倍,且精度更高。Fast R-CNN 使用 Python 和 C++(基于 Caffe)实现,以 MIT 开源许可证发布于 https://github.com/rbgirshick/fast-rcnn。
一句话总结
微软研究院提出 Fast R-CNN,这是一种目标检测框架,采用多项创新,在提升检测精度的同时提高训练和测试速度;相比 R-CNN,训练 VGG16 网络更快(9×),测试也更快(213×),并在 PASCAL VOC 2012 上取得更高 mAP。
核心贡献
- Fast R-CNN 被提出为一种基于区域的 ConvNet 检测器,使用单阶段、多任务训练算法,在更新所有网络层的同时,联合学习对候选框进行分类并修正其空间位置。
- 该方法消除了基于磁盘的特征缓存和多阶段 R-CNN 流水线,使 VGG16 等非常深网络的训练和测试更快、更高效。
- 在 PASCAL VOC 2012 上,Fast R-CNN 达到 66% mAP,优于 R-CNN,训练速度比 R-CNN 快 9 倍,测试速度比 R-CNN 快 213 倍,并且在训练速度、测试速度和精度方面相比 SPPnet 也有进一步提升。
引言
深度 ConvNet 推动了图像分类的发展,但目标检测更困难,因为它既要识别目标,又要准确定位目标。这需要处理许多候选目标框(称为候选框),并将粗略候选框优化为精确的边界框,这通常会损害速度、精度或训练简单性。
先前的检测器(如 R-CNN 和 SPPnet)取得了较强结果,但依赖多阶段流水线,将特征提取、分类器训练和边界框回归分开。这些方法训练慢,需要在磁盘上建立大特征缓存,并且测试时运行缓慢。SPPnet 也无法完全更新卷积层,限制了非常深网络的精度。
作者提出 Fast R-CNN,一种单阶段训练算法,使用多任务损失联合学习目标分类和空间边界框修正。该方法更新所有网络层,避免特征缓存,比 R-CNN 和 SPPnet 训练快得多,同时在 PASCAL VOC 2012 上取得更高检测精度。
方法
Fast R-CNN 架构、训练与检测流水线
Fast R-CNN 被表述为统一的检测架构,输入完整图像和一组候选目标框,然后对每个候选框联合预测类别概率和修正后的边界框偏移。系统首先使用由卷积层和最大池化层组成的卷积骨干网络处理整幅图像,生成共享卷积特征图。对于每个候选目标框,兴趣区域(RoI)池化层从该共享特征图中提取固定长度特征表示。得到的特征向量通过全连接层,然后分成两个并列分支:一个分支产生目标类别加背景类的 softmax 概率,另一个分支为每个目标类别预测四个实数边界框修正偏移。参见框架图
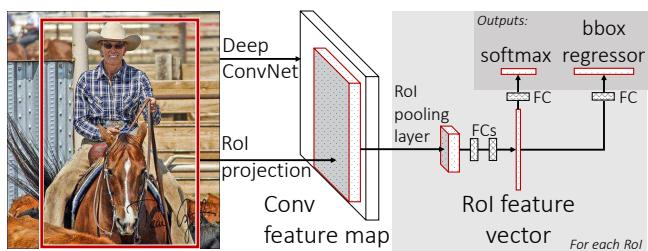
RoI 池化层是卷积骨干网络与候选框特定预测头之间的中心空间接口。每个 RoI 表示为卷积特征图中的矩形窗口,由元组 (r,c,h,w) 定义,其中 (r,c) 是左上角坐标,(h,w) 是高度和宽度。RoI 池化将该窗口划分为 H×W 个子窗口网格,并在每个子窗口内跨特征通道独立应用最大池化。输出是固定尺寸的 H×W 特征图,通常选择为与第一个全连接层期望的空间输入尺寸匹配。例如,VGG16 风格配置可能使用 H=W=7。该机制允许不同宽高比和大小的候选框映射到共同特征维度,同时保留整幅图像前向计算的高效性。
在将预训练的 ImageNet 分类网络用于检测时,架构会进行三项关键转换。首先,用配置了适当 H 和 W 值的 RoI 池化层替换最后一个最大池化层。其次,用两个并列输出层替换最后一个全连接分类层和 softmax 层:一个是在包含背景在内的 K+1 个类别上的 softmax 分类器,另一个是特定类别的边界框回归器。第三,修改输入流水线,使其同时接收图像列表和 RoI 列表。这些改动允许将标准图像分类骨干网络改造为端到端可训练的检测器。
Fast R-CNN 的训练围绕分层小批量采样设计,以利用同一图像中候选框之间的特征共享。每个随机梯度下降小批量不是将每个 RoI 视为来自不同图像,而是先采样 N 张图像,然后从每张选定图像中采样 R/N 个 RoI。来自同一图像的 RoI 共享同一卷积前向计算,并参与同一反向传播。这大幅减少冗余计算和内存使用。例如,当 N=2 且 R=128 时,两张图像各自贡献 64 个 RoI,使训练过程比从 128 张不同图像中各采样一个 RoI 更高效。论文指出,这种策略大致比 R-CNN 和 SPPnet 的采样方法快 64×。
前景和背景 RoI 根据与真实框的 IoU(intersection over union,交并比)采样。一部分 RoI(通常为 25%)从 IoU 至少 0.5 的候选框中采样,并标记为前景类别 u≥1。其余 RoI 从与真实框最大 IoU 位于区间 [0.1,0.5) 内的候选框中采样,并标记为背景,u=0。较低的 IoU 阈值有助于在训练中加入困难背景样本。训练期间图像以 0.5 的概率水平翻转,但不使用额外数据增强。
模型使用多任务损失进行训练,联合优化分类和定位。对于每个已标记 RoI,令 p=(p0,…,pK) 表示预测的 softmax 概率分布,u 表示真实类别,tu 表示类别 u 的预测边界框回归偏移,v 表示真实偏移。总损失为
L(p,u,tu,v)=Lcls(p,u)+λ[u≥1]Lloc(tu,v),其中分类损失为标准 log 损失
Lcls(p,u)=−logpu.定位项仅在 RoI 是前景样本时应用。对于背景 RoI,u=0,忽略边界框回归损失。定位损失定义为
Lloc(tu,v)=i∈{x,y,w,h}∑smoothL1(tiu−vi),其中
smoothL1(x)={0.5x2∣x∣−0.5if ∣x∣<1,otherwise.这种 smooth L1 损失比早期检测系统常用的 L2 损失对异常值更不敏感。它特别适用于边界框回归,因为无界回归目标否则可能导致梯度爆炸,或需要精细调整学习率。超参数 λ 控制定位的相对重要性,文中所述设置使用 λ=1。
反向传播通过跟踪 RoI 池化层的最大池化 argmax 操作来路由。如果 yrj 是 RoI r 在池化单元 j 处的输出,且 xi 是输入激活,则前向最大池化可写为
yrj=xi∗(r,j),i∗(r,j)=argi′∈R(r,j)maxxi′.在反向传播期间,梯度仅通过与每个子窗口中取得最大值的输入累积:
∂xi∂L=r∑j∑[i=i∗(r,j)]∂yrj∂L.这允许多个 RoI 的梯度反向流入共享卷积层,从而实现对整个检测器的真正端到端微调。
在初始化时,全连接输出层由小标准差的高斯分布设定,偏置初始化为零,各层学习率相对于卷积层进行缩放。训练使用动量、参数衰减和分阶段学习率降低,但核心架构贡献是共享图像特征、RoI 池化、分层采样以及联合分类和定位目标的结合。
尺度不变性可通过两种方式处理。第一种是暴力学习,在训练和推理期间以固定像素大小处理图像,迫使网络直接从数据中学习尺度变化。第二种是图像金字塔训练和推理,其中每个候选目标框通过分配到其投影 RoI 面积接近目标大小(例如 2242 像素)的金字塔层级,来近似进行尺度归一化。在多尺度训练期间,选择图像时会随机采样金字塔尺度,作为数据增强的一种形式。
在测试阶段,检测仅需要对一幅图像(或图像金字塔)和一组候选目标框进行前向传播。对于每个候选框,网络输出 softmax 概率分布和类别特定的边界框偏移。对于给定候选框和类别 k,置信度取预测概率 pk,并对每个类别独立应用非极大值抑制以移除冗余检测结果。
一个重要的运行时考虑是,检测需要处理许多 RoI,因此尽管全连接层在纯图像分类中成本很小,在检测中它们可能成为显著瓶颈。在 VGG16 风格的检测器中,评估约 2000 个候选框时,全连接阶段可能消耗接近一半的前向传播时间。为了解决这个问题,可以用截断奇异值分解压缩大型全连接层。权重矩阵 W∈Ru×v 近似为
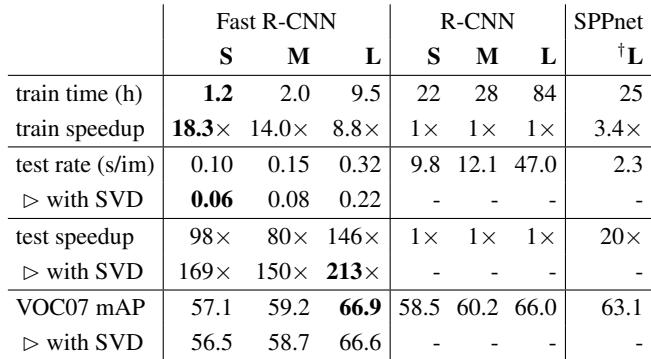
W≈UΣtVT,其中 U 包含前 t 个左奇异向量,Σt 包含前 t 个奇异值,V 包含前 t 个右奇异向量。原始层被替换为两个线性层,一个使用 ΣtVT,另一个使用 U,两者之间没有非线性。这使参数数量从 uv 变为 t(u+v),当 t 远小于 min(u,v) 时,可显著减少推理时间。如时间开销分解所示:
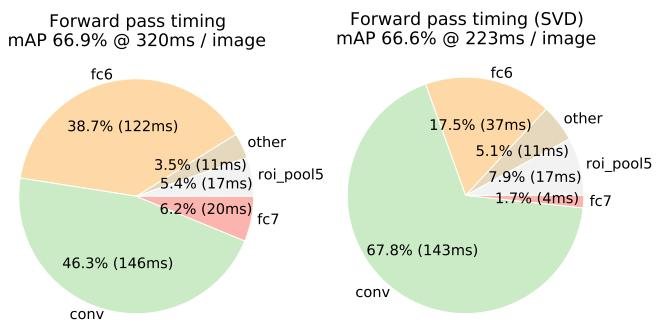
这种压缩策略在只导致很小检测精度损失的情况下,为网络全连接部分带来可观加速,使 Fast R-CNN 对于每幅图像需要为数千个候选框打分的系统变得实用。
实验
实验在 PASCAL VOC 基准和初步 MS COCO 上进行,使用三种在 ImageNet 上预训练的卷积网络,并与 R-CNN 和 SPPnet 比较,以评估检测精度、训练和测试效率以及关键设计选择。主要结果表明,Fast R-CNN 在大幅减少训练和测试时间的同时实现较强检测性能,并且微调卷积层对非常深网络尤其重要。额外消融实验验证多任务学习、单尺度处理和扩充训练数据有益,softmax 可以替代后处理 SVM,并且添加过多候选框可能降低精度而非提升精度。
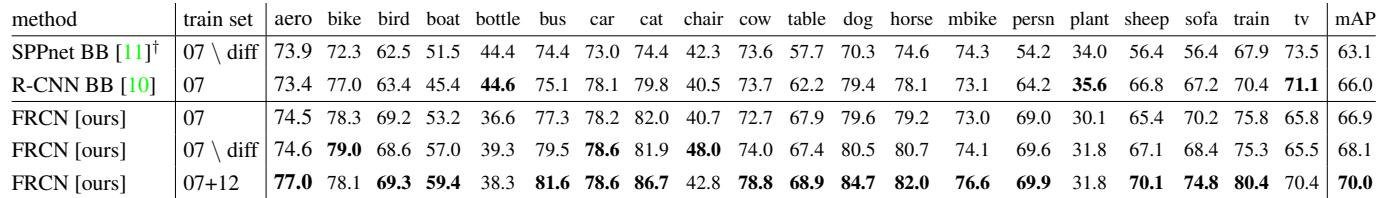
这些结果在 VOC 2007 上使用 VGG16 比较 Fast R-CNN 与更早检测器。Fast R-CNN 与 R-CNN 具有竞争力,当从训练中排除困难样本时性能提升,加入 VOC12 训练图像后精度进一步提高。总体趋势是更大更干净的训练集支持更好的检测性能。在 VOC07 上训练的 Fast R-CNN 在多个类别上超过 R-CNN,包括 bird、boat 和 person。从训练中移除困难样本会提高 Fast R-CNN 的总体平均精度。增加 VOC12 训练数据进一步提升总体平均精度,并改善许多单独类别。
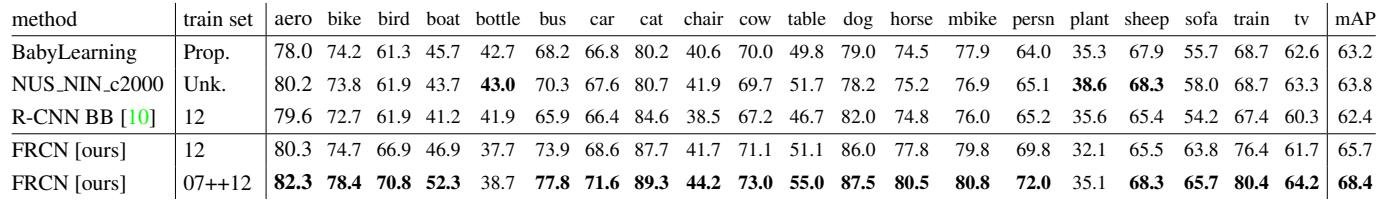
在 VOC 2010 测试检测上,Fast R-CNN 与强大的公开排行榜方法具有竞争力,尽管它主要使用标准 VGG16 训练设置。当使用额外分割标注时,SegDeepM 略优于 Fast R-CNN,而 Fast R-CNN 从扩充联合训练集中获得更多收益并实现反超。比较也支持 Fast R-CNN 作为比基于较慢 R-CNN 流水线方法更快的替代方案。Fast R-CNN 在 VOC 2010 的许多目标类别上表现强劲。当使用分割标注训练时,SegDeepM 相对 Fast R-CNN 总体有小幅优势。扩大的 07++12 训练集足以使 Fast R-CNN 超过 SegDeepM。据报道,Fast R-CNN 比其他测试到的基于 R-CNN 的方法快得多。
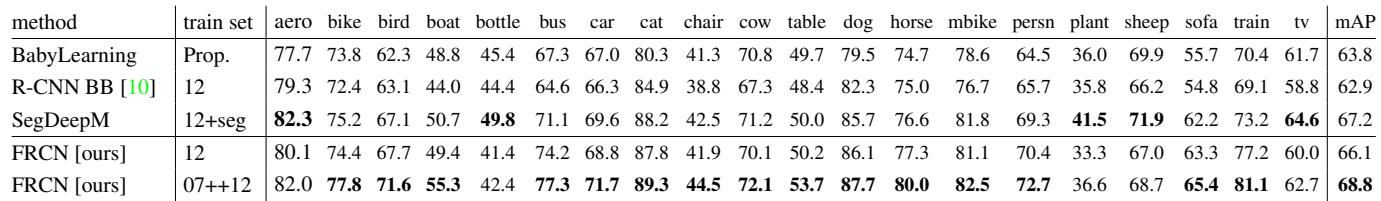
Fast R-CNN 在该基准的比较方法中达到最高检测平均精度。使用更大训练集会进一步提高精度,并扩大相对先前结果的领先优势。所提出的检测器在比较中给出最佳总体平均精度。使用扩大的训练集训练相比较小训练配置会提升检测性能。
Fast R-CNN 相比 R-CNN 和 SPPnet 大幅减少训练和测试运行时间,其中 VGG16 模型的加速最明显。截断 SVD 提供额外测试加速,同时只导致很小的精度损失。Fast R-CNN 也避免缓存特征,从而消除大量磁盘存储需求。Fast R-CNN 的训练和测试显著快于 R-CNN 和 SPPnet。截断 SVD 进一步减少检测时间,只有轻微 mAP 下降。Fast R-CNN 避免特征缓存,因此节省数百 GB 磁盘存储。
将 VGG16 的微调限制为仅全连接层会降低检测精度,微调更深的卷积层则精度更高。从 conv3_1 及之后层开始微调可恢复大部分精度,同时保持较快测试速率,扩展到 conv2_1 只带来较小提升,并造成实际训练约束。多尺度 SPPnet 训练显示不同的精度与速度折中,测试成本更高。冻结卷积层并仅训练全连接层对 VGG16 精度不够。从 conv3_1 及之后层微调是平衡精度与训练成本的实用选择。将微调扩展到 conv2_1 只产生轻微精度改善,并且实用性较低。五尺度 SPPnet 训练以显著更慢的评估换取不同精度结果。
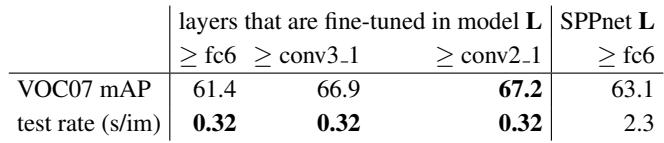
在 VOC 2007、VOC 2010 及相关检测基准上的实验将 Fast R-CNN 与先前基于 R-CNN 的检测器进行比较,显示出很强竞争力,并且使用更多训练数据或排除困难样本时总体检测精度提高。运行时间比较表明,Fast R-CNN 相比 R-CNN 和 SPPnet 大幅加速训练和测试,避免特征缓存,并在截断 SVD 下获得额外加速,仅伴随很小精度损失。对 VGG16 微调的消融表明训练更深卷积层很重要,从 conv3_1 开始微调提供实用精度与效率折中,而多尺度训练增加计算成本。