Command Palette
Search for a command to run...
MiCRo:面向个性化偏好学习的混合建模与上下文感知路由
MiCRo:面向个性化偏好学习的混合建模与上下文感知路由
Jingyan Shen Jiarui Yao Rui Yang Yifan Sun Feng Luo Rui Pan Tong Zhang Han Zhao
摘要
奖励建模是将基于人类反馈的强化学习(RLHF)应用于大语言模型(LLM)以实现对齐、构建安全基础模型的关键步骤。然而,基于 Bradley-Terry(BT)模型的奖励建模假设存在一个全局奖励函数,无法捕捉人类偏好固有的多样性与异质性。这种过度简化限制了大语言模型支持个性化和多元对齐的能力。从理论上,我们证明当人类偏好服从由多样化子群体构成的混合分布时,单一 BT 模型存在不可约误差。尽管现有方案(如基于细粒度标注的多目标学习)有助于缓解这一问题,但其成本高昂且受限于预定义属性,无法充分捕捉人类价值的丰富性。本文提出 MiCRo,一种两阶段框架,通过利用大规模二值偏好数据集来增强个性化偏好学习,且无需显式的细粒度标注。在第一阶段,MiCRo 引入上下文感知的混合建模方法来捕捉多样化的人类偏好。在第二阶段,MiCRo 整合了一种在线路由策略,基于特定上下文动态调整混合权重以消除歧义,从而在仅需极少额外监督的条件下实现高效且可扩展的偏好适应。在多个偏好数据集上的实验表明,MiCRo 能有效捕捉多样化的人类偏好,并显著提升下游个性化性能。
一句话总结
伊利诺伊大学厄巴纳-香槟分校,纽约大学,莱斯大学的研究人员提出 MiCRo,一个两阶段框架,将上下文感知的混合建模与在线路由策略结合,以从大规模二元反馈中捕捉多样的人类偏好,无需细粒度标注,针对单个 Bradley-Terry 模型固有的不可约误差,并支持 LLM 中的个性化与多元对齐。
核心贡献
-
理论下界表明,当人类偏好遵循覆盖多样子群体的混合分布时,单个 Bradley-Terry 奖励模型会产生不可约的交叉熵误差,并且该误差会随着子群体多样性和依赖上下文的子群体权重增加而增大。
-
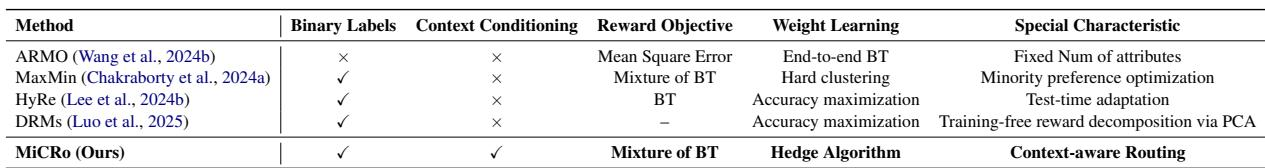
MiCRo 是一个两阶段框架,无需显式细粒度标注即可利用大规模二元偏好数据集;它首先对多个 Bradley-Terry 奖励组件进行上下文感知的混合建模,然后使用在线路由策略根据提示词上下文调整混合权重。
-
在多个偏好数据集上的实验表明,与基于单个全局奖励模型的方法相比,MiCRo 更好地捕捉异质人类偏好,并改善下游个性化与多元对齐。
引言
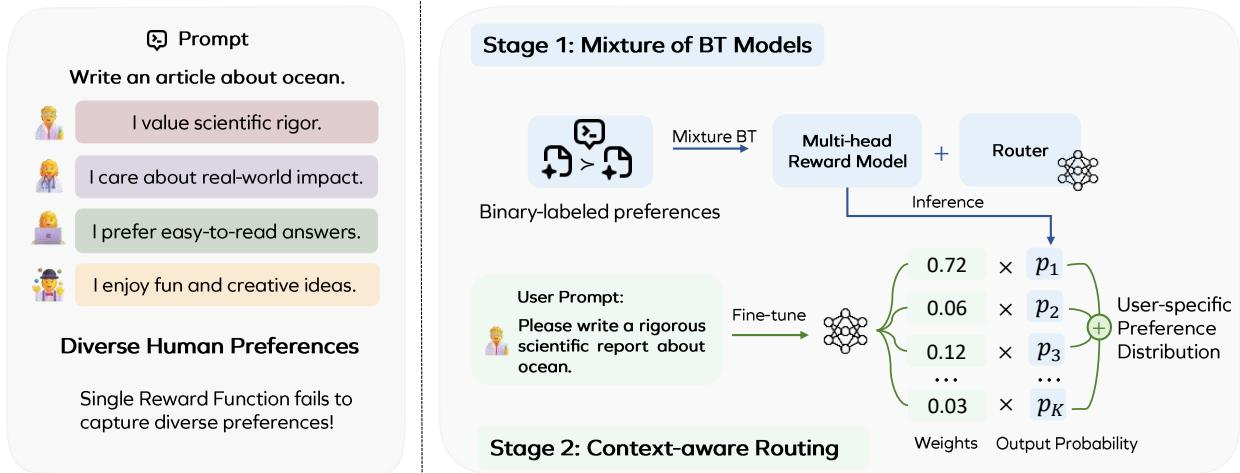
人类反馈强化学习用于将语言模型与人类价值观对齐,尤其适用于偏好主观且开放的情境。现有偏好学习方法通常从二元成对标签假设一个全局奖励函数,无法表达多样或冲突的用户偏好。近期的多属性建模尝试要么需要高成本的细粒度标注,要么依赖不完美的 LLM-as-a-judge 标签,要么需要人工设计的个性化上下文。作者提出 MiCRo,一个两阶段上下文感知混合建模框架,它从大规模二元偏好数据中学习潜在子群体奖励函数,给出理论下界,证明在混合偏好下单个 Bradley-Terry 模型存在不可约误差,并使用上下文感知在线路由,从有限样本适应个性化用户。
方法
作者采用一个两阶段偏好建模框架,将离线发现偏好异质性与在线适应用户上下文分离。第一阶段从大规模二元偏好数据集中学习一组候选奖励函数和一个上下文感知的混合权重网络。第二阶段保持学到的奖励头固定或仅轻微更新,只微调一个轻量级路由网络,为奖励头分配特定于用户的权重。这种设计使系统避免昂贵的子群体标签标注,并在部署时适应用户个性化偏好。
第一阶段核心是 Bradley-Terry 奖励模型的混合。在单奖励标准设置下,对于提示词 x 和两个响应 aw、al,aw 相对于 al 被偏好的概率被建模为:
P(aw≻al∣x)=σ(r∗(x,aw)−r∗(x,al)),其中 σ(⋅) 是 logistic 函数,r∗ 是潜在奖励函数。为在无需额外标注的情况下捕捉多样的人类偏好,作者引入 K 个潜在子群体,每个子群体拥有自身的奖励函数 rϕk。他们还引入一个混合权重网络 fψ,将每个提示词 x 映射到 K 个专家上的概率向量:
fψ(x)∈ΔK,k=1∑Kfψ,k(x)=1,fψ,k(x)≥0.使用该混合权重网络后,总体偏好概率变为:
P(aw≻al∣x)=k=1∑Kfψ,k(x)σ(rϕk(x,aw)−rϕk(x,al)).该公式使混合具有上下文感知能力。模型不再以固定权重平均所有奖励头,而是允许每个提示词激活最相关的专家或若干专家。因此,架构包含 K 个奖励头和一个以提示词为条件的路由网络,其中每个奖励头代表一个潜在偏好轮廓,路由网络决定在给定提示词的最终预测中每个轮廓的贡献强度。
奖励头和路由网络通过最小化偏好数据集上的负对数似然损失联合训练:
Lmle=−n1(x,aw,al)∈D∑logk=1∑K(fψ,k(x)σ(rϕk(x,aw)−rϕk(x,al))).为防止单个奖励头主导混合,作者加入一个正则化项,促使路由网络保持非退化的权重分布:
Lreg=n1(x,aw,al)∈D∑k=1∑Kfψ,k(x)logfψ,k(x).第一阶段完整目标为:
L(ϕ,ψ)=Lmle+αLreg,其中 α 控制正则化强度。该阶段仅从标准二元偏好标签中学习一组多样化的偏好专业化奖励函数。训练时不需要标注者身份,用户画像或显式子群体标签。
第二阶段处理剩余的部署挑战:给定特定用户或交互上下文,系统应如何为此前学到的奖励头分配权重?作者通过在上下文数据上微调路由网络来处理这一问题。在该阶段,路由网络的输入从提示词 xi 扩展为提示词与上下文的配对 (xi,ci),其中 ci 可以包含指令,元数据,人口统计信息,交互历史或其他用户信号。此时路由网络产生的权重为:
fψ(xi,ci)∈ΔK.每个奖励头仍作为独立评估偏好对的专家可用。对于上下文偏好样本 (xi,ci,ai,w,ai,l),第 k 个专家给出的概率为:
pk(ai,w≻ai,l∣xi)=σ(rϕk(xi,ai,w)−rϕk(xi,ai,l)).头级偏好损失定义为:
Li,k=−logpk(ai,w≻ai,l∣xi).路由网络为专家分配权重,第二阶段目标将期望专家损失与 KL 散度近端项结合:
Li=k=1∑Kfψ,k(xi,ci)Li,k+τKL(fψ(xi,ci)∥ωi),其中 ωi 是先验或此前的权重向量,τ 控制更新后的路由网络应多大程度保持接近该先验。在 B 个样本的上下文偏好预算下更新路由网络:
ψminB1i=1∑BLi,fψ(xi,ci)∈ΔK.得到的更新可视为 Hedge 风格的在线路由策略。对每个上下文感知样本,该方法计算 K 个奖励头上的软目标权重:
fi,k=∑j=1Kωi,jexp(−Li,j/τ)ωi,kexp(−Li,k/τ).这些软目标强调更能解释观测到偏好的奖励头,同时温度 τ 控制专家加权锐度,KL 项防止权重更新过于激进。随后通过最小化其预测权重与 Hedge 派生软标签之间的交叉熵来微调路由网络:
Lrouter=−B1i=1∑Bk=1∑Kfi,klogfψ,k(xi,ci).这种第二阶段设计保持路由过程轻量。混合建模期间学到的大型奖励函数提供可复用的偏好专家,而路由网络仅使用少量上下文偏好样本来调整它们的混合权重。部署时,最终个性化偏好分数通过组合固定或预训练的奖励头与经微调路由网络生成的上下文感知路由权重得到。
实验
实验在带二元标签的偏好数据集上评估上下文感知混合奖励框架,包括 HelpSteer2,RPR 和 preference-700K,并与单奖励,静态混合,集成适应和完全监督基线进行比较。结果表明,混合建模从多样偏好维度中提取专业化奖励头,上下文感知路由相比固定混合及相关方法提高了适应能力。在个性化设置中,该框架在数据集分布内和未见用户偏好上均表现良好,表明在小上下文预算下可实现标签高效个性化。
MiCRo 使用 Bradley-Terry 奖励的混合以及上下文感知权重学习,因此不同提示词可以激活不同的子群体奖励模型。与依赖固定混合或不依赖上下文条件化的先前方法相比,这种方法实现了上下文特化和更具适应性的个性化。实验结果显示它优于二元标签基线,能够泛化到未见用户,同时与使用更强监督的方法保持竞争力。上下文条件化使该方法区别于使用固定混合权重或无条件混合权重的先前方法。上下文感知路由可改善偏好学习,并能以少量上下文样本泛化到未见用户。
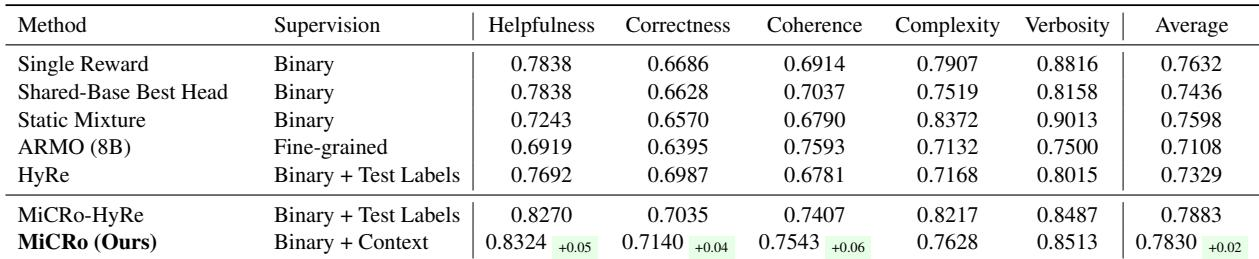
在 HelpSteer2 评估中,带上下文感知路由的 MiCRo 在比较的基线方法中取得最佳总体平均准确率,并在多个属性上优于单奖励基线。提升在有用性,正确性和连贯性上最明显,同时一些基线在冗长度或复杂度上仍保持竞争力。这些结果表明,使用用户上下文进行路由可以在有限监督下支持有效的个性化偏好适应。上下文感知的 MiCRo 在比较基线中给出最强总体平均准确率。相比 Single Reward 基线,它改善了有用性,正确性和连贯性。它在使用上下文二元标签时超越了更大的 ARMO 模型和 HyRe。
在 RPR 测试集上,MiCRo 在以二元标签训练的方法中取得最佳平均准确率,表明上下文感知路由能够根据用户偏好调整奖励。尽管使用的监督信号更少,它仍与更强的 ARMO 基线保持竞争力,而 MiCRo-HyRe 取得最高总体平均准确率。相比单奖励基线,上下文感知路由在多个偏好属性上提高了 RPR 准确率。对 MiCRo 的混合头添加测试时适应会给出最强的 RPR 总体平均。MiCRo 提供了相对于细粒度或测试标签适应方法的一种实用标签高效替代方案。
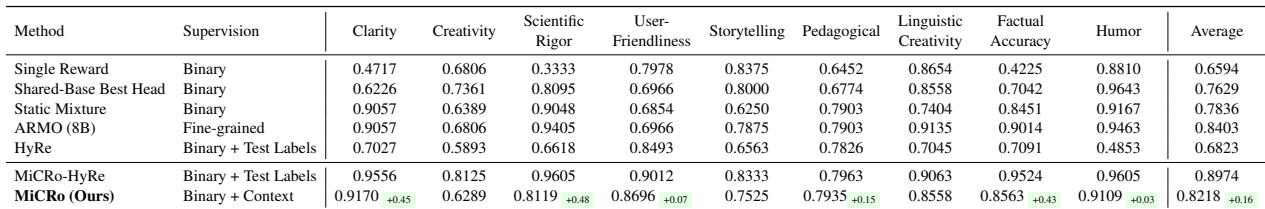
在 RPR 测试集的未见用户设置下,MiCRo 在使用 preference-700K 训练的二元标签基线中取得最强平均结果。它在清晰性,用户友好性,故事讲述和事实准确性上取得显著收益,而其他方法在教育学,语言创造性等某些维度上仍保持竞争力。在 HelpSteer2 上训练的模型通常平均成绩较低,这支持了上下文感知路由在跨用户分布迁移中的益处。MiCRo 在 preference-700K 组的二元标签基线中取得最佳平均分数。MiCRo 在清晰性,用户友好性,故事讲述和事实准确性上表现良好,并在幽默分数上并列最高。单头,共享基础和静态混合基线在教学质量,语言创造性和科学严谨性等属性上仍具竞争力。上下文感知路由可改善对未见用户的适应,而属性层面的差异表明某些偏好仍然更难学习。
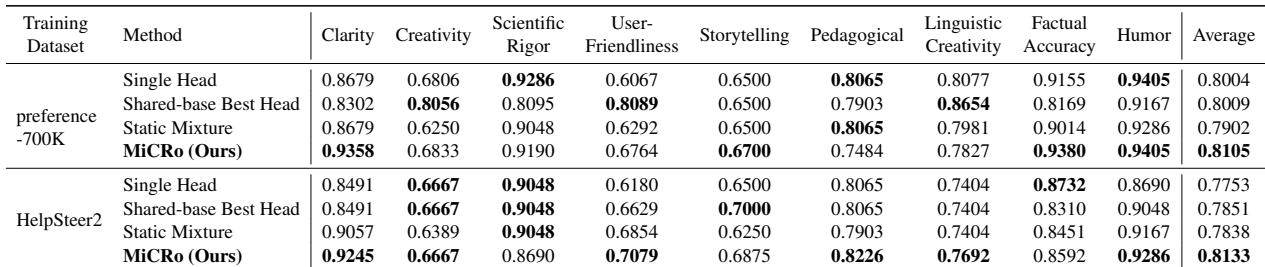
实验在 HelpSteer2 和 RPR 上评估 MiCRo,针对上下文感知奖励路由与单奖励,静态混合和更强监督基线进行比较。结果表明,上下文条件化有助于根据用户偏好调整奖励,改善个性化偏好学习,并在二元标签方法中取得强劲总体表现。额外的未见用户评估表明,上下文感知路由能够跨用户分布迁移,同时与使用更强监督的方法保持竞争力,尽管某些偏好维度仍然更难学习。