Command Palette
Search for a command to run...
LINGGYM:大语言模型离田野语言学家的思维方式还有多远?
LINGGYM:大语言模型离田野语言学家的思维方式还有多远?
Changbing Yang Franklin Ma Freda Shi Jian Zhu
摘要
本文提出了 LINGGYM,一个新的基准测试,用于评估大语言模型(LLM)的元语言推理能力。该基准基于从 18 部类型学上多样化的参考语法中提取的逐行注释文本(IGT)和语法描述。与以往聚焦于特定下游任务的工作不同,我们评估 LLM 能否在训练期间未见的低资源语言和结构上泛化其语言推理能力。我们提出了一项受控评估任务:词-注释推断,要求模型利用不同层次的语言信息(如注释、语法解释、翻译)从上下文中推断缺失的词及其注释。实验结果表明,引入结构化的语言线索能够在所有模型上带来推理性能的一致性提升。本工作凸显了将 LLM 用于类型学指导的语言分析以及低资源语言记录的前景与当前局限。
一句话总结
来自不列颠哥伦比亚大学、滑铁卢大学和向量研究所的研究人员推出 LINGGYM,该基准通过词与注释推断任务,基于来自 18 部类型学上多样语法的逐词行间注释文本评测 LLMs 的元语言推理能力,发现结构化语言线索能够稳定提升推理表现,但模型仍然难以泛化到未见过的低资源语言和结构。
核心贡献
- LINGGYM 是由 18 部类型学上多样的参考语法中的逐词行间注释文本和语法描述构建的基准,用于在未见过的低资源语言上评测 LLM 的元语言推理能力。
- 词与注释推断任务要求模型根据上下文推断缺失的词和注释,同时控制对注释、语法解释和翻译的访问。
- 对多个前沿 LLM 的实验表明,结构化语言线索能够稳定提升推理表现,并揭示类型学驱动的语言记录能力与局限。
引言
在语言记录、语言假设检验和类型学研究中,LLM 可以支持跨多样语言的形态、句法和语序分析。然而,多数模型评测仍聚焦英语和高资源数据,而先前的低资源 NLP 工具通常任务特定、局限于特定语言,或在过于干净和人为的实验条件下测试。作者利用参考语法中的逐词行间注释文本和显式语法解释,评测 LLMs 在低资源语言中执行元语言推理的能力。研究贡献包括经过人工核验的 18 种濒危和低资源语言数据集、基于带语法线索的词与注释推断的评测框架,以及关于前沿 LLM 能力和局限的类型学驱动分析。
数据集
-
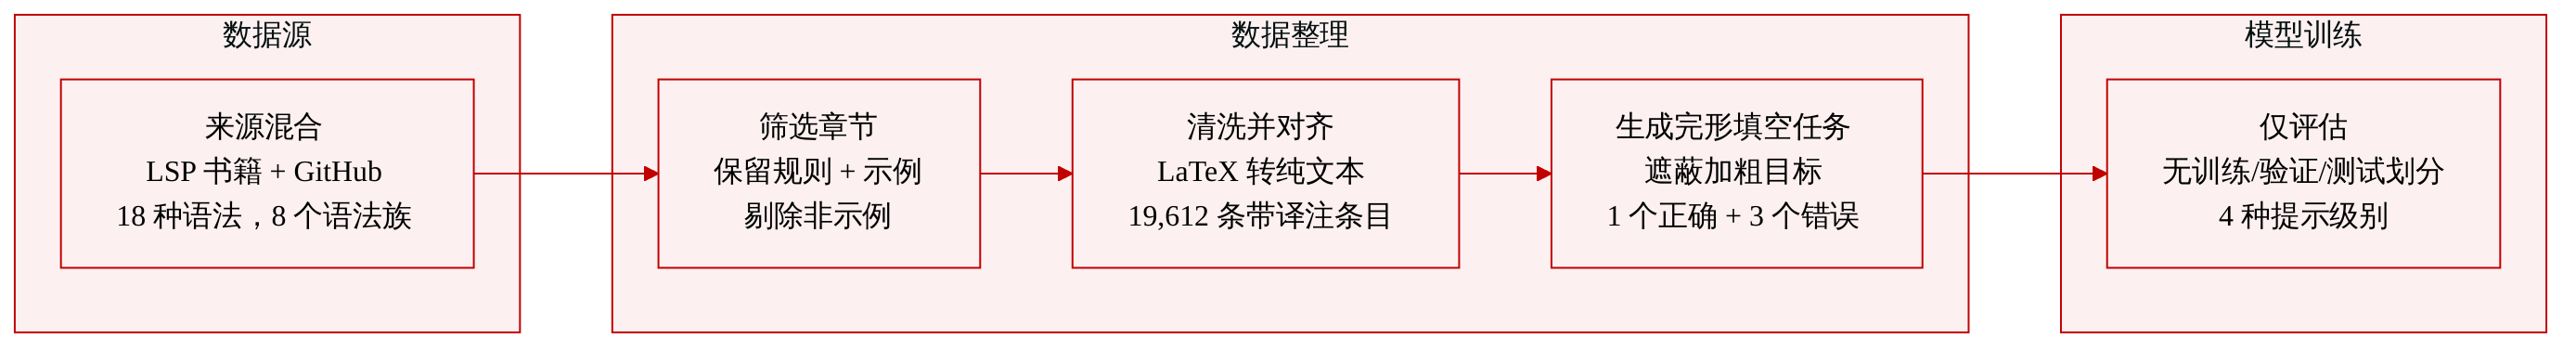
来源与构成:作者基于 18 部由 Language Science Press 出版的公开参考语法构建该基准,这些语法选自 Studies in Diversity Linguistics 和 Comprehensive Grammar Library 系列。这些书籍以 CC BY 4.0 发布,LaTeX 源文件从公开 GitHub 站点获取。
-
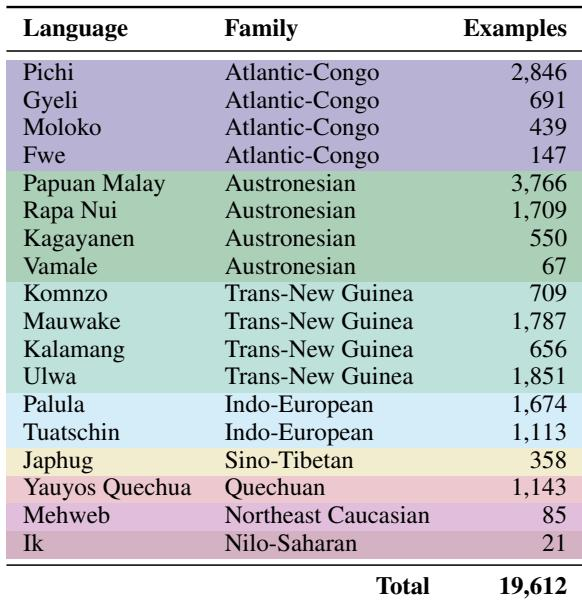
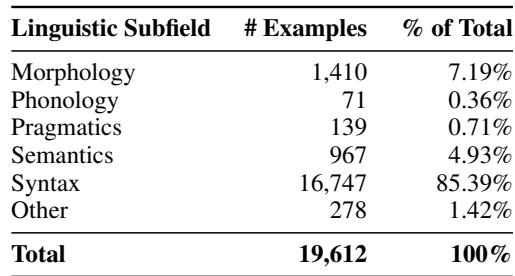
语言覆盖与规模:处理后的基准涵盖来自 8 个语系的 18 部语法,语言主要来自非洲和太平洋地区。经过过滤和清理后,基准包含 19,612 条与相关语法知识点相对应的逐词行间注释文本示例。
-
子集与子领域细节:章节被人工归类为音系学、形态学、句法学、语义学、语用学或其他语言学子领域。该基准覆盖主要语法描述领域,尤其侧重句法,这反映了常见的语言记录实践。
-
纳入与过滤规则:作者保留包含描述语法规则或语言内容的标记小节、并包含与规则解释相关联的逐词行间注释示例的章节。示例必须包含一个加粗的目标关键词,例如正在讨论的词、词素或形式。没有可用行间示例的章节,例如致谢或附录,会被排除;语音学章节也因行间内容稀疏和国际音标格式不一致而被排除。
-
提取与清理:LaTeX 文件被转换为纯文本,移除格式命令,同时保留标记语法重点的加粗关键词。对于每个示例,作者提取结构化的行间字段,包括适用时的转写、词素切分、注释和自由翻译,以及解释语法依据的前置知识点段落。作者还记录层级元数据:章标题、节标题和子节标题。
-
结构验证:自动提取后,示例经过人工清理,确保行间注释完整且对齐。词数必须与注释数一致;在每个词内,以连字符分隔的词素必须与注释一一对齐。使用切分词素行作为标准化语言输入,因为它提供更细粒度的语法单位和更好的注释对齐。
-
数据结构:每个基准条目围绕一个对齐的语言示例展开,并可包含切分词素的源句、注释信息、知识点、英文翻译以及层级源元数据。
-
问题构造:作者从清理后的示例中构造完形填空式的词或词与注释推断问题。目标由加粗标记识别。正确选项的一个答案和三个干扰项通过三种策略生成:与正确注释共享最长公共子串的基于形式的干扰项,由 Sentence-BERT 相似度选取的基于语义的干扰项,以及从同一语法章节中采样的章节局部干扰项。正确选项位置在四个选项间均匀随机化。
-
难度级别与用途:作者将该数据集用作评测基准,而非训练语料。未报告训练划分或混合比例。评测提示根据可用信息变化:仅表层句子、表层句子加注释、再加知识点、再加英文翻译。
-
裁剪与其他处理:未描述裁剪策略。主要处理步骤包括 LaTeX 转文本、结构过滤、人工章节分类、行间对齐验证、元数据构建、目标遮蔽和干扰项生成。
方法
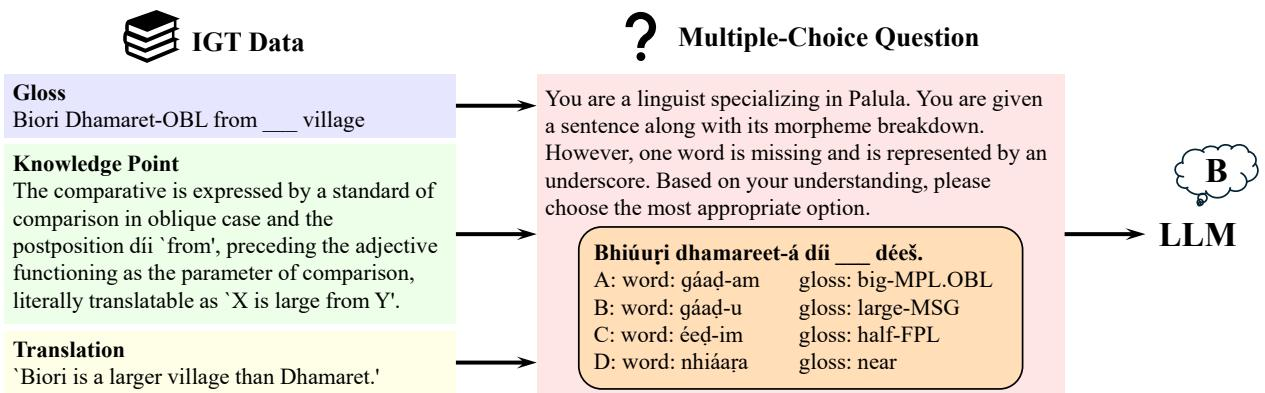
该方法围绕一个从清理后的逐词行间注释文本示例派生出的完形填空式、多项选择词/注释推断任务。每个示例被转换为一个提示,其中移除一个目标元素。目标可能是单个表层词、单个词与注释对,或缺失注释所要求的表面形式。模型必须结合切分句子、形态注释、可用语法解释以及可选英文翻译中的证据,从四个选项中恢复缺失元素。该设置评测 LLM 是否能从结构化语言数据中推断语法信息,而非仅仅识别高频表层形式。从 IGT 数据到问答评测的端到端转换如图所示。
问题构造过程首先识别每个示例中的目标词。如果该词本身或其任一词素在源表示中带有特殊注释,则该词被选为遮蔽目标。随后,流程生成一个正确候选项和三个干扰项。第一种干扰项策略基于形式。它选择一个与正确注释共享较长词汇或形态子串、但改变语法功能的注释。例如,与表示 walk 的词根搭配过去时注释的正确词与注释关联,可以与使用相同词根但使用进行体注释的替代项进行对比。第二种策略基于语义。使用 Sentence-BERT 对注释进行嵌入,并将语义上最相似但不相同的注释映射回数据集中的词。这会生成在细粒度意义上存在差异、而非仅在表层形式上不同的选项。第三种策略是章节局部。它从同一语法章节中采样词与注释对,同时确保候选项不与正确答案或其他干扰项重叠。这保留主题相关性,同时避免过于简单的排除。
候选生成后,系统强制四个选项具有唯一性,并随机化正确选项的位置。正确选项均匀分布在四个答案槽位中,因此每个位置大约 25% 的概率对应正确答案。这避免模型利用固定答案分布。随后通过对相关目标元素进行遮蔽来构建提示。对表层行的遮蔽在词级执行,以保持粒度一致。遮蔽也会应用于注释行,以及提及目标词或注释的知识点行。这保留局部上下文,同时清晰标记缺失信息。英文翻译行较难遮蔽,因为它常常释义目标,或使用语义相关表达,而非直接词汇对应。因此,表层行和注释行被系统控制,而翻译仍可能提供关于答案的间接线索。
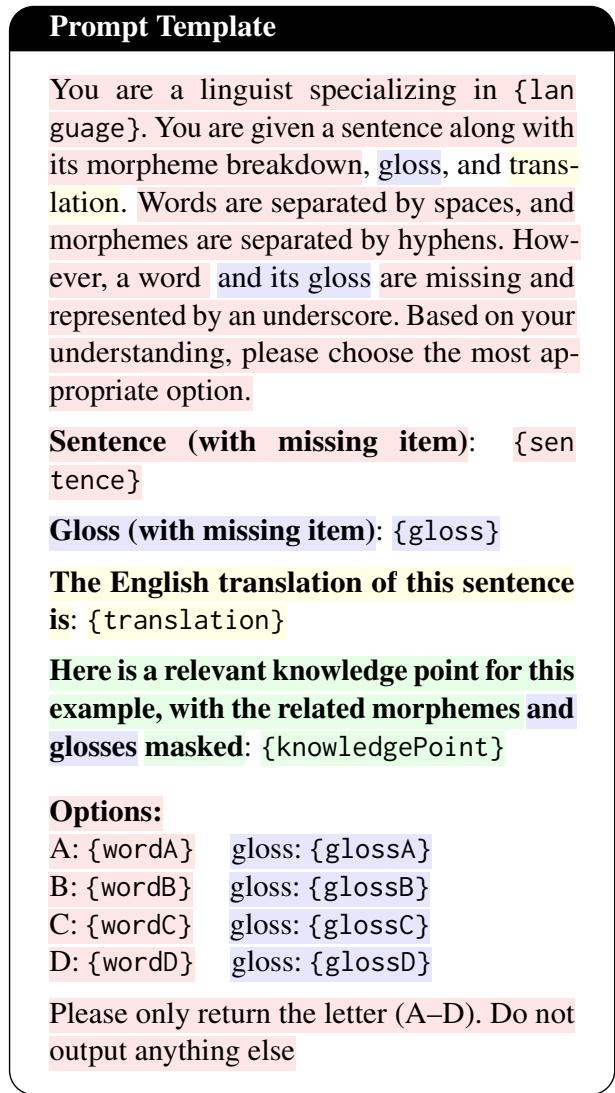
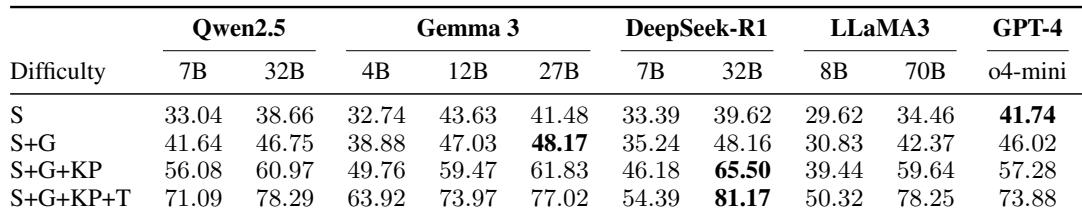
该基准通过四个难度级别进一步控制暴露给模型的语言信息量。最简单的输入仅包含原始切分词素句子,记作 S。下一级别增加注释信息,得到 S+G。第三级别增加相关语法知识点,得到 S+G+KP。信息最丰富的级别还增加英文翻译,得到 S+G+KP+T。这些条件用于分离更结构化或跨语言信息可用时,语法推理是否会提升。这些变体共享的提示模板包含语言角色设定、被遮蔽的目标语句子、被遮蔽的注释行、可选翻译字段、可选知识点字段并遮蔽相关词素和注释、四个词与注释选项,以及仅返回所选答案字母的指令。完整提示格式在框架图中概括。
实验
实验评测一个多项选择词与注释推断基准,该基准由来自许多代表性不足语言参考语法中的逐词行间注释示例构建。在多个开源模型族和逐渐增加的提示上下文中,结果显示语言模型能在专门的形态句法推理上显著超过随机水平,知识点、注释和翻译各自提供有用证据。模型在不同语言和语言学子领域之间表现相对稳定,但剩余错误揭示了对密集注释缩写、语义上合理的干扰项,以及细粒度音系或正字法区分的困难。
LINGGYM 数据集将知识点与来自八个语系的参考语法中的逐词行间注释文本对齐,并包含大量来自非洲和太平洋地区的代表性不足语言。按语言统计的示例数量差异很大,在列出的条目中,Papuan Malay、Pichi 和 Rapa Nui 较为突出。该数据集用于分析涉及不透明注释缩写、语义相似干扰项,以及最小形态或正字法差异的模型失败案例。覆盖范围包括八个语系,其中包括若干大西洋-刚果和南岛语系语言。列出的语言数量表明,少数语法贡献了比其他语法更大比例的对齐示例。当注释标签编码了必须解析而非猜测的密集语法信息时,即使很强的模型配置也会失败。模型错误常常源于选择英文翻译中看似合理、但不满足目标语形态的形式。
示例分布在多个语言学子领域,句法以明显优势占据最大比例。形态和语义是较小但显著的类别,而音系、语用和其他主题占比很低。这一模式反映了对句法描述的强烈关注,同时覆盖语言学结构的其他领域。句法示例主导整体分布。覆盖范围包括多个语言学子领域,其中音系和语用占比最少。
随着增加注释、知识点和翻译,各模型族的准确率稳步提升,最完整的提示设置取得最强结果。即便仅使用原始句子输入,每个模型也超过随机水平,这表明存在一定预训练暴露,但基准远未饱和。DeepSeek-R1 模型最强,但剩余错误集中在不透明注释标签、语义合理的干扰项,以及最小形式差异。仅原始句子输入已在所有评测模型上超过随机水平。知识点在不同模型族和参数规模上都能稳定提升准确率。更大、面向推理的模型通常优于较小模型,其中 DeepSeek-R1 32B 最强。持续错误包括未解析的注释缩写、形态句法上错误的同义词,以及细粒度正字法差异。
所选模型在向原始句子添加补充语言信息时表现出广泛提升,尤其是加入翻译时。知识点和注释也提升性能,但提升幅度因模型而异,Gemma3-12B 在包含翻译的组合中通常达到最高准确率。这一模式表明 LLM 可以使用部分上下文线索,但即使最好的配置在这个专门的元语言基准上仍留下很大提升空间。仅句子输入已经产生高于随机的性能,表明可能存在记忆,但并未完全掌握。添加翻译带来显著提升,尤其对 Gemma3-12B 和若干较小模型。包含知识点、注释或翻译的组合相比原始句子基线提高准确率,但没有配置接近完美表现。
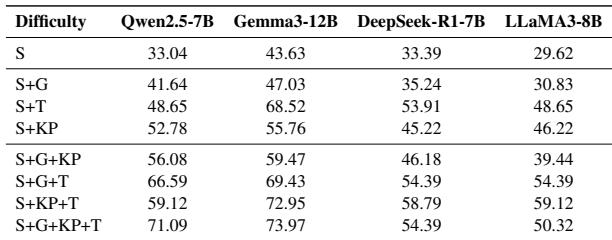
实验在 LINGGYM 基准上评测模型,该基准覆盖多个语系和语言学子领域中代表性不足的语言,使用原始句子以及逐渐丰富、包含注释、知识点和翻译的提示。结果显示模型因预训练暴露已经高于随机水平,而添加语言上下文通常改善性能,尤其是翻译以及面向推理或更大的模型。然而,在密集注释缩写、形态句法上合理但不正确的形式,以及细微正字法差异上的持续失败表明,针对专门语法的可靠元语言推理仍未解决。