Command Palette
Search for a command to run...
通过遗忘推理步骤度量思维链的忠实性
通过遗忘推理步骤度量思维链的忠实性
Martin Tutek Fateme Hashemi Chaleshtori Ana Marasović Yonatan Belinkov
摘要
当被要求逐步思考时,语言模型(LM)会生成一条思维链(CoT),即模型据称用于得出预测结果的一系列推理步骤。尽管已有大量关于 CoT 提示的研究,但 CoT 中所表述的推理是否忠实于模型的参数化信念仍不明确。我们提出了一个用于度量生成推理之参数忠实性的框架,并提出了该框架的一个具体实例——通过遗忘推理步骤度量忠实性(FUR)。FUR 从模型参数中擦除推理步骤所包含的信息,并将由此对模型预测产生的影响作为忠实性的度量。我们在四个语言模型和五个多跳多选问答(MCQA)数据集上的实验表明,FUR 通常能够通过遗忘关键步骤来精确改变模型对特定样本的预测,从而揭示 CoT 何时具备参数忠实性。进一步分析表明,经遗忘处理后模型生成的 CoT 支持不同的答案,这暗示了遗忘机制的更深层影响。
一句话总结
Technion 和犹他大学的研究人员提出 Faithfulness by Unlearning Reasoning steps(FUR),该方法从模型参数中遗忘推理步骤中的信息,以度量思维链的参数化忠实度;在四个语言模型和五个多跳 MCQA 数据集上的实验表明,遗忘关键步骤会经常改变预测结果,而遗忘后的 CoT 会支持不同答案。
核心贡献
-
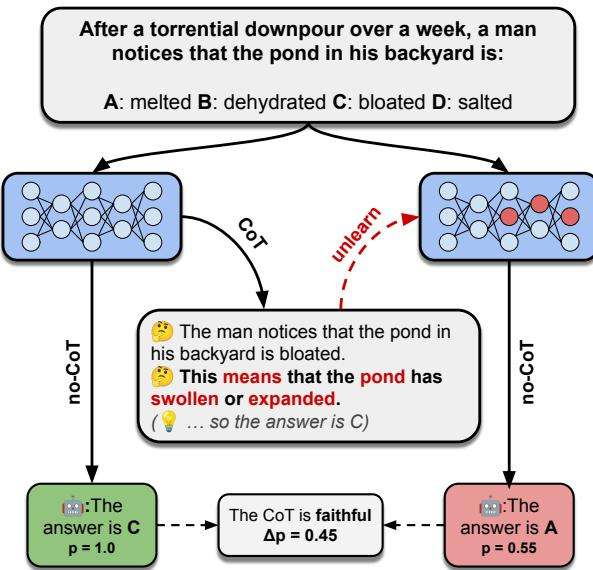
本文提出参数化忠实度框架(PFF)和 Faithfulness by Unlearning Reasoning steps(FUR),该方法通过遗忘从模型参数中擦除推理步骤信息,并根据由此对模型预测产生的影响来度量忠实度。FUR 使用生成的思维链来指导遗忘,同时在生成预测时不使用思维链,从而帮助区分参数影响与上下文提示。
-
该工作定义 FF-HARD 和 FF-SOFT 来量化思维链忠实度:FF-HARD 用于检验生成的思维链是否忠实,而 FF-SOFT 用于识别哪些推理步骤与模型预测最相关。
-
在四个语言模型和五个多跳多选问答数据集上的实验表明,遗忘关键步骤经常会改变模型预测,并使遗忘后的思维链支持不同答案;与此同时,被识别为高度相关的推理步骤并不总是被人类判断为合理。
引言
语言模型越来越多地使用思维链推理来解决复杂任务,并使输出更易于解释,但这些被表达出来的步骤是否真的揭示模型内部推理仍不清楚。以往研究通常通过扰动思维链中的 token 并检查预测是否变化来测试忠实度,但这主要度量的是上下文一致性,因为原始知识仍存在于模型参数中,并可在预测过程中被重构。作者提出一个参数化忠实度框架,直接干预模型参数,然后测试移除与推理相关的知识是否会改变最终答案。他们用一个名为 FUR 的机器遗忘方法实例化该框架,并提出 FF-HARD 和 FF-SOFT 指标,以评估整条思维链或单个推理步骤是否忠实于模型的底层预测。
数据集
-
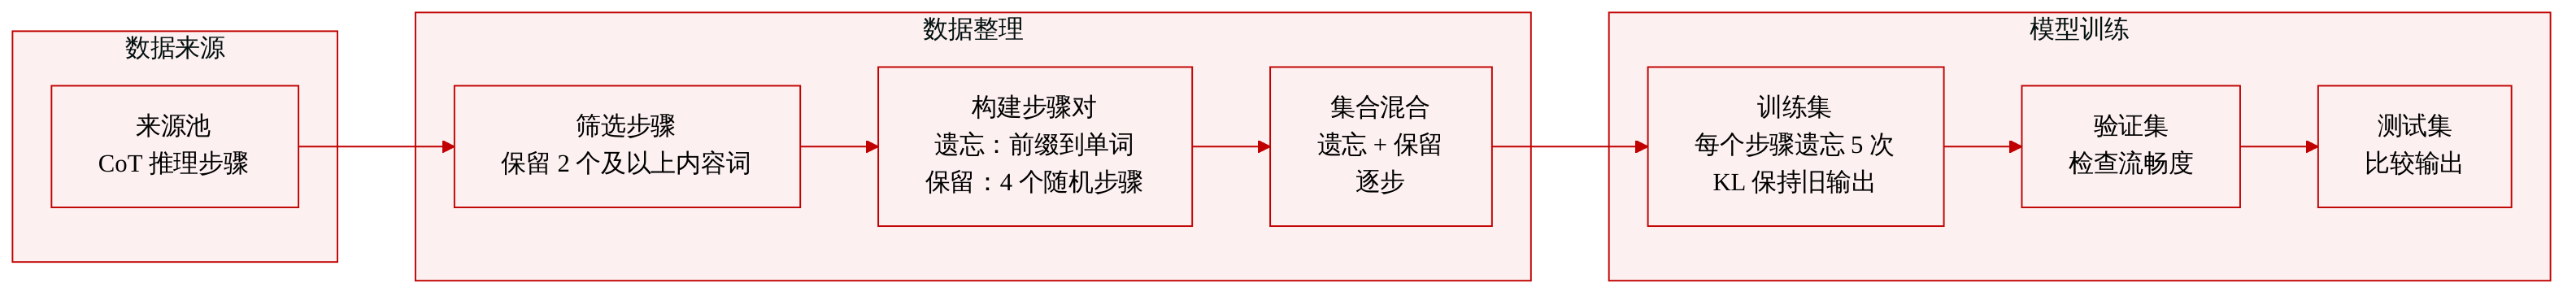
作者从用于遗忘的数据集中的思维链推理步骤构建干预数据集,而不是使用新引入的独立语料库。
-
来源池是包含 CoT 步骤的原始数据集,数据围绕单个推理步骤组织。
-
每个推理步骤在使用前会被过滤为包含至少两个内容词的完整句子。
-
对于每个目标推理步骤,遗忘集被构建为输入输出对。对于步骤中的每个内容词,输入是来自该词之前的前缀,输出是该内容词的 token 序列。
-
对于目标步骤,保留集从同一数据集中的四个其他实例中随机选取的四个 CoT 步骤构建,且这些步骤各自至少包含两个内容词。
-
保留数据将这些随机选取步骤中的内容词作为目标 tokens,同时通过 KL 正则化保留原始模型在这些上下文上的输出。
-
所得数据按步骤逐步使用:每个推理步骤分别进行五次遗忘迭代,其中遗忘集包含前缀和内容词输出,保留集包含来自不相关步骤的内容词目标。
方法
作者将参数化忠实度表述为一个两阶段实验流程。第一阶段针对模型参数,第二阶段评估生成的推理是否与存储在这些参数中的计算相关联。如框架图所示:
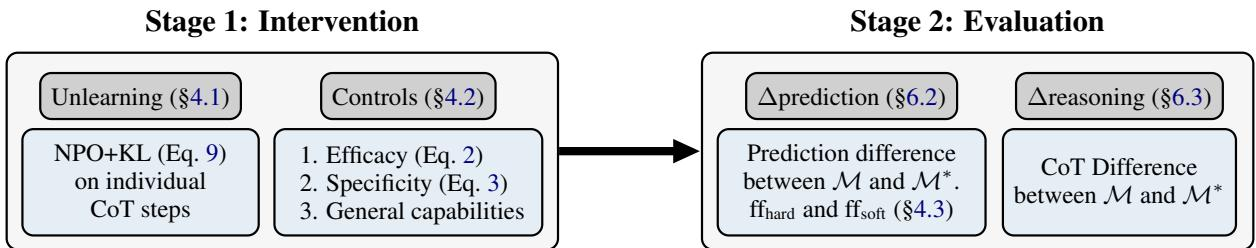
干预阶段首先提示原始模型 M 生成一条推理链。该推理链按照选定粒度被划分为若干推理步骤。每个步骤随后被视为参数级干预的目标。其目标不是改变可见提示或上下文,而是修改该推理步骤所表达的信息假定所在的参数。干预后,模型变为 M∗,或者在仅遗忘单个步骤时变为 M(i)∗。由于整个度量的成功取决于参数更新是否真正反映了预期的信息擦除,该框架还包含用于验证干预的对照设置。评估阶段随后比较原始模型与修改后的模型。作者考虑两种协议。第一种协议让两个模型直接回答,并通过其预测的变化推断忠实度。第二种协议让两个模型在回答前先生成推理,并通过推理内容的变化推断忠实度。核心直觉在于,如果被表达出来的推理忠实于内部计算,那么从参数中移除该计算应当产生可观察到的行为差异。
作者通过遗忘推理步骤来实例化该框架。对于每条生成的思维链,他们首先将包含至少两个内容词的句子识别为推理步骤。对于给定步骤,他们构造遗忘集 DFG,方式是取每个内容词,将到该词为止的前缀作为输入,并将该内容词对应的 tokens 作为输出。随后,模型被训练以降低这些目标补全的概率。为了保持通用流畅性并避免广泛退化,他们还从来自其他实例的其他思维链步骤中抽取内容词,构造保留集 DRT。保留损失鼓励遗忘后的模型在不相关的域内上下文中保留原始模型的行为。作者采用偏好优化遗忘的 KL 正则化形式,更新参数以降低被遗忘内容词的似然,同时通过 KL 散度项约束在保留内容词上的输出分布。
训练过程具有明确针对性。作者不微调所有参数,而只修改 Transformer MLP 块中的第二个前馈矩阵,将这些矩阵视为事实性或程序性知识可能的存储位置。对于每个推理步骤,干预运行五次遗忘迭代,每次迭代对应遍历一次遗忘集。在这种设置下,一个推理步骤被独立遗忘,产生一个修改后的模型 M(i)∗;如果原始推理忠实于内部计算,该模型在预测时就不应再依赖被擦除的步骤。
干预的有效性从三个维度检查:有效性、特异性以及通用能力保留。有效性度量目标推理步骤的概率在遗忘后下降的幅度。对于包含 T 个 token 且具有前缀 pfi 的推理步骤 ri,其在模型 M 下的长度归一化概率为
pM(ri)=T1j=1∑TpM(ri,j∣pfi,ri,<j).遗忘步骤 i 的有效性为
E(i)=pM(ri)pM(ri)−pM(i)∗(ri).该分数捕捉原始思维链步骤在参数干预后成为更不可能推理路径的程度。该分数经过有意归一化,作者指出,对应概率为零的完美有效性并不一定是理想目标,因为它可能损害流畅性。
特异性检查遗忘是否损害了从同一任务分布中抽取的不相关实例上的行为。作者使用留出集 Ds 比较遗忘前后的预测,并计算标签保持不变的比率:
S=∣Ds∣1k=1∑∣Ds∣1[yk=yk∗].该分数有助于区分有意义的知识擦除和广泛的模型退化。通用能力单独评估,在遗忘一部分推理步骤后使用 zero-shot MMLU 风格评估。作者不要求 MMLU 性能完全相同,但使用它来确认定向参数更新没有造成严重的整体损害。
在确认干预足够精确后,通过原始模型与修改后模型之间的行为差异来度量忠实度。硬度量回答是否存在某个被遗忘的步骤能够翻转最可能的最终答案:
ffhard=1[∃ri such that y=y(i)∗].这为完整推理链产生一个二元忠实度信号。如果从模型参数中移除步骤 ri 会改变最终预测,则该步骤可被视为与原始答案存在因果关联。硬度量通过比较遗忘某一步骤前后模型赋予原始答案的概率,为每个步骤赋予一个连续值:
ffsoft(i)=p(y∣M)−p(y∣M(i)∗).该分数识别哪些推理步骤承载了更大份额的预测证据。硬分数被解释为真实忠实度的下界,因为当模型依赖多条有效推理路径时,或干预未能完全定位因果存储位置时,某些忠实步骤仍可能不会改变最终答案。
为了使干预在更长推理链和更大模型上可行,作者探索了遗忘更新的参数高效变体。他们不更新完整的第二个前馈矩阵,而是在相同目标矩阵上应用 LoRA 适配。这减少了活跃可训练参数的数量,同时保持干预的局部性。完整更新与 LoRA 秩 8、32 和 128 的比较如下图所示:
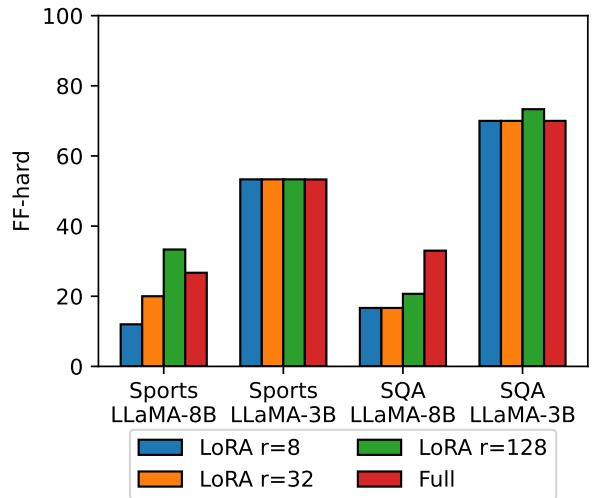
比较报告了完整微调和 LoRA 变体的 FF-HARD 分数。该部分设计展示了核心参数干预如何通过将遗忘限制在原本将被更新的相同架构组件的低秩子空间中,从而降低内存成本。
实验
实验在多个数据集和指令微调模型上使用 zero-shot 多选题问答,以衡量遗忘选定的思维链步骤是否能减少目标信息,同时保持留出集准确率和通用模型能力。这些控制实验表明遗忘干预是精确的;进一步分析表明,它经常同时改变预测和被表达出来的推理,而与上下文扰动基线相比,更强的遗忘通常表示更高的忠实度。步骤级分析和人类评估显示,对预测影响最大的步骤并不总是被视为最合理;初步的扩展实验则表明低秩适配可能使该方法更具实用性。
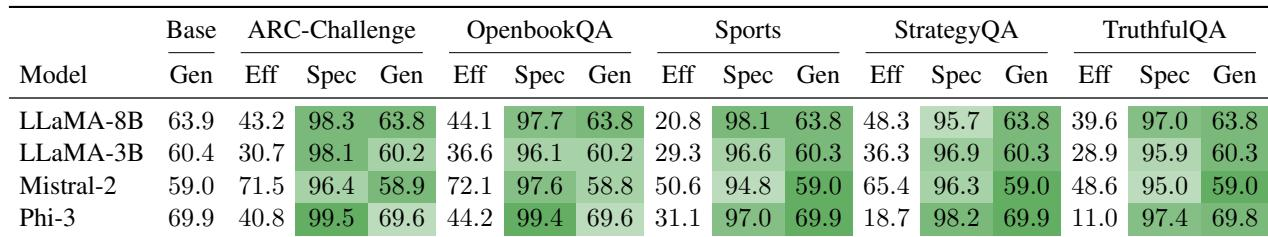
结果表明,遗忘会降低分配给目标思维链步骤的概率,同时使留出集一致性和遗忘后的 MMLU 准确率基本保持稳定。有效性因数据集和模型而异,在部分任务上下降更明显,在另一些任务上下降较弱,但模型通常能保留特异性和通用能力。遗忘能够有效降低对目标推理步骤的置信度,同时不会显著损害留出集一致性或通用 MMLU 准确率。Mistral-2 在多个数据集上表现出相对较强的下降,而 Phi-3 保持最高的基线 MMLU 准确率以及遗忘后的 MMLU 准确率。在 StrategyQA 和 TruthfulQA 上有效性最不稳定,其中一些模型的下降幅度远小于 ARC Challenge 或 OpenbookQA。
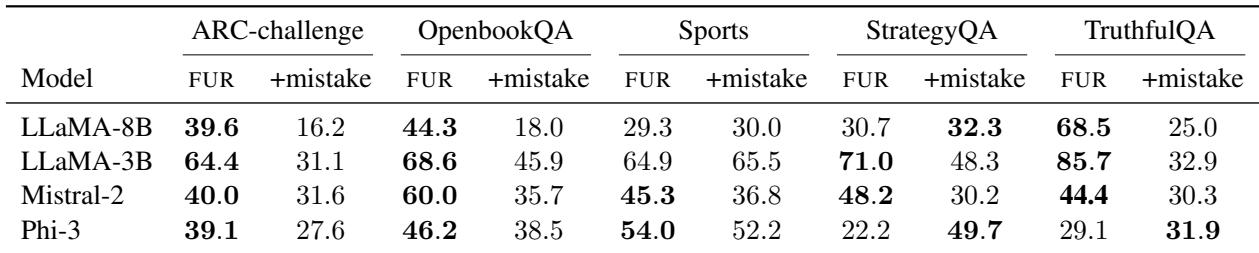
在所有被评估的模型和数据集中,从推理步骤中移除信息比在该步骤中引入错误更频繁地改变模型答案,这表明参数化遗忘比上下文错误注入能更广泛地识别忠实推理链。在两种干预下,结果仍显示出有意义的预测变化,并存在某些数据集特定情况,其中添加错误的表现相当甚至更高,这可能是由于实例之间存在知识重叠。遗忘一个推理步骤比向该步骤添加错误更频繁地导致答案改变。两种干预都会在思维链预测与直接预测一致的实例上产生显著的预测变化。更强的遗忘与更频繁的预测变化相关联,支持生成的思维链通常忠实的观点。
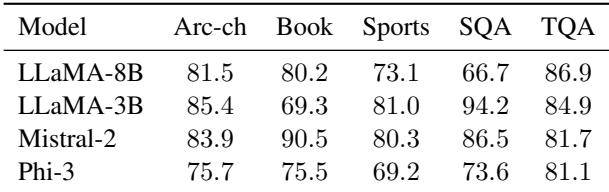
遗忘后,思维链推理经常支持不同于基线模型原始预测的答案,这表明干预改变了被表达出来的推理,而不仅仅是表面输出。这一趋势出现在所有被评估的模型和数据集中,大多数多数率远高于随机水平,尽管某些基准和模型组合的偏移幅度较小。该模式表明,在大多数测试设置下,遗忘能够传播到下游推理依据。遗忘后的推理通常会偏离基线模型的原始答案,在两种模型规模和所有基准类别中均观察到推理变化;某些数据集和模型表现出的推理偏移相对较弱。
实验在不同模型和数据集上评估了对目标思维链步骤的参数化遗忘,表明它会降低对特定推理的置信度,同时保持留出集一致性和通用 MMLU 准确率,并且有效性依赖于模型和数据集。作者还进一步将遗忘与上下文错误注入进行比较,发现移除推理步骤信息能更可靠地改变最终预测,这支持了生成推理链的忠实性和遗忘的特异性。最后,遗忘后的解释经常偏离原始答案,表明该效果通过被表达出来的推理传播,而不仅仅是改变表面输出。