Command Palette
Search for a command to run...
Generative or Discriminative? Revisiting Text Classification in the Era of Transformers
Generative or Discriminative? Revisiting Text Classification in the Era of Transformers
Siva Rajesh Kasa Karan Gupta Sumegh Roychowdhury Ashutosh Kumar Yaswanth Biruduraju Santhosh Kumar Kasa Nikhil Priyatam Pattisapu Arindam Bhattacharya Shailendra Agarwal Vijay Huddar
摘要
The comparison between discriminative and generative classifiers has intrigued researchers since Efron (1975)'s seminal analysis of logistic regression versus discriminant analysis. While early theoretical work established that generative classifiers exhibit lower sample complexity but higher asymptotic error in simple linear settings, these trade-offs remain unexplored in the transformer era. We present the first comprehensive evaluation of modern generative and discriminative architectures—Auto-regressive, Masked Language Modeling, Discrete Diffusion, and Encoders for text classification. Our study reveals that the classical "two regimes" phenomenon manifests distinctly across different architectures and training paradigms. Beyond accuracy, we analyze sample efficiency, calibration, noise robustness, and ordinality across diverse scenarios. Our findings offer practical guidance for selecting the most suitable modeling approach based on real-world constraints such as latency and data limitations.
一句话总结
亚马逊公司提出了对生成式(自回归、掩码语言建模、离散扩散)和判别式(编码器)Transformer 架构在文本分类中的首次全面评估,揭示出经典的“两种机制”现象在不同架构和训练范式下表现出明显差异,并针对延迟和数据限制等现实约束提供了模型选择指导。
核心贡献
-
该论文对现代生成式和判别式架构在文本分类中的表现进行了全面评估,涵盖自回归模型、掩码语言建模、离散扩散和编码器。研究考察了准确率、样本效率、校准、噪声鲁棒性和有序性。
-
比较包括伪生成式 Transformer 变体,包括带标签后缀的掩码语言建模和追加标签表述,表明对标签位置或损失函数的微小改动即可使标准架构处于可比较的设置下。
-
实验表明,样本复杂度和渐近误差之间的经典权衡在不同模型家族和训练范式下以不同方式显现。由此得到实用指导:在延迟敏感场景中,1 层编码器高效、鲁棒、校准良好且具有有序性;在数据丰富的离线任务中,12 层掩码语言模型在 F1、校准和有序指标上表现最佳,但对 token dropping 的鲁棒性较低;离散扩散在低资源噪声场景中表现强劲,尤其是在 6 层时;当校准概率输出至关重要时,自回归模型更受青睐。
引言
作者研究文本分类中的判别式与生成式之争,这是用于情感分析、主题分类和情绪检测的核心 NLP 任务。基于 Transformer 的判别式分类器表现强劲,但通常需要大量标注数据,而生成式分类器通过建模联合数据分布可能更具数据效率,因此在低资源场景中具有吸引力。
先前工作主要使用表格数据或较早的神经架构(如 LSTM)比较这些方法,Transformer 时代的现代比较仍然有限。既往研究也主要关注分类准确率和样本量,使重要部署问题仍未充分探索,例如模型缩放、校准、对噪声输入的鲁棒性,以及类间有序关系的保持。
作者贡献了 Transformer 时代首个判别式编码器和生成式文本分类器的大规模比较,包括自回归模型、离散扩散和掩码语言建模。他们在多个基准数据集、模型规模和训练设置上评估这些方法,随后根据数据可用性、延迟、鲁棒性和概率校准要求提供模型选择的实用建议。
数据集
-
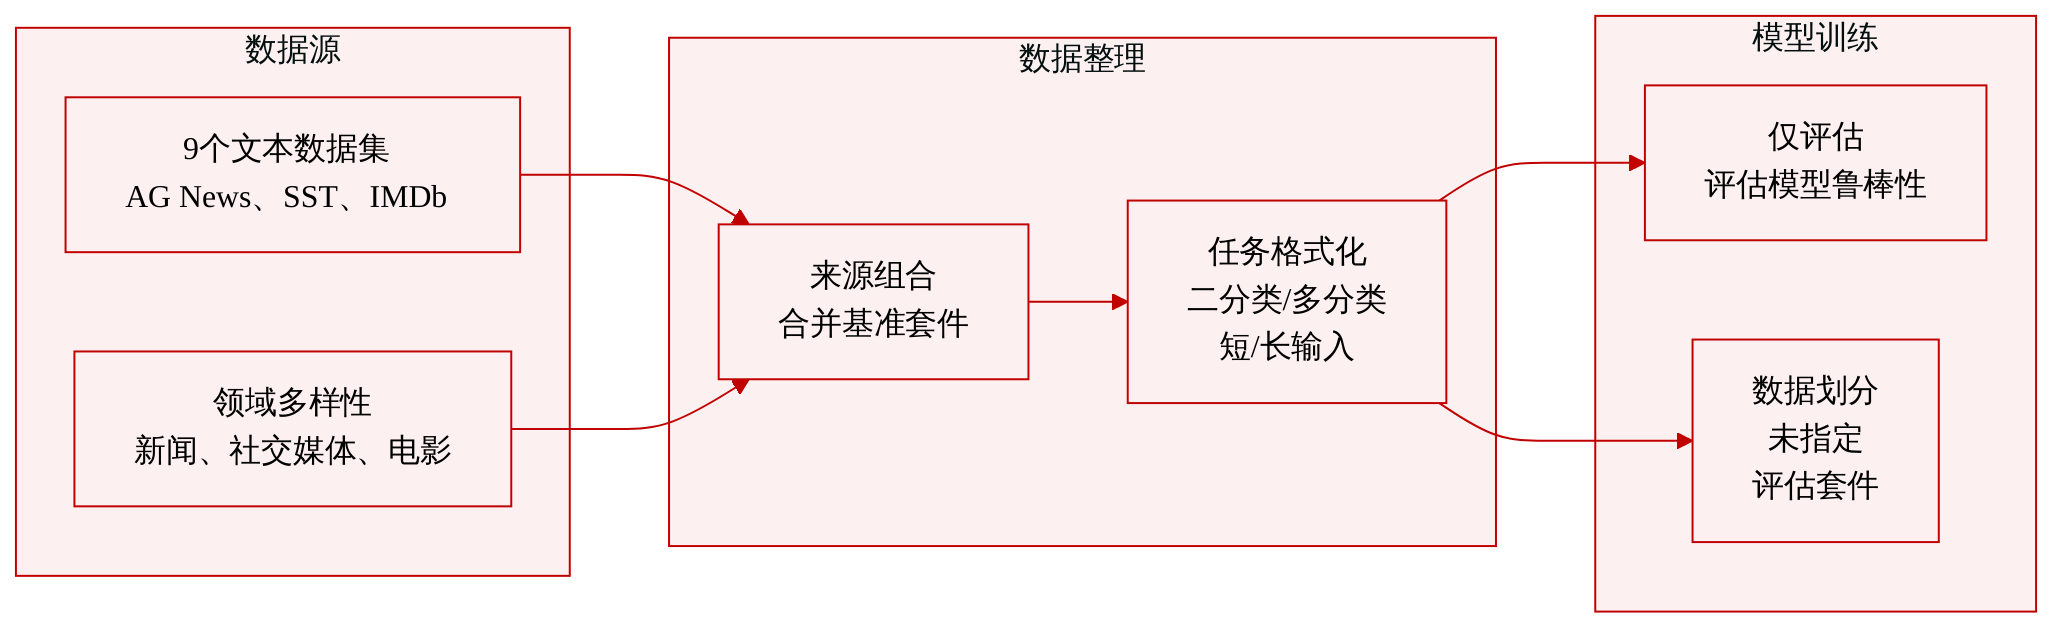
作者在九数据集基准套件上评估模型:AG News、Emotion、Stanford Sentiment Treebank(SST2 和 SST5)、Multiclass Sentiment Analysis、Twitter Financial News Sentiment、IMDb 和 Hate Speech Offensive。
-
数据集用于测试跨领域和任务类型的鲁棒性,包括情感分析、电影评论分类、新闻分类,以及社交媒体或金融消息分析。
-
基准涵盖不同分类设置,从二分类任务到细粒度多分类任务,包含短句子级输入和较长段落级文本。
-
在给定摘录中,数据集被描述为评估套件,而非训练混合;作者使用它来评估多个分类领域的模型性能。
-
摘录未提供各子集大小、训练集验证集测试集划分、过滤规则、schema 定义、类分布、其他统计信息、裁剪策略或元数据构造细节;这些内容据称在附录 C 中提供。
方法
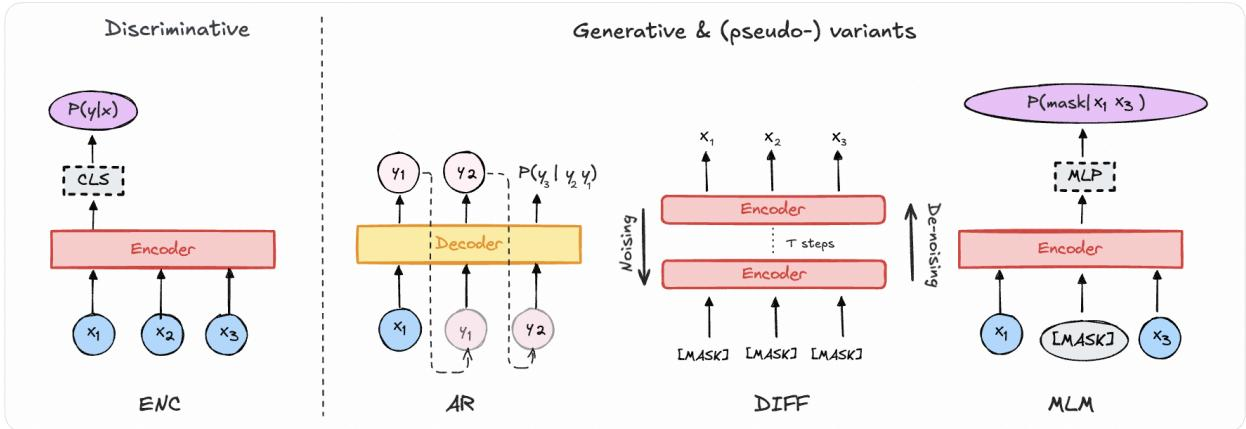
作者将文本分类表述为判别式与生成式语言建模范式的比较。给定数据集 D={(Xi,yi)}i=1N,其中 Xi=xi1,…,xin 是来自词汇表 V 的输入序列,yi∈Y 是离散类标签,判别式模型直接学习条件分布 P(y∣X),而生成式模型首先学习序列与标签上的联合或伪联合分布,然后通过计算候选标签似然或掩码标签预测来推断标签。
对于判别式架构,方法采用标准 Transformer 编码器设置。编码器 fθ 将输入文本映射为 d 维隐藏表示,
hi=fθ(Xi).线性分类头 W∈R∣Y∣×d 将该表示转换为类分数。预测标签分布通过 softmax 层获得,
y^i=softmax(Whi),训练最小化交叉熵目标
Lenc=−i=1∑NlogP(yi∣Xi).该分支代表常规编码器分类流程,其中标签不是作为序列一部分生成,而是从最终文本嵌入中预测。
生成式一侧包括三个主要变体:掩码语言建模、自回归建模和离散文本扩散。它们都将分类表述为序列建模或序列重建问题,并把标签 token 插入输入模板。
对于掩码语言建模,输入首先被扩展为结构化序列。在训练期间,作者构造
Xi′=[CLS]Xi[SEP]"The label is".标签 token yi 被附加,得到一个同时包含原始文本 tokens 和标签 token 的序列。随后对一部分 tokens(通常为 15%)应用标准掩码,模型使用双向上下文预测被掩码 tokens。训练目标为
Lmlm=−i=1∑Nj∈Mi∑logP(xij∣Xi′⊕yi\j),其中 Mi 是被掩码位置的集合,Xi′⊕yi\j 表示仅位置 j 被掩码的输入。由于掩码预测目标可解释为去噪或伪似然替代目标,作者将 MLM 置于更广泛的生成式家族中。推理时,标签被移除并替换为掩码:
Xi′=[CLS]Xi[SEP]"The label is"[MASK].模型预测被掩码标签位置的 token 概率。然后将输出空间限制到有效标签词汇表 VY,并将对应 token 概率重新归一化以产生类概率。
对于自回归分类,方法训练一个因果语言模型,以最大化完整标签加输入序列的似然。训练使用下一 token 预测损失
Lgpt=−i=1∑Nj=1∑LilogP(xij∣y,xi1,…,xij−1),其中 Li 是序列长度。推理时,作者对每个候选标签 y∈VY 执行一次前向传播,将该标签作为前缀添加到输入序列,并计算给定标签下文本的对数似然。最终预测为
y^=argy∈VYmaxlogP(X∣y).这相当于对所有可能标签进行完整似然评估。作者还讨论了伪生成式自回归变体,其中标签不是在输入前添加,而是在输入后追加。在该设置中,只需一次前向传播,模型直接生成标签 token。标签位置主要影响具有从左到右注意力的因果架构;对于 MLM 或基于扩散的模型等双向架构,它没有可比的理论效应。
文本扩散分支为每个输入与标签对定义模板序列:
Xi=Xi[SEP]"The label is"yi.与图像扩散逐渐添加高斯噪声不同,前向过程通过用纯噪声替换 tokens 来破坏离散文本,纯噪声由特殊符号 [MASK] 表示。该破坏过程通过具有转移矩阵 Qt 的连续时间马尔可夫过程建模,
dtdpt=Qtpt,p0=pdata,其中每个 token 位置在时间步 t∈[0,T] 上被独立破坏,直到序列完全掩码。
反向过程学习从被破坏序列重建原始 tokens。它建模如下形式的得分比率
sθ(x,t)z=pt(x)pt(z),其中 x 和 z 是词汇表 tokens。反向时间动力学定义为
dtdpT−t=sθ(x,t)zQT−tpT−t.为了以可处理的方式训练得分模型,作者使用去噪得分熵,
LDSE=Ex0∼p0,x∼p(⋅∣x0)z=x∑wxz(sθ(x)z−p(x∣x0)p(z∣x0)logsθ(x)z),其中 p 被视为基础密度 p0 的扰动,wxz>0 是加权项。该目标通过 ELBO 风格关系提供了负对数似然的上界,
−logp0θ(x0)≤LDWDSE(x0)+constant.推理时,扩散模板中的标签 token 被掩码,模型从完全掩码或部分掩码序列预测对应 token,并且输出被约束到 VY 中的有效标签 tokens。
实验
实验在九个基准上评估五种文本分类范式,跨越数据规模和模型规模,同时测试对 token corruption 的鲁棒性,以及校准或有序性。结果显示,最佳方法强烈取决于模型容量和数据量:紧凑判别式 ENC 在小模型上更有效,生成式扩散和自回归方法在低数据场景中有帮助,而伪生成式 MLM 在大模型拥有充足数据时表现优异。噪声测试显示扩散模型通常鲁棒,自回归模型更敏感;校准结果显示判别式和伪生成式模型在面向部署的设置中可能可靠。预训练进一步有利于判别式模型,并减少了生成式方法观察到的数据规模优势。
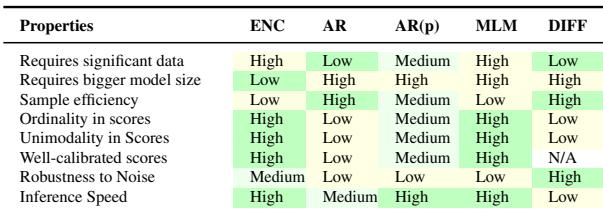
该比较将判别式和生成式文本分类方法框架化为数据需求、模型大小、样本效率、分数结构、校准和噪声鲁棒性方面的不同权衡。ENC 在多项分数质量属性上更受青睐,并需要更少数据和更小模型;AR 和 DIFF 更样本高效,DIFF 对噪声尤其鲁棒。实验背景补充说,在低数据场景中,AR 在校准和有序行为上是更可靠的生成式选项,预训练会降低生成式模型典型的低数据优势。在表格比较中,ENC 结合了较低数据和模型规模需求,以及更强的有序性、单峰性和校准。AR 和 DIFF 提供更高样本效率,而 DIFF 还提供更强噪声鲁棒性,但分数有序性和校准较弱。在低数据训练中,AR 在训练校准上比 pseudo-AR 更可靠,比 DIFF 更具有序性,而预训练 ENC 在所有范围上均优于 AR。
在随机 token dropping 下,较高值表示模型在给定 weighted-F1 下降前可容忍更多被丢弃的 tokens,并且随着可容忍下降增大,所有方法都需要更多噪声。在 6 层方法中,DIFF 在中等和更大下降阈值下是最强的鲁棒性信号,AR 也具有竞争力。在 12 层比较中,ENC 在测试阈值上始终高于 AR-pseudo,并比其 6 层变体更鲁棒,这表明架构缩放可将优势转向 ENC。在随机 token dropping 下,DIFF 提供了最鲁棒的 6 层性能。当从 6 层扩展到 12 层时,ENC 比 AR-pseudo 更鲁棒。
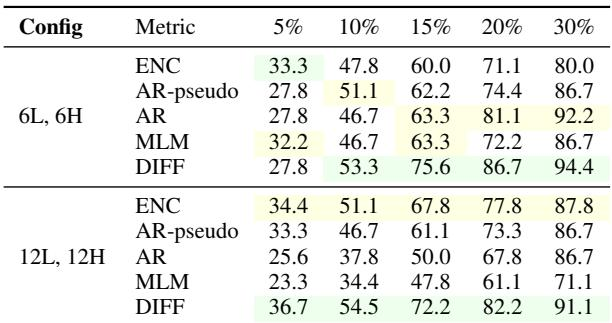
在随机 token 替换下,结果表明架构选择影响输入噪声鲁棒性。ENC 始终需要更多噪声才能令 weighted-F1 下降给定幅度,而 AR-pseudo 鲁棒性较低,并在更低噪声水平下从峰值下降。这表明当测试数据可能包含 token 级扰动时,ENC 是更可靠选择,尤其是在较小模型设置中。ENC 在不同 weighted-F1 下降阈值下表现出最高噪声容忍度。AR-pseudo 对随机 token 替换比 ENC 更敏感。
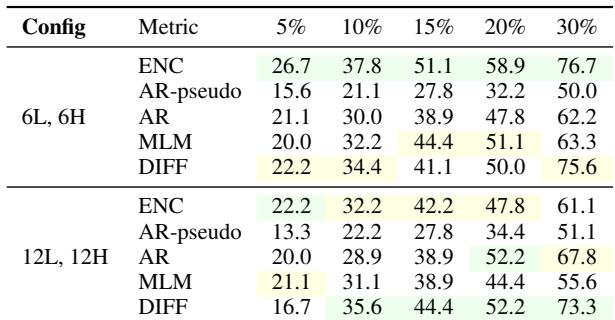
实验比较判别式和生成式文本分类器,包括 ENC、AR 和 DIFF,关注数据效率、模型大小、校准、有序分数行为,以及对 token 级噪声的鲁棒性。ENC 在分数质量、校准,以及更低数据和模型规模需求方面更受青睐,而 AR 和 DIFF 提供更好样本效率,DIFF 在较小模型中对随机 token dropping 尤其鲁棒。将 ENC 从六层扩展到十二层提高了其相对于 AR-pseudo 的鲁棒性,而 ENC 通常比 AR-pseudo 更能容忍随机 token 替换,因此当分数结构和噪声可靠性均重要时,预训练 ENC 是强选择。