Command Palette
Search for a command to run...
DiscoSG:通过迭代图精化实现篇章级文本场景图解析
DiscoSG:通过迭代图精化实现篇章级文本场景图解析
Shaoqing Lin Chong Teng Fei Li Donghong Ji Lizhen Qu Zhuang Li
摘要
视觉-语言模型(VLM)能够生成篇章级的多句视觉描述,这对面向单句描述到图映射的文本场景图解析器构成了挑战。现有方法通常将句级解析结果拼接以处理篇章输入,往往忽略跨句指代消解等现象,导致生成的场景图碎片化,进而降低下游 VLM 任务的性能。我们提出了一项新任务——篇章级文本场景图解析(DiscoSG),并发布了 DiscoSG-DS 数据集,包含 400 对专家标注和 8,430 对合成的多句描述-场景图配对数据。每条描述平均包含 9 个句子,每张场景图至少比现有数据集多出 3 个三元组。在 DiscoSG-DS 上微调 GPT-4o 可获得比最优句级拼接基线高出 40% 以上的 SPICE 指标,但其高昂的推理成本和许可限制阻碍了开源应用。较小的微调开源模型(如 Flan-T5)在简单图上表现尚可,但在更密集、更复杂的图上性能明显下降。为弥合这一差距,我们提出了 DiscoSG-Refiner,一种轻量级开源解析器,先生成种子图,再通过一种新颖的可学习图编辑模型对其进行迭代精化。该方法的 SPICE 指标比基线高出 30%,推理速度比 GPT-4o 快 86 倍。它能够从简单图泛化到密集图,从而持续改进下游 VLM 任务,包括篇章级描述评估和幻觉检测,性能优于其他开源解析器。代码和数据可在 https://github.com/ShaoqLin/DiscoSG 获取。
一句话总结
来自武汉大学、蒙纳士大学和皇家墨尔本理工大学的研究人员提出了 DiscoSG-Refiner,一种用于语篇级场景图解析的轻量级开源解析器。该解析器先生成种子图,并通过可学习的图编辑模型迭代修正,较基线方法 SPICE 提高 30%,较 GPT-4o 推理速度快 86×,同时提升下游 VLM 描述评估与幻觉检测表现。
核心贡献
-
论文提出 DiscoSG,这是一个语篇级文本场景图解析任务,并发布了 DiscoSG-DS 数据集。该数据集包含 400 个专家标注示例和 8,430 个合成的多句描述-图对。每个描述平均包含 9 句,每个图至少比现有数据集中的图多 3 个三元组。
-
论文提出 DiscoSG-Refiner,这是一个 0.5B 参数的开源迭代解析器。它先生成种子图,再使用在 DiscoSG-ED 上训练的可学习图编辑模型进行修正。DiscoSG-ED 是由 DiscoSG-DS 派生出的编辑操作合成语料。该模型在简单图和稠密图上的 SPICE 比最佳句子级合并基线高 30%,同时推理成本显著低于微调后的 GPT-4o。
-
论文建立了 D-FOIL 基准,该基准由 200 对幻觉多句描述和人工修正描述构成,用于语篇级幻觉检测。相比句子级合并解析器和端到端 Flan-T5 解析器,DiscoSG-Refiner 提升了下游 VLM 任务表现,包括语篇级描述评估和幻觉检测。
引言
文本场景图解析将视觉描述转换为包含实体及其关系的图结构,支持图像描述评估、幻觉检测和图像检索等任务。这一问题变得更加紧迫,因为视觉语言模型现在会生成包含跨句指代、长程依赖、隐式关系,并要求全局图一致性的多句描述。现有句子级解析器和启发式合并方法常常忽略这些语篇现象,而微调大型模型速度慢、成本高并受到许可限制,小型模型则会在稠密图和下游视觉语言任务上性能下降。作者定义了 DiscoSG 任务,发布了包含 400 个专家标注示例和 8,430 个合成描述-图对的 DiscoSG-DS 数据集,推出了用于语篇级幻觉检测的 D-FOIL 基准,并提出 DiscoSG-Refiner。该轻量级迭代修正框架由在合成编辑操作上训练的 Flan-T5 编辑器构建,可更高效地生成连贯场景图。
数据集
-
作者提出 DiscoSG-DS,这是一个语篇级场景图数据集。其中每个示例将一段多句图像描述与一个场景图配对。描述包含上下文依赖句,图以结构化三元组表示对象关系,例如 man, wear, hat,以及属性,例如 hat, has_attribute, red。
-
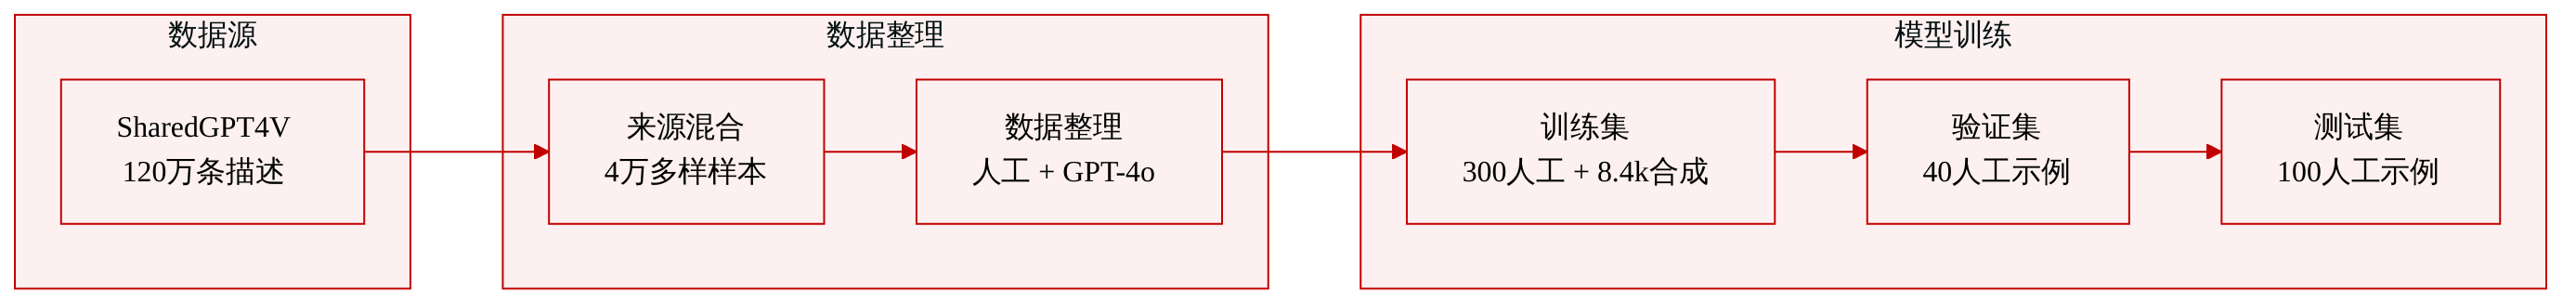
来源池来自 SharedGPT4V,这是一个约 120 万条 GPT-4 生成图像描述的集合。作者使用 TF-IDF 文本嵌入和多样性采样从其中选择 40,000 个多样化图像-描述对,然后将所选示例分别用于人工标注或合成标注。
-
人工金标准子集包含从 40,000 个候选描述-图对中随机选出的 400 个已标注示例。标注采用人机协同的主动学习流程。标注人员先生成 FACTUAL-MR 中间标注,再转换为最终场景图,并解决跨句指代、量词不一致、长程关系、隐式关系、语义矛盾以及经图像验证的幻觉。
-
在人工流程中,使用 102 条初始描述,由句子级解析生成草图。其中 40 个示例保留为固定验证集,62 个示例构成种子训练集。两轮主动学习从 94 和 204 个示例的批次中加入经修正的人工校正,将训练池扩展到 360 个示例。随后,验证集与训练集合并,并使用 400 个人工标注图生成 300 个训练示例和 100 个测试示例,文中将其描述为两个 300/100 训练测试划分。
-
合成子集包含 8,430 个示例。作者首先使用 GPT-4o 将描述与其对应图像比较,过滤掉易产生幻觉的描述。然后使用在 300 个人工标注训练示例上微调的 GPT-4o 教师模型对剩余描述进行标注。
-
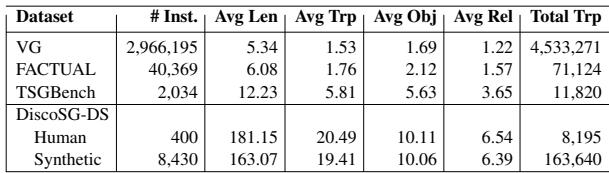
最终数据集包含 300 个人工标注训练示例、100 个人工标注测试示例和 8,430 个合成示例。描述平均包含 9.3 句。每个图比 Visual Genome 或 FACTUAL 示例大约多 15 个三元组,比 TSGBench 示例多 3 个三元组,反映出更长的语篇跨度和更复杂的关系结构。
-
为支持下游使用,作者从 DiscoSG-DS 派生出带编辑标注的数据集 DiscoSG-ED。对于每个人工标注实例或合成实例,比较生成图与金标图,生成真实删除和插入标注。同时还通过随机删除或插入金标图中的三元组创建额外编辑目标。每个训练项变成描述、初始图、删除标记和插入序列的元组。对每个金标图进行 N 次扰动时,DiscoSG-ED 的规模可扩展到 DiscoSG-DS 的 N 倍。
方法
该方法将可扩展的标注流程与面向语篇级场景图解析的三模块修正架构相结合。核心假设是:初始图中的错误可以通过针对性的编辑动作修正,而不必完全重新生成。该设计降低了小型预训练语言模型的解码负担,同时保留捕捉跨句指代、隐式关系、量词修正等句子级解析器常常遗漏的依赖关系的能力。
作者利用人机协同标注流程构建可靠监督,用于模型训练和教师模型构建。描述首先被解析为结构化中间表示,以减少歧义并标准化标注格式。在人工标注过程中,审核人员重点解决跨句指代、纠正量词不一致、恢复缺失的长程关系、识别隐式关系,并检测语义矛盾。该协议还要求标注人员根据对应图像验证描述,并在最终确定图之前纠正事实性不一致或幻觉。
这一标注流程被组织成迭代式主动学习循环。流程从句子级草图生成的初始场景图开始,并通过分阶段人工审核逐步修正。其中一部分精选示例保留为固定验证集,其余示例构成小型种子训练集。随后,基础语言模型在种子集上微调,形成初始教师模型。在每轮主动学习中,模型为新生成的描述起草场景图,初级标注人员编辑草稿,高级标注人员进行验证。新接受的图被加入训练集,模型再次微调。该循环反复将标注力量导向能够改善模型行为的示例,同时控制人工成本。在报告的工作流程中,两轮已经足够,因为验证指标提升趋于平稳,且标注预算固定。
为获得更大规模监督,作者将人工监督数据作为通向合成标注的桥梁。首先使用模型过滤与图像比较时出现幻觉错误的描述,仅保留视觉接地可靠的描述。随后,在人工标注训练示例上微调的教师模型为剩余描述生成场景图标注。这样形成了更大的模型生成标签语料,其质量以高质量人工示例为基础。这些标签支持下游训练,而无需对全部扩展示例进行穷尽式人工审核。
解析模型本身被形式化为学习多句输入的最可能场景图。给定语篇描述 x,目标输出为图 y,推理可写为
y∗=argy∈YmaxP(y∣x;θ),其中 Y 是可能场景图空间,θ 表示模型参数。修正模型不会在一次自回归过程中生成该图。它从初始图开始,应用一系列编辑操作。经过 T 次修正步骤后的最终图概率分解为
P(yT∣x;θ)=PGen(y0∣x)t=0∏T−1(PProg(at∣yt,x;θ)⋅PIntp(yt+1∣yt,at)).该方程反映三个模块:Generator、Programmer 和 Interpreter。Generator 提出初始图,Programmer 提出编辑动作,Interpreter 确定性地应用这些动作来改变图。
Generator 对显式提及提供广泛覆盖,同时有意接受后续修正模块可以纠正的错误。它通过独立地对输入语篇中的每个句子应用句子级解析器来工作。每个句子转换为句子级图,这些局部图被合并为初始语篇图。合并过程中,名称相同的节点被视为共指,这为初始图中的后续关系消解提供了合理起点。但由于该阶段主要独立处理句子,常会产生冗余三元组、缺失的跨句连接,以及遗漏的隐式关系。这些不足不视为致命错误,而是修正过程的输入状态。
Programmer 是核心的可学习模块。在每个修正步骤 t,它接收当前图 yt 和原始语篇 x,并预测一个动作集
at=(Dt,It),其中 Dt 表示删除动作,It 表示插入动作。这种分离很重要。将删除和插入操作一起生成可能使小型语言模型的解码器输出过长,而仅插入式编辑无法移除初始图中已经存在的冗余或错误三元组。对初始图的实证观察支持这一设计:相当比例的提议三元组必须被删除,因此需要具备删除感知的架构。
Programmer 使用编码器-解码器预训练语言模型,并将删除与插入任务分离。编码器预测删除标记。当前图以扁平化形式表示,并通过对三元组开始边界与结束边界之间的上下文 token 表示进行池化,来嵌入每个三元组。随后,二分类层将每个三元组标记为保留三元组或删除三元组。这将大规模修剪初始图转化为高效的分类问题,而非生成问题。
解码器单独处理插入操作。它在 x 和 yt 的编码器表示条件下生成对应新图三元组的 token 序列。每个生成的 token 序列隐式表示一个插入动作。由于解码器只生成缺失内容,而不重建整个图,所需生成长度显著减少。这也使架构与更小的开源语言模型兼容,同时仍能实现迭代式图改进。
Interpreter 使编辑过程变得确定性且结构可控。它接收当前图和预测的编辑动作,然后生成下一个图状态。首先,它通过移除编码器标记的三元组来应用删除操作。其次,它将解码器输出解析为候选三元组,验证结构正确性,并丢弃格式错误或信息不完整的三元组。有效三元组随后被加入图中。Interpreter 遵循先删除后插入的顺序,可写为
yt+1=(yt∖Dtriplest)∪Ttriplest.由于 Interpreter 是确定性的,对于唯一的结果状态,PIntp(yt+1∣yt,at) 为 1,其他情况为 0。
训练 Programmer 需要编辑监督,而不仅仅是最终图监督。作者通过比较初始生成图与对应金标图来构建编辑标注数据。对于每个描述与金标图配对,Generator 会生成初始图。金标图扰动也通过随机删除或插入三元组创建,从而生成能够模拟现实错误的替代初始状态。真实删除标记通过识别初始图中存在但金标图中不存在的三元组获得。真实插入序列通过识别金标图中存在但初始图中不存在的三元组,并将这些三元组转换为 token 序列获得。这会产生如下形式的训练示例
(x,y0,Dgt,Igt),其中 x 是语篇输入,y0 是初始图,Dgt 是删除目标,Igt 是插入目标。合成扰动增加了编辑示例数量,因为同一金标标注可以派生出多个扰动后的初始图。
编码器和解码器通过多任务学习联合训练。删除模块使用保留或删除标记上的二元交叉熵目标:
Ldelete.插入模块使用序列到序列交叉熵目标来生成目标插入序列:
Linsert.总训练损失是加权组合
L=λdelLdelete+λinsLinsert.这一训练设置教会 Programmer 两种互补能力。编码器学习哪些现有图元素可能不正确或冗余,解码器学习哪些语篇级关系缺失以及如何将其表达为图三元组。在推理阶段,模型反复提出删除和插入操作,Interpreter 执行这些操作,图逐步演化为更连贯的语篇级表示。
实验
实验评估了 DiscoSG-Refiner 在语篇级场景图解析、下游 VLM 评估任务和组件消融实验上的表现。结果表明,基于修正的解析提高了准确率,并增强了对复杂图的泛化能力,同时相比许多基线方法提供更强的效率与质量平衡。定性结果进一步表明,DiscoSG-Refiner 能生成更高质量场景图,使基于图的指标在描述评估和幻觉检测中更有效。消融实验证实,合成数据、数据增强、多步修正和分离式编辑设计是方法性能的关键。
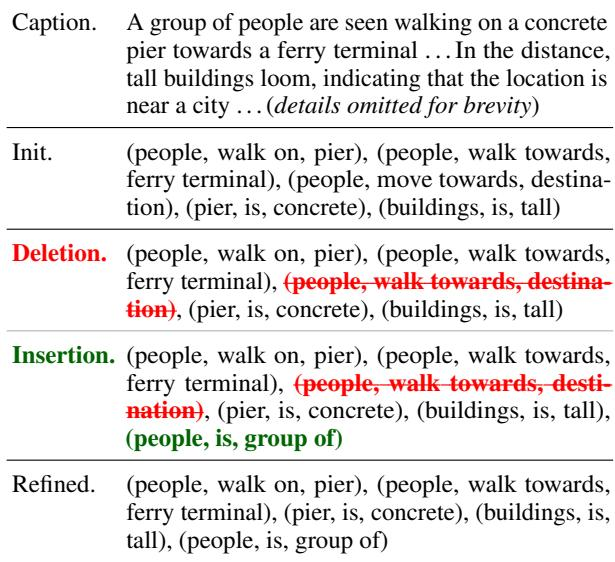
插图展示了如何通过对多句描述生成的初始场景图进行删除和插入步骤来修正它。该过程移除缺乏支持或冗余的关系,并加入缺失的实体属性,从而得到更连贯的最终图。这支持了以下观点:语篇级场景图解析受益于修正,而非简单合并句子级输出。初始场景图在修正前从描述中捕捉实体、谓词和关系。删除编辑在迭代过程中调整可疑或冗余的图关系。插入编辑加入缺失的图信息,例如将人物与群体关联起来的属性。经过编辑修正后,最终场景图比初始图更连贯。
数据集比较表明,新的语篇级场景图数据集远比单句描述数据集规模更大。人工子集和合成子集都包含明显更长的文本,以及每个实例更多的三元组、对象和关系。合成部分贡献了总体三元组数量的较大份额,同时平均图统计量接近人工部分。语篇级实例相比以往的仅描述数据集显著更稠密、更复杂。人工子集和合成子集表现出相似的平均描述长度和图复杂度。合成子集贡献了数据集中总三元组的大部分。
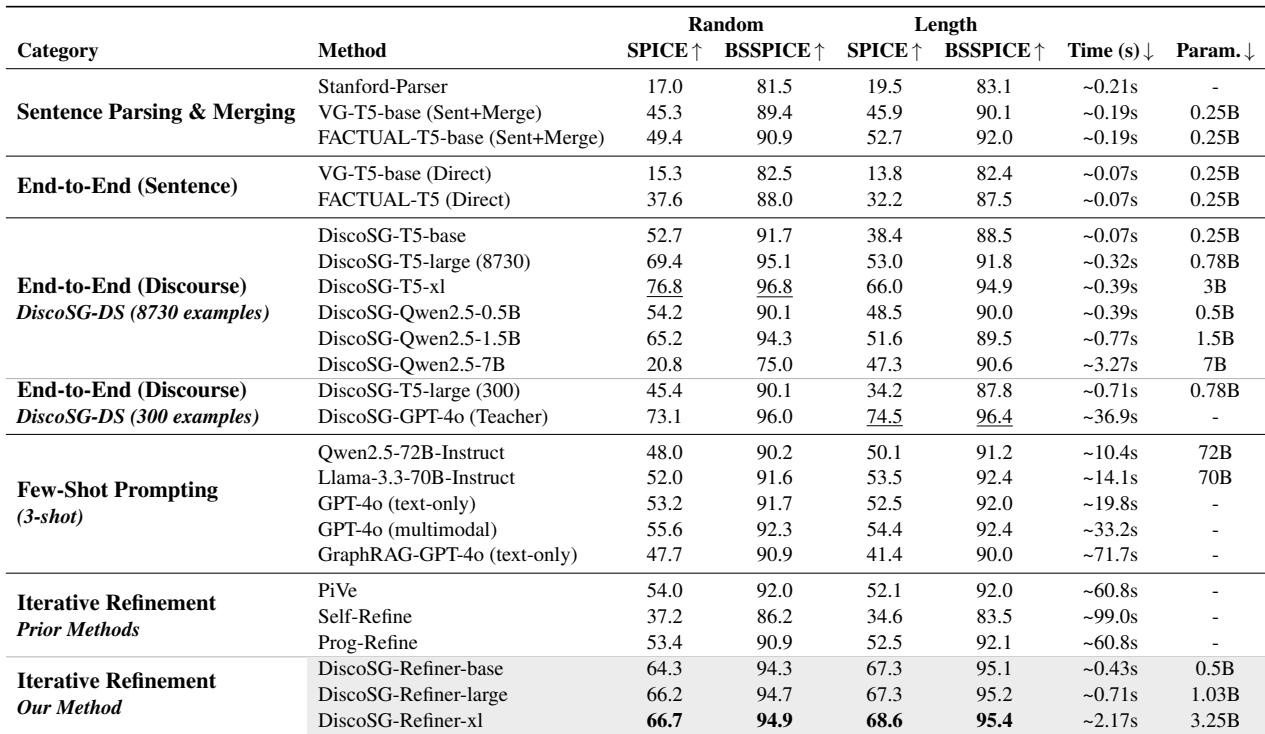
微调后的 DiscoSG 模型相比句子级合并和直接基线提升了语篇级场景图解析表现,但收益强烈依赖模型规模、架构和训练策略。较大的微调模型通常表现更好,而小型端到端模型在图长度或复杂度变化时可能大幅下降。迭代修正变体在准确率、泛化性和成本之间取得很强平衡,以较低计算开销接近或超过大得多的基线。使用 DiscoSG 训练 improves 语篇解析,尤其与微调结合时效果更明显。规模有利于编码器-解码器模型和大型解码器模型,但小型微调模型对图复杂度敏感。修正方法在不同划分上保持较强性能,同时参数量远少于最强大型基线。本地开源模型在速度和部署成本上为闭源大型模型提供了实用替代方案。
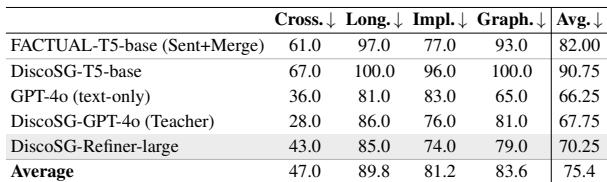
标注结果说明,大多数解析器仍频繁产生语篇级错误,其中长程依赖、隐式推理和图一致性尤其困难。与句子级合并基线和小型端到端解析器相比,DiscoSG-Refiner-large 降低了总体错误率,同时接近基于 GPT-4o 系统的错误水平。较强的纯文本和教师变体表明,通用语言能力和有监督修正都有助于缓解跨句错误和一致性错误。小型端到端解析的错误率最高,尤其在长程和一致性相关类别上。与句子级合并和直接小模型解析相比,迭代修正降低了平均语篇错误。基于 GPT-4o 的变体实现最低平均错误,其中纯文本 GPT-4o 在图一致性上表现尤其强。
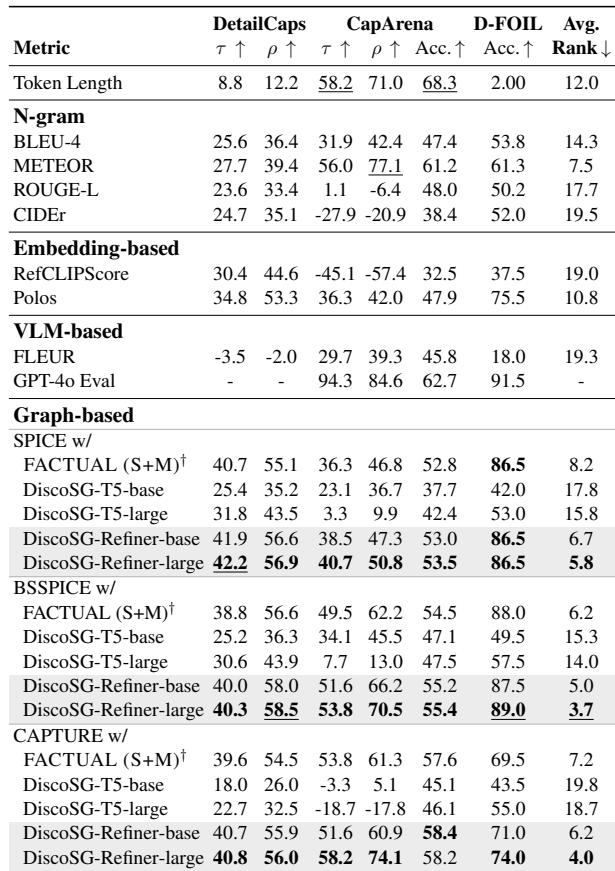
将 FACTUAL-T5-base Sent+Merge 场景图来源替换为 DiscoSG-Refiner 后,描述生成和幻觉检测任务中的图评估指标得到提升,其中较大的修正模型带来最强收益。较小的 DiscoSG-Refiner 模型也大多超过基线,而 DiscoSG-T5 解析器会降低性能。使用 DiscoSG-Refiner-large 的图指标在自动化指标中名列前茅,其中 BSSPICE 和 CAPTURE 表现突出。使用 DiscoSG-Refiner 生成的场景图会提高 DetailCaps 和 CapArena 上的相关性指标。当使用 DiscoSG-Refiner 场景图时,CAPTURE 在 CapArena 和 D-FOIL 上表现出明显提升。BSSPICE 在自动化指标中取得最佳平均排名,并在 D-FOIL 上取得较强准确率。
实验评估了语篇级场景图数据集,并将 DiscoSG 解析方法与句子级合并和直接基线进行比较。该数据集相比以往仅包含描述的资源更稠密、更复杂,迭代修正通过移除缺乏支持或冗余的关系,并加入缺失实体信息来提升图一致性。DiscoSG-Refiner 降低了语篇级错误,尤其是长程依赖和一致性问题,同时为大型闭源模型提供了成本更低的替代方案,并提升了下游基于图的描述生成和幻觉评估指标。