Command Palette
Search for a command to run...
xCoRe:跨上下文共指消解
xCoRe:跨上下文共指消解
Giuliano Martinelli Bruno Gatti Roberto Navigli
摘要
当前的共指消解系统通常针对短篇或中篇文本设计,由于架构限制和隐含的内存成本,难以扩展到非常长的文档。然而,少数可用的解决方案可以通过将文档分割成较小的窗口来应用。这本质上类似于跨文档设置中的情况,在该设置中,系统推断在单独文档中找到的提及之间的共指关系。在本文中,我们将这两个具有挑战性的设置统一在跨上下文共指的通用框架下,并引入xCoRe,一种新的统一方法,旨在高效处理短篇、长篇和跨文档共指消解。xCoRe采用三步流水线,首先识别提及,然后在各个上下文内创建聚类,最后合并跨上下文的聚类。在我们的实验中,我们表明我们的公式能够在共享的长文档和跨文档资源上进行联合训练,增加数据可用性,并特别有利于具有挑战性的跨文档任务。我们的模型在跨文档基准测试上取得了新的最先进结果,在长文档数据上表现出色,同时在传统数据集上保持了顶级结果,使其成为适用于所有端到端共指设置的稳健、多功能的解决方案。我们在 http://github.com/sapienzanlp/xcore 发布我们的模型和代码。
一句话总结
来自罗马萨皮恩扎大学和Babelscape的研究人员提出xCoRe,这是一个统一的三步流水线(指称项检测、上下文内聚类、跨上下文合并),可联合处理short-、long-和cross-document共指消解,在跨文档基准上取得最先进结果,在长文档上表现强劲,同时在传统数据集上保持顶级水平。
核心贡献
- 论文将跨上下文共指消解引入为覆盖中等长度、长文档和跨文档场景的统一框架,并提出xCoRe,这是一个三步流水线,可提取指称项、在单个上下文内构建簇,并在单次遍历中跨上下文合并簇。
- 该架构是模块化且端到端的,消除了先前跨文档系统所依赖的手工特征、单独训练的组件和阈值调整;这一设计支持在共享的长文档和跨文档资源上进行联合训练,增加了数据可用性,并使更具挑战性的跨文档任务受益。
- 该模型在ECB+和SciCo等跨文档基准上取得了新的最优结果,在长文档数据上表现强劲,在传统中等规模数据集上保持顶级水平;模型和代码已公开发布。
引言
共指消解(CR)识别并分组指向同一实体的指称项。虽然现代神经模型在OntoNotes和PreCo等标准基准上已达到接近人类的性能,但CR在两种场景下仍具挑战性:超长文档(模型需在扩展输入上维持连贯性)和跨文档共指(需跨多篇文本解析实体)。
技术层面的利害关系是实际性的。大多数现有CR系统依赖具有二次自注意力复杂度的Transformer架构,因此难以处理长输入。近期工作将文档分割为窗口,以性能换取效率。分别编码文本的跨文档方法在ECB+上无法超过35 CoNLL-F1,且许多方法需要黄金指称项或对指称项提取和聚类进行单独训练,使得端到端使用不切实际。
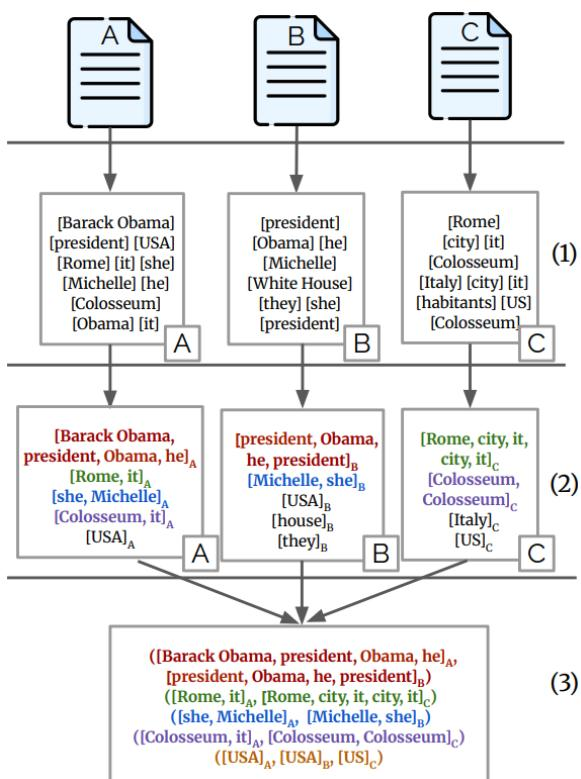
作者发现了一个共同局限:模型无法跨不连续的上下文解析共指。他们将其形式化为跨上下文共指消解,并引入xCoRe,这是一个以三步运行的端到端架构:上下文内指称项提取、上下文内指称项聚类和跨上下文簇合并。该设计利用了模型在单文档内已表现良好的观察,并学习在单次遍历中跨上下文合并局部簇。该公式支持在共享的长文档和跨文档资源上进行训练,改善了数据可用性。xCoRe在跨文档基准上取得了新的最优分数,在长文档数据集上保持顶级结果。
数据集
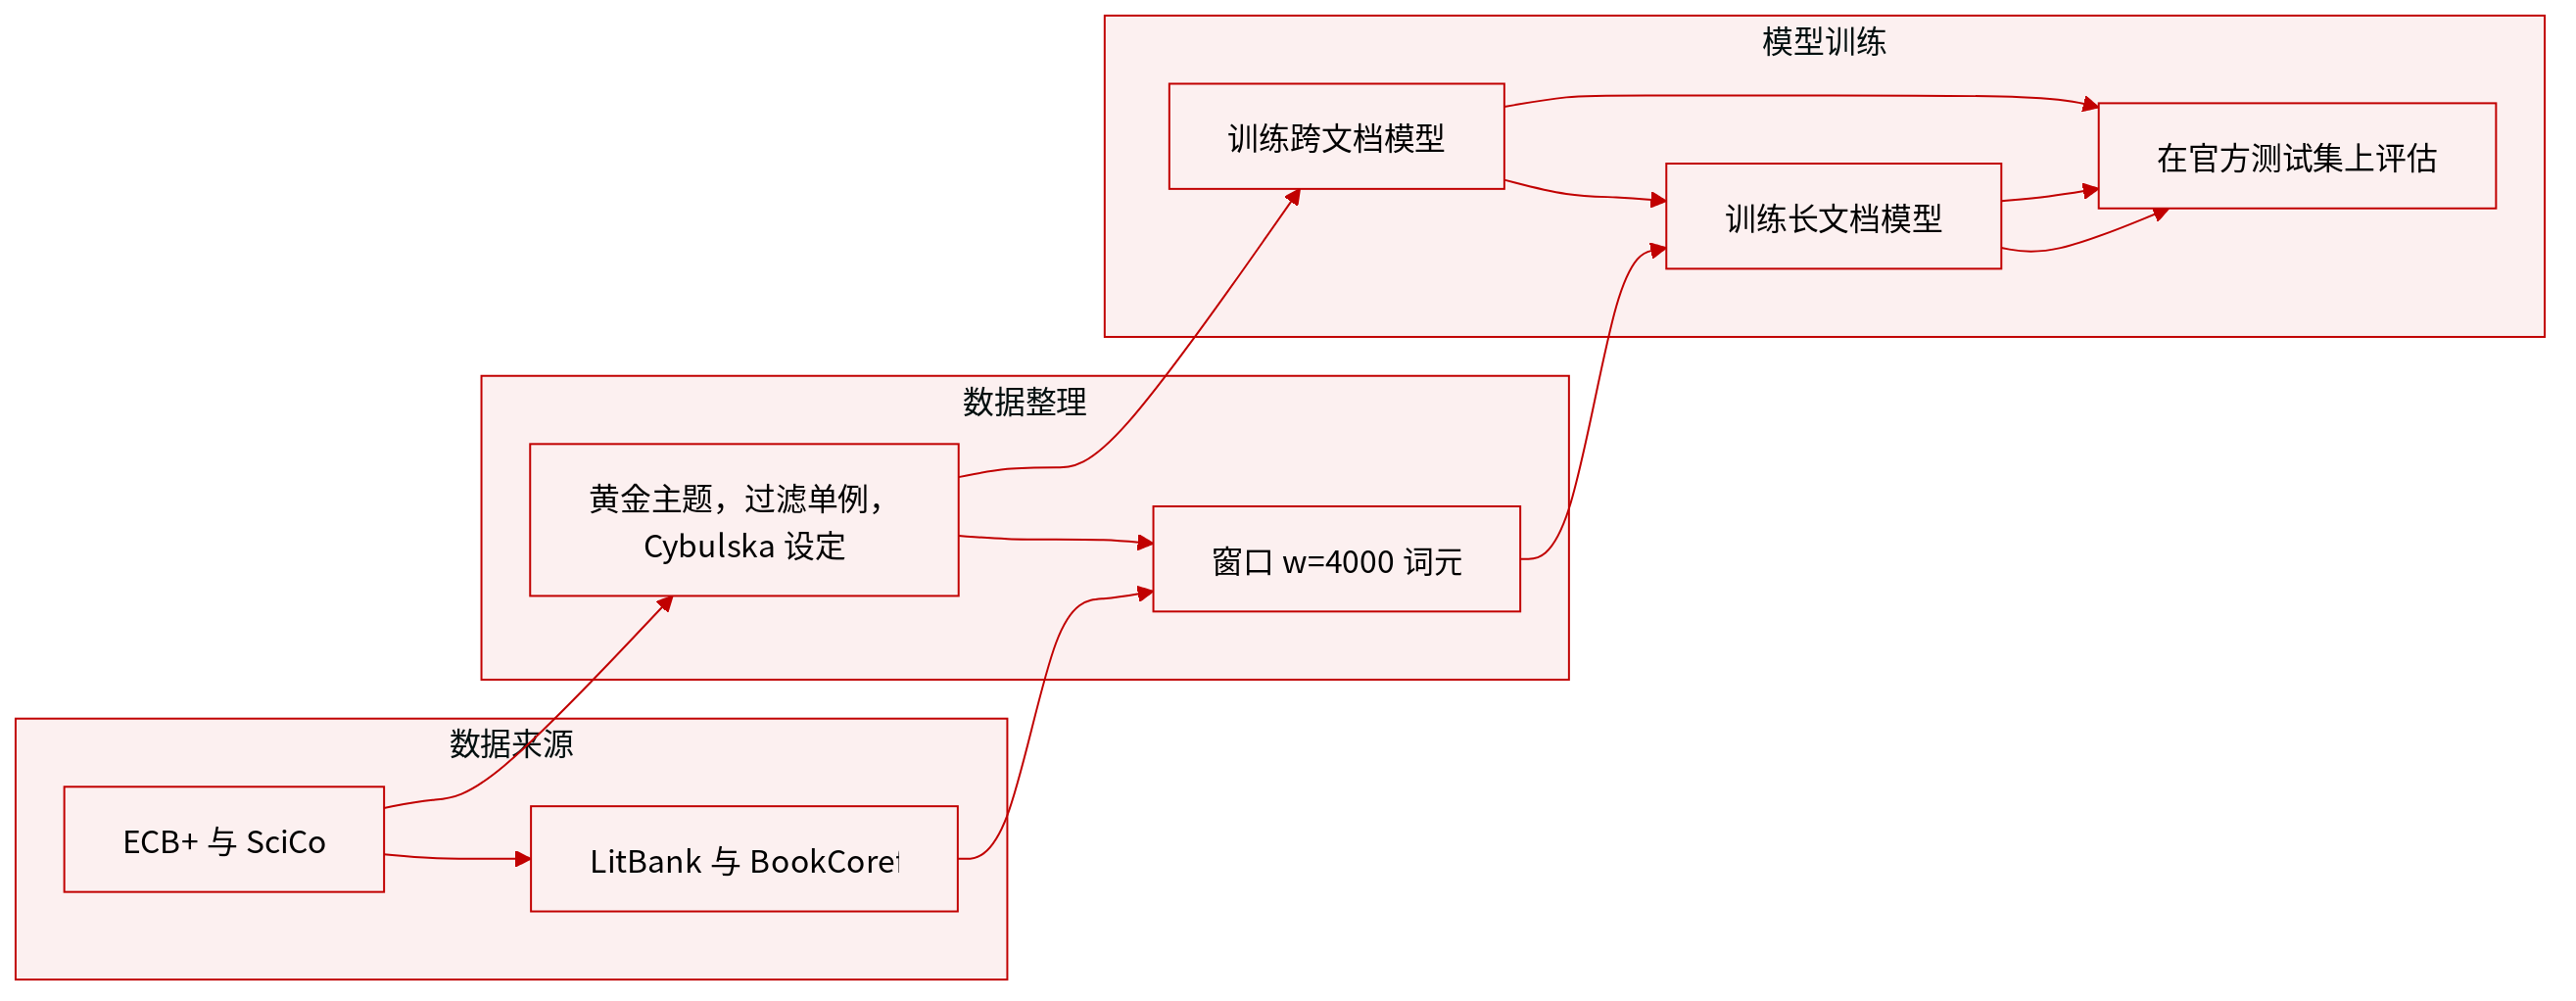
作者围绕两个主要评估场景构建实验设置,每个场景具有不同的数据集和处理规则。
跨文档场景
- 他们在成熟的ECB+和SciCo训练集上进行训练,并在相应的官方测试集上进行评估。
- 为确保与先前工作的可比性,他们使用黄金话题信息并排除单例指称项,因为这些已被证明会扭曲基准结果。
- 对于ECB+,他们严格关注实体共指消解,不使用额外的文档上下文,这一配置称为Cybulska设置。这与一些先前研究不同,后者纳入了来自原始源文档的额外周围上下文。
- 在所有跨文档实验中,他们遵循仅输入属于单一话题的文档的惯例,利用提供的黄金话题结构。
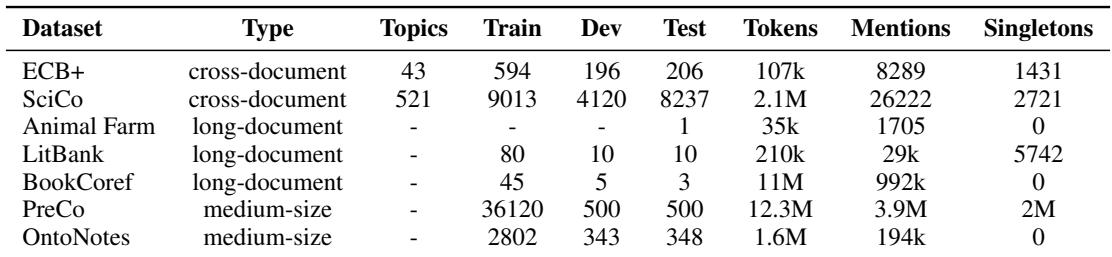
- 完整的数据集统计信息见表1。
长文档场景
- 对于长文档共指,他们在LitBank和BookCoref的银质量训练集上训练对比系统。
- 在LitBank上训练的模型在Animal Farm和LitBank测试集上进行测试。
- 在BookCoref上训练的模型在其人工标注的测试集上进行评估。
- 在长文档(Animal Farm和BookCoref)上测试时,他们使用窗口内大小w = 4000 tokens以匹配先前的实验设置。
中等规模基准
- 他们还在OntoNotes和PreCo等中等规模基准上纳入结果,以进行更广泛的比较。
方法
作者引入xCoRe,这是一个统一的共指系统,旨在通过新颖的跨上下文公式无缝处理短文本、长文档和多文档输入。该模型处理一组通用上下文,这些上下文可以表示单个文档或长文档的固定大小窗口。该架构遵循三步判别式流水线,首先在局部上下文内构建共指簇,然后在单次前向传播中跨上下文合并它们。整体架构请参考框架图。
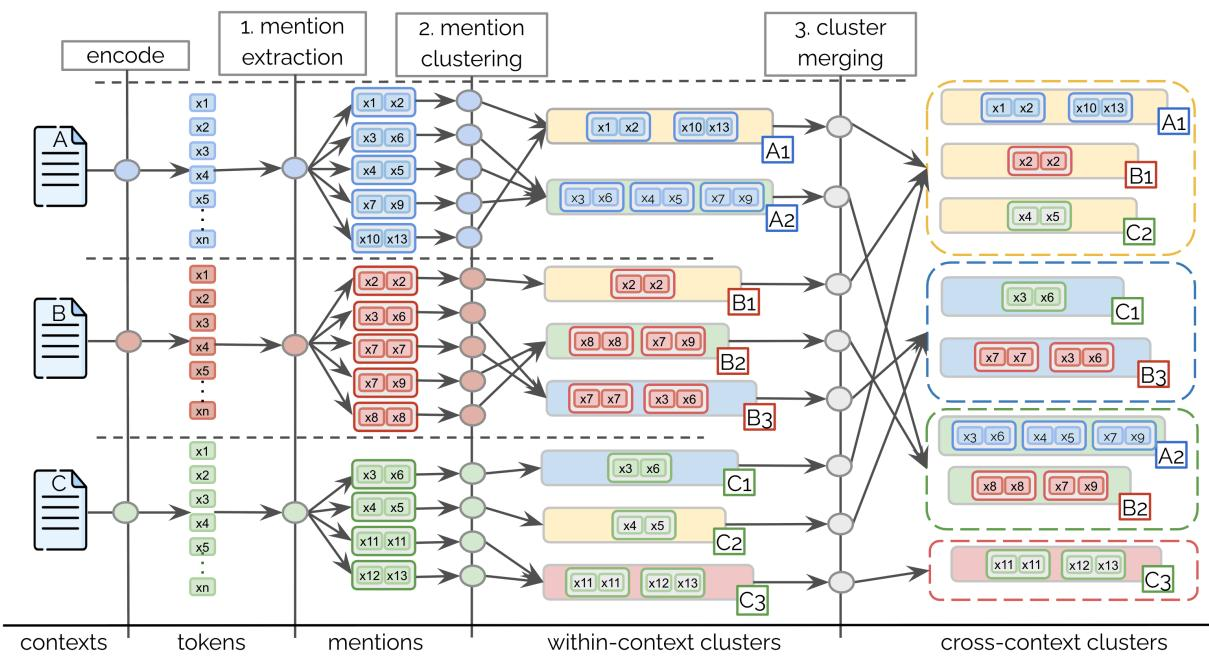
流水线以每个输入上下文的上下文内共指消解步骤开始。该阶段分为指称项提取和指称项聚类。对于指称项提取,模型采用起始到结束策略。基于Transformer的编码器计算上下文内token的隐藏表示。系统识别潜在的指称项起始位置,随后预测其对应的结束位置,并受最近的句末token约束。该过程为每个上下文生成一组候选指称项。
在提取之后,模型执行指称项聚类。每个指称项由其起始和结束token的隐藏状态拼接表示。系统使用一组线性分类层来检测候选指称项是否与先行指称项共指。这为每个单独的上下文生成一组局部共指簇。
该系统的核心创新在于跨上下文簇合并策略。在所有上下文中的所有局部簇被提取后,模型使用单层Transformer为每个簇计算表示。然后计算来自不同上下文的簇之间的成对共指概率。该概率使用由以下方程定义的线性分类层计算:
L(x)=W⋅(ReLU(W′⋅x)) pcm(Waci,Wbcj)=L(hs(Wacj)∥hs(Wbci))其中W和W′是可学习参数,hs表示簇的隐藏状态表示。模型为来自不同上下文的簇对计算该概率,并合并概率大于0.5的簇。该技术具有顺序不变性,使其既适用于顺序长文档,也适用于无序的跨文档场景。
在推理期间,系统通过将文档分割为固定大小的窗口来解决编码长序列的二次内存复杂度。训练面临一个独特挑战:学习跨上下文合并需要接触多上下文示例,而学习上下文内解析则受益于长的单上下文示例。为解决这一问题,作者采用动态批处理训练策略。对于单文档数据集,模型从训练文档中采样n个连续上下文,调整每个上下文的长度以适应内存限制。对于跨文档数据集,通过收集n个不同文档来构建批次。该策略使模型能够在不超过内存限制的情况下从各种输入配置中学习。
实验
评估将xCoRe与PMCoref和CDLM等跨文档系统、Longdoc、Dual-cache和Maverick等长文档系统进行比较,并测试簇合并、预训练和逐步oracle变体。xCoRe的簇合并策略在可靠性上优于拼接和指称项到先行词基线,且随着上下文增加获益更大。在跨文档基准上,xCoRe超越了先前的最优水平,并显著受益于LitBank预训练,而在长文档基准上,它在多个数据集上与Maverick持平或超越,但由于长链分割在BookCoref上落后于Longdoc。错误分析显示,指称项提取是跨文档场景中的主要瓶颈,而簇合并在跨上下文场景中是限制因素。
实验中使用的数据集在大小和注释丰富度上差异很大,涵盖跨文档、长文档和中等规模共指场景。跨文档数据集按主题组织且相对较小,而长文档和中等规模基准包含更多的token计数和训练分割。单例指称项的存在也跨数据集差异显著,影响实验选择,如使用黄金话题和排除单例。跨文档数据集具有明确的话题结构,SciCo包含的话题数超过ECB+的十倍。长文档数据集范围从Animal Farm的单个测试文档到BookCoref的超过一千一百万token,显示出巨大的规模差异。中等规模基准具有最大的训练分割,PreCo包含超过36,000个训练文档。包括Animal Farm、BookCoref和OntoNotes在内的多个数据集中不含单例指称项,而PreCo和LitBank等其他数据集则包含大量单例。
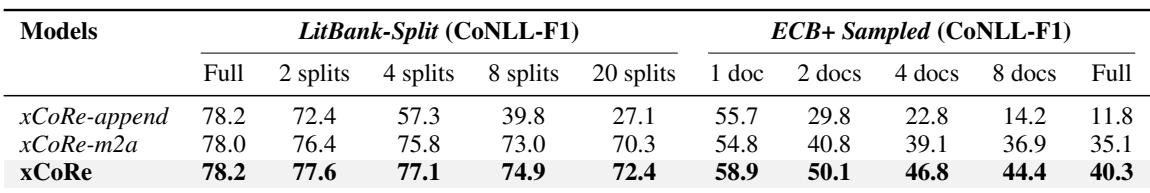
簇合并策略(xCoRe)在所有测试场景中均一致优于基于追加和指称项到先行词的方法,且随着文档段或采样文档数量的增加,性能差距进一步扩大。结果突显了局部提取的簇合并比传统方法更稳健,尤其是在碎片化或部分文档条件下。xCoRe在所有分割和采样配置中均取得最高的CoNLL-F1分数,超越xCoRe-append和xCoRe-m2a。xCoRe相对于替代方案的优势随着分割增多或文档减少而增长,表明其在上下文碎片化加剧下的可靠性。xCoRe-append在上下文被分割或采样时性能急剧下降,而xCoRe-m2a保持中等性能但仍低于xCoRe。
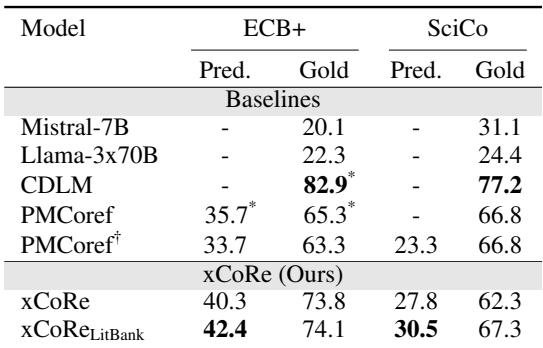
所提出的xCoRe模型在跨文档基准上优于先前最先进的PMCoref,并因LitBank预训练获得进一步提升。结果显示在ECB+和SciCo上的预测指称项和黄金指称项设置中均有一致改进。在ECB+上,经LitBank预训练的xCoRe在预测指称项设置中比PMCoref提高了8.7个CoNLL-F1点。在LitBank上的额外预训练比非预训练版本带来了显著收益,包括在ECB+上+2.1和在SciCo上+2.7。在SciCo上,预训练的xCoRe以7.2分超越先前的最佳分数,而使用额外上下文的模型(如CDLM)显示出较高的黄金指称项分数。
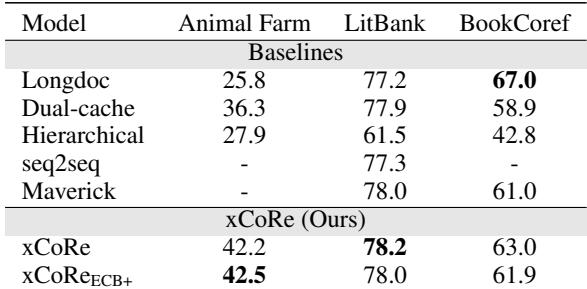
xCoRe在长文档基准上表现出稳健的性能,在Animal Farm上取得最高分,并在LitBank上匹配最优水平。在BookCoref上,它略微优于Maverick,但落后于Longdoc,错误分析表明频繁的链分割损害了其总体分数。额外的跨文档预训练在该场景中未产生有意义的收益。xCoRe在Animal Farm上超越所有对比系统,比Dual-cache提高了5.9个CoNLL-F1点。在LitBank上,xCoRe得分78.2,与Maverick的78.0紧密对齐。在BookCoref上,xCoRe略胜Maverick,但落后于Longdoc;其窗口内预测更好,但偶尔会分割长共指链。Hierarchical在长文档上表现不佳,因为从小上下文过滤单例指称项会累积错误。
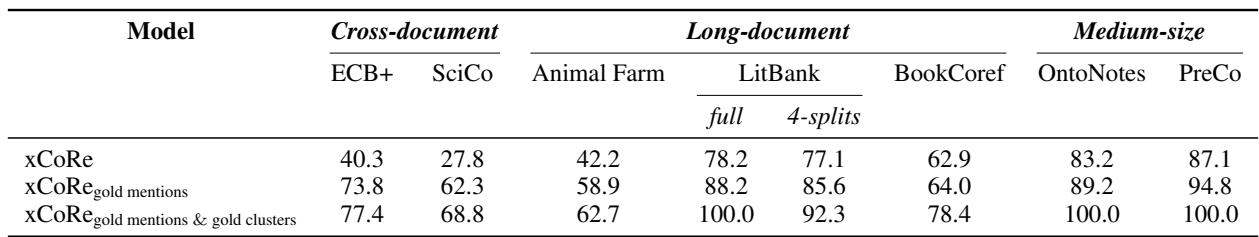
逐步oracle分析显示,提供黄金指称项在大多数数据集上带来显著收益,尤其在跨文档场景中,表明指称项识别是主要瓶颈。然而,在此基础上添加黄金簇仅带来边际收益,突显簇合并在跨上下文场景中是限制因素。在BookCoref上,黄金指称项的帮助较小,因为其注释集中于人物角色,使指称项检测更容易。使用黄金指称项而非预测指称项在跨数据集上大幅提升CoNLL-F1,改进最大的是跨文档基准。在黄金指称项之后,oracle指称项聚类(黄金簇)仅增加适度收益,表明簇合并在跨上下文任务中是主要的剩余挑战。BookCoref是例外,黄金指称项提供的收益有限,因为其仅含人物角色的注释简化了指称项检测。
实验在规模各异且注释特征不同的跨文档、长文档和中等规模共指基准上评估了xCoRe。簇合并策略一致优于基于追加和指称项到先行词的方法,且其优势在更重的上下文碎片化或采样下增长。xCoRe在跨文档任务(ECB+和SciCo)上超越了先前最优水平,并从LitBank预训练中获得了显著收益,在长文档上也表现出竞争力,在Animal Farm上取得最高分,在LitBank上与Maverick持平,不过频繁的链分割限制了其在BookCoref上的结果。Oracle分析表明,指称项识别是大多数场景中的主导瓶颈,但在提供黄金指称项后,簇合并成为限制因素,尤其是在跨上下文场景中。