Command Palette
Search for a command to run...
因果干预揭示英语填充语–空位结构间的共享结构
因果干预揭示英语填充语–空位结构间的共享结构
Sasha Boguraev Christopher Potts Kyle Mahowald
摘要
语言模型(LM)已成为语言学家构建句法理论的重要证据来源。本文提出,将因果可解释性方法应用于语言模型,能够通过帮助我们刻画语言模型所习得的抽象机制,极大提升此类证据的价值。我们的实证研究对象是一组英语填充语–空位依存结构(如疑问句、关系从句)。语言学理论普遍认为这些结构共享诸多特性。基于分布式互换干预(Distributed Interchange Interventions)实验,我们发现语言模型收敛于对这些结构的相似抽象分析。这些分析还揭示了此前被忽视的因素——涉及频率、填充语类型及周围语境——这些因素可能促使标准语言学理论的修正。总体而言,这些结果表明,对语言模型进行机制性的内部分析能够推动语言学理论的发展。
一句话总结
来自得克萨斯大学奥斯汀分校和斯坦福大学的研究人员将分布式转换干预应用于语言模型,表明这些模型在英语填充语-空位结构中收敛于共享的抽象分析,并揭示了频率、填充语类型和语境等被忽视的因素,这些因素可能为修改标准语言学理论提供依据。
核心贡献
- 因果可解释性方法(包括分布式转换干预)被应用于英语填充语-空位结构,以识别语言模型处理疑问句、关系从句及相关结构时使用的内部机制。
- 迁移分析显示,各类构造之间存在共享的填充语-空位机制;当构造在填充语类型、动词倒装模式、信息结构前置或句法类别上匹配时,迁移更强。
- 这些结果揭示了被忽视的频率和生命度效应,以及嵌套从句与主句之间较弱的迁移,提示对构造相似性的句法解释需要改进。
引言
大型语言模型能够处理长距离填充语-空位结构,例如 wh 问句和分裂句,这些结构是检验模型是否学习抽象句法而不仅仅是表层统计模式的重要测试。已有研究证明模型对这些构造敏感,但关于处理机制是否在各构造之间共享的结论并不一致,且多数证据来自行为层面而非机制层面。通过机制可解释性、因果抽象和分布式对齐搜索,可揭示神经模型中的填充语-空位机制,并测试这些机制是否迁移到不同句法构造。结果显示强烈的跨构造泛化,并受语言相似性、词汇重叠、频率和生命度影响,而迁移不容易跨越从句边界。
数据集
-
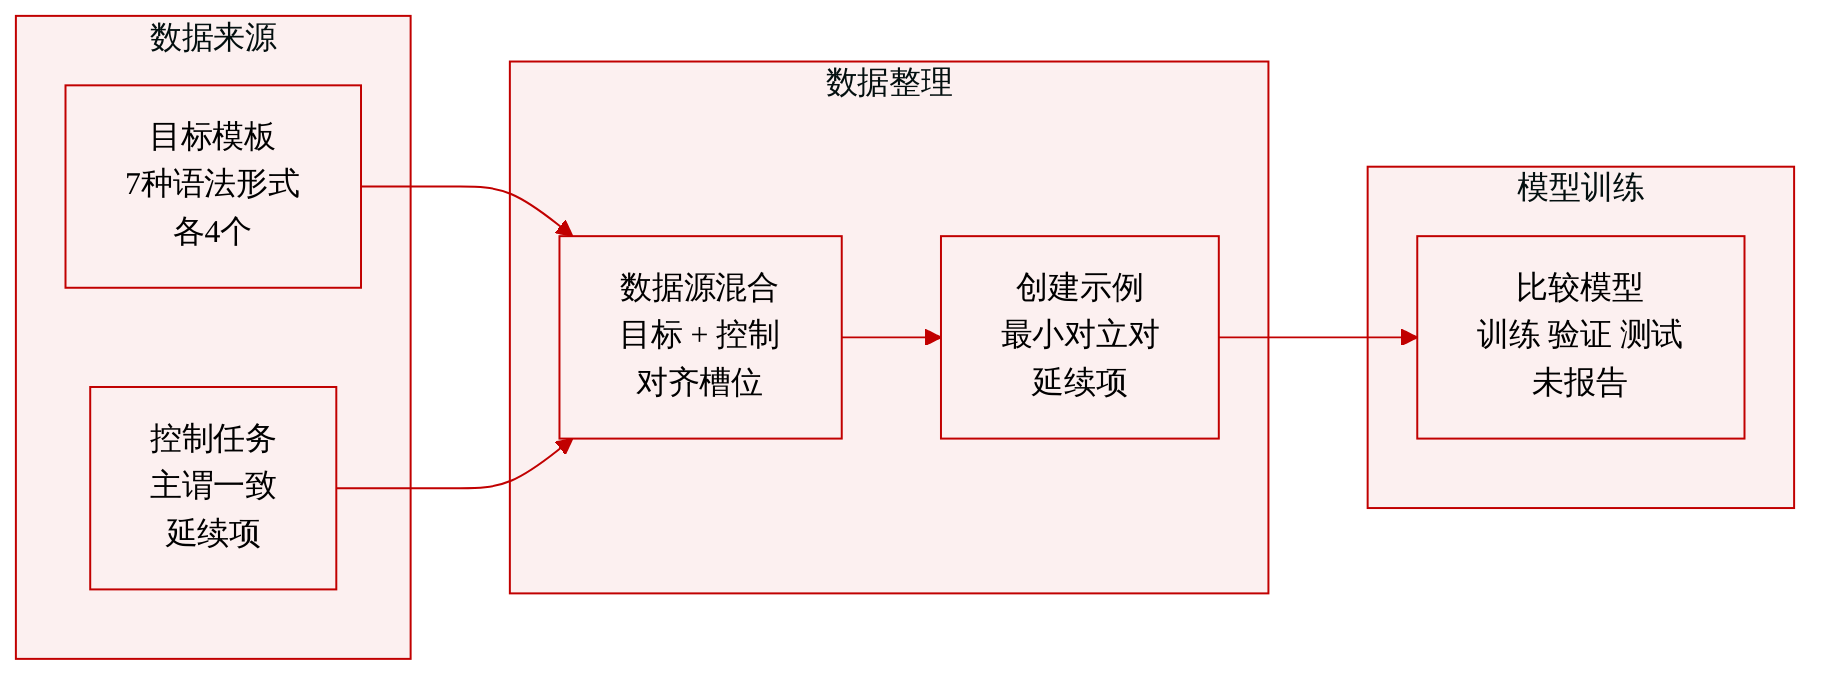
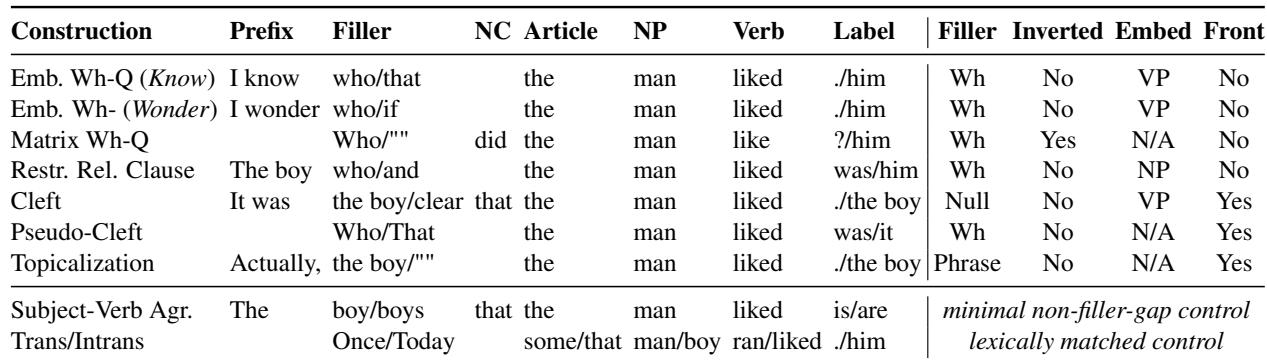
作者使用基于模板的文本数据集,而不是现有语料库。按照 Arora 等(2024)的风格设计句子模板,并采样许多仅在目标语法现象上不同的最小对比对。表 1 给出通用模板和示例句。
-
目标子集:数据集覆盖七种填充语-空位构造:带限定补语化的嵌入 wh 问句、带非限定补语化的嵌入 wh 问句、主句层面 wh 问句、限制性关系从句、分裂句、假分裂句和话题化。对于每种构造,作者创建四个模板。
-
目标子集对照:模板在两方面变化,即被提取宾语的生命度,以及填充语与空位之间从句边界的数量,其边界数为一个或两个从句。所有目标构造都从动词短语中提取直接宾语,并遵循公共模板,使不同构造的 token 位置对齐。
-
对照子集 1:主谓数一致。该对照中相关词之间的距离与目标构造相似,但不需要填充语-空位结构,因为一致发生在同一从句内的成分之间。
-
对照子集 2:及物动词或不及物动词之后的延续预测。该对照使预测标签分布与目标任务保持相似。作者通过在填充语、冠词和名词短语位置放置伪对比词项,保持最小对比与预测点之间的距离。
-
数据模式和处理:数据被构造为具有填充语、冠词和名词短语等槽位的 token 对齐文本模板。文中没有提及裁剪、图像预处理或外部语料过滤。主要处理步骤是从模板生成句子对或延续,以分离出目标语法对比。
-
规模与用途:摘录没有报告原始样本数、训练验证或测试划分,也没有提到进一步过滤。规模由七个目标构造(每个构造四个模板)以及两个对照任务定义。作者使用该数据比较模型在填充语-空位构造上的行为与结构相似但不含填充语-空位的对照任务上的行为。
方法
作者采用两部分框架:首先构建最小对比的语言刺激,然后使用因果干预来测试填充语-空位机制在何处被编码。在数据构造阶段,作者为七种填充语-空位构造生成受控句子集。对于每种构造,作者设计句子模板,以采样许多仅在目标语法属性上不同的最小对比对。每种构造使用四种模板变体,变化被提取宾语的生命度以及填充语与提取后留下的空位之间从句边界的数量。所有模板都涉及从动词短语中提取直接宾语,共享模板结构使得构造间可按 token 位置对齐。设计还包括对照任务,如主谓数一致以及及物或不及物动词后的延续预测,以将真正的填充语-空位行为从更简单的线性邻近效应或标签预测启发式中分离出来。
内部机制探测模块使用分布式对齐搜索。对于基底输入和源输入,模型从同一个 Transformer 模块和 token 位置产生隐藏表示 b 和 s。该过程学习一个特征方向 a∈Rn,并应用干预
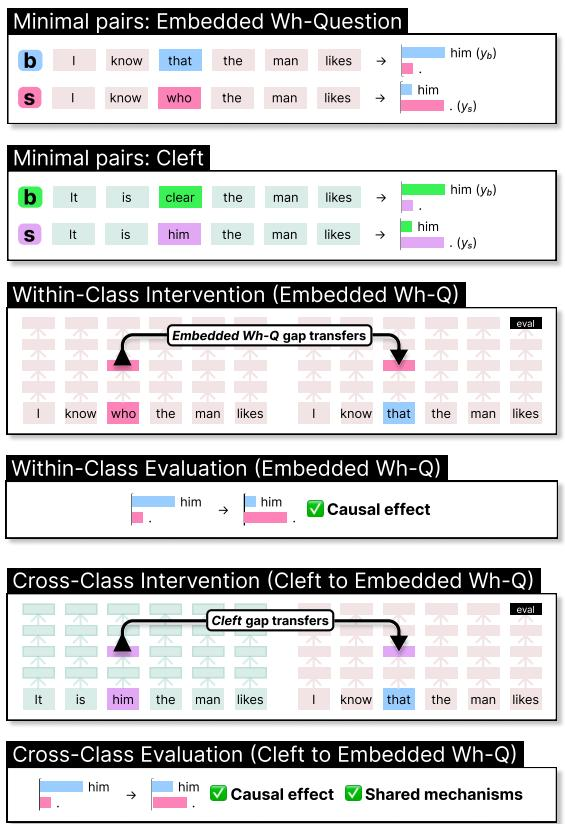
b+(sa⊤−ba⊤)a.这里,b 是为基底示例形成的表示,而 s 是为包含待迁移特征的源示例形成的对应表示。干预沿学习到的特征轴移动基底表示,同时保留 b 的正交维度。语言模型参数保持冻结,只通过标准交叉熵目标学习向量 a。训练目标是使干预后的预测正确,例如即使基底输入原本没有编码预期的填充语-空位结构,也诱导产生空位预测。
该工作流支持类内迁移和跨类迁移。参见下面的框架图。
在单源设置中,每种构造的特征方向只在属于该构造的模板中采样的句子上训练。在留出法设置中,某一构造的特征方向在所有其他构造的模板上训练,从而可以测试一种类上学到的机制是否迁移到留出的类。对于从填充语往后的每个位置以及模型的每一层,训练集包含 200 个采样句子及其对应的最小对比对,形成包含 400 个句子的平衡训练集。
在评估中,作者度量干预后与源构造相关联的反事实延续的可能性提高多少。它们使用与训练集不重叠的评估句,在每一位置-层对上对所得反事实似然度量取平均。由于该方法旨在定位最具有因果相关性的表示,通过在每个位置取最大值来跨层聚合分数。该最大值池化分数随后使用训练集上获得的对应分数进行归一化,以便将留出构造的泛化与训练时使用构造的泛化进行比较。
实验
实验使用针对填充语-空位构造的定向干预和迁移测试,检验语言模型是否共享处理机制,以及哪些因素驱动这种共享。第一个实验显示,各种构造之间存在广泛共享的表示;当训练数据和评估数据重叠或生命度匹配时,迁移更强。第二个实验将构造刻画为源或汇,发现泛化受构造频率和语言相似性影响,因此高频构造能够支持低频构造,而语言上孤立的构造迁移较差。第三个实验发现跨从句边界的泛化有限,单句机制在多句句子早期以及嵌套动词附近再次迁移,这表明主句和嵌套从句由不同机制处理。
所示构造集将单句生命体宾语提取变体与若干填充语-空位构造的对照及语言参数配对。条目随填充语类别、中心词-宾语倒装、嵌入短语,以及前置是结构必需还是话语驱动而变化。这些对比提供受控示例,用于测试模型是否表征每种构造,以及干预是否指向目标空位。共享模板位置支持不同提取类型之间的跨构造比较。参数块按填充语性质、倒装、嵌入类别和前置理由区分构造。数一致对照保持可比较的主语-动词距离,同时省略填充语-空位依赖。
回归结果表明,当训练源与被评估构造共享语言属性时,填充语-空位处理的泛化更强。共享填充语类型和共享嵌入类别持续与更高的处理几率相关,而倒装和前置状态在多个位置表现出正效应。构造之间的语言相似性预测更强的泛化;共享嵌入性质产生强正效应;倒装和前置效应存在,但不如前者一致地强。
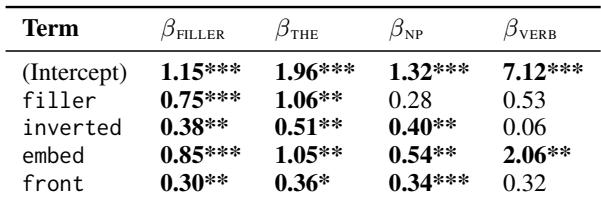
实验使用随填充语类型、倒装、嵌入类别和前置理由变化的受控填充语-空位构造,以测试模型是否表征每种构造,以及干预是否指向目标依赖。回归结果表明,当训练构造与被评估构造共享语言属性(尤其是填充语类型和嵌入类别)时,泛化最强。倒装和前置在某些情况下也表现出正效应,但不那么一致;数一致对照提供可比较的非依赖基线。