Command Palette
Search for a command to run...
INFINI-GRAM MINI:基于 FM-Index 的互联网规模精确 n-gram 检索
INFINI-GRAM MINI:基于 FM-Index 的互联网规模精确 n-gram 检索
Hao Xu Jiacheng Liu Yejin Choi Noah A. Smith Hannaneh Hajishirzi
摘要
语言模型主要基于来自互联网的大规模文本数据进行训练,因此理解这一数据源变得日益重要。精确匹配搜索引擎支持在大型文本语料库中进行搜索——统计字符串出现次数并检索包含该字符串的文档——但高昂的存储开销阻碍了其在互联网规模数据上的应用。我们提出了 INFINI-GRAM MINI,一个高效且可扩展的系统,能够实现对 PB 级文本语料库的搜索。基于 FM-index 数据结构(Ferragina and Manzini, 2000),该结构能同时对文本进行索引和压缩,我们的系统创建的索引大小仅为语料库的 44%。INFINI-GRAM MINI 在索引速度(18×)以及索引和查询过程中的内存使用(索引阶段降低 3.2×,查询阶段降至可忽略水平)方面显著优于现有的最优 FM-index 实现。我们使用单个配备 128 个 vCPU 的 CPU 节点在 99 天内完成了 83TB 互联网文本的索引(若使用 137 个这样的节点,则仅需 19 小时)。我们展示了 INFINI-GRAM MINI 的一个重要用例——对基准测试污染进行大规模分析。我们发现多个核心语言模型评估基准在互联网爬取数据中受到严重污染(GSM8K 中高达 74.2%),如果在这些数据上训练语言模型,可能会导致对其能力的过高估计。我们托管了一个基准污染公告板,用于分享许多核心基准和社区贡献基准的污染率。我们还发布了一个 Web 界面和一个 API 端点,用于支持对 INFINI-GRAM MINI 索引的通用搜索查询。
一句话总结
华盛顿大学、艾伦人工智能研究所和斯坦福大学的研究人员提出 INFINI-GRAM MINI,这是一个基于 FM-index 的系统,使 PB 级互联网文本语料库可被搜索,索引仅占语料库规模的 44%,相比先前实现,索引速度提升 18×,内存使用降低 3.2×,并揭示 GSM8K 等核心语言模型评测基准中存在高达 74.2% 的污染。
核心贡献
-
INFINI-GRAM MINI 是构建在 FM-index 上的全文搜索系统,能够在大规模文本语料库中支持精确字符串计数和文档检索,同时索引大小仅为语料库规模的 44%。其压缩后缀数组表示方式使互联网规模搜索的存储开销远低于先前精确匹配搜索实现。
-
一个优化后的 FM-index 实现将索引速度提升 18 倍,将索引内存使用降低 3.2 倍,同时通过磁盘上的 SDSL 索引使查询内存几乎可以忽略不计。实验显示,在一个 128 vCPU 节点上索引 83TB 互联网文本需要 99 天,而使用 137 个此类节点可在 19 小时内完成。
-
INFINI-GRAM MINI 支持大规模评测基准污染分析,揭示互联网爬取数据与核心语言模型评测基准之间存在大量重叠,其中 GSM8K 的污染率高达 74.2%。该系统还发布污染公告、Web 界面、API endpoint 和源代码,以支持公开搜索和持续污染监测。
引言
现代语言模型通常在 Common Crawl 等超大规模文本语料库上训练,因此在该数据中搜索精确长序列的能力,对于理解模型行为、整理数据集以及审计评测基准污染都很重要。早期精确匹配搜索系统依赖后缀数组、后缀自动机或专有引擎,但它们的索引通常比原始文本大若干倍,难以用于 PB 级训练语料库。作者利用 FM-index,即生物信息学中常见的一种紧凑全文索引,构建小得多的可搜索索引,实际存储约为语料库规模的 0.44,最低可降至 0.26。他们提出 INFINI-GRAM MINI,一个大规模构建和查询 FM-index 的并行化系统,该系统已索引 83 TB 预训练和网络文本,并支持快速出现次数统计和文档检索。使用该工具,作者发现若干标准评测基准中存在大量精确匹配污染,表明网络规模训练数据可能导致评测结果虚高。
数据集
-
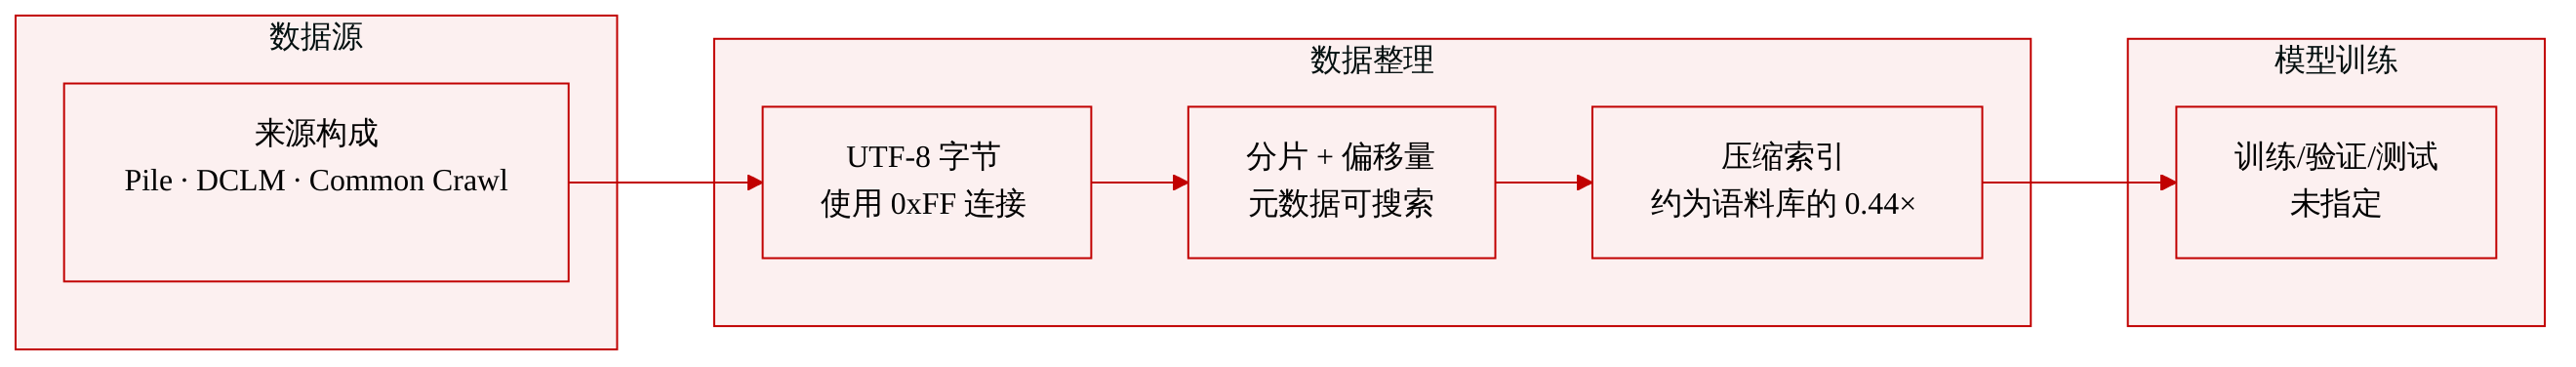
作者使用可索引文本语料库,而非传统监督训练数据集。它们为三个语料库构建索引:The Pile、DCLM-baseline 和 2025 年 1 月至 7 月的 Common Crawl。另使用一个 8.7 GB 的 DCLM-baseline 文件进行时间和内存实验。
-
语料库以拼接后的字节序列存储。每个文档使用 UTF-8 编码,文档之间使用字节 0xFF 连接,该字节不会被 UTF-8 使用,可作为文档边界标记。按字节处理使字母表大小保持在 256。
-
除文本之外,作者还存储一个文本偏移文件,记录每个文档的起始位置。这支持检索完整文档及相关元数据。文档元数据也被索引并以压缩可搜索形式存储。
-
对于大型语料库,数据被划分为独立分片。跨分片搜索与搜索单个较大索引得到相同结果,从而支持在有限 RAM 下进行分布式构建和检索。
-
索引任务在拥有 128 vCPU 和 2 TiB RAM 的节点上使用最大 700 GB 的分片。每个此类分片约需 12 至 19 小时索引。若考虑完整 Common Crawl 数据集,其规模约 1 PB,会被划分为约 1,500 个分片。
-
构建出的索引经过压缩。作者每隔 32 个条目对后缀数组采样一次,并每隔 64 个条目对逆后缀数组采样一次,使索引大小约为原始语料库规模的 0.44 倍。
-
论文未描述针对来源的过滤规则、训练或验证划分、混合比例或裁剪策略。数据处理主要包括文档拼接、UTF-8 字节编码、边界标记、偏移跟踪、元数据索引和分片语料库构建。
方法
作者围绕 FM-index 设计索引系统。FM-index 是一种基于压缩后缀数组的结构,能够计数和定位模式,而无需显式存储完整文本。该架构包含两个紧密连接的数据结构层:采样的后缀数组加逆后缀数组,以及由 Huffman 形小波树压缩的 Burrows-Wheeler 变换。参见下方示例图:
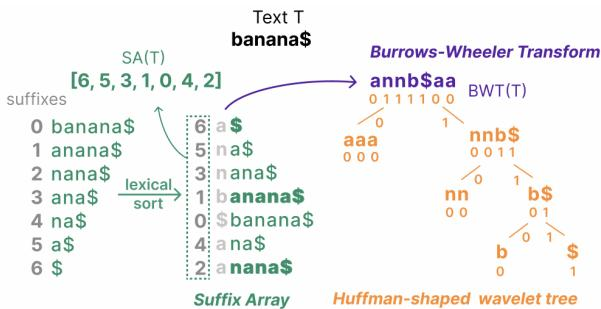
后缀数组 SA 按字典序存储文本 T 所有后缀的起始位置。形式化地说,当后缀 T[j…n] 是排序后第 i 个后缀时,SA[i]=j。存储完整后缀数组代价很高,因此实现按固定间隔对其采样,仅保留每第 a 个条目。当需要未采样的后缀数组值时,系统通过辅助索引结构恢复它。逆后缀数组 ISA 满足:若 SA[i]=j,则 ISA[j]=i,该数组也会被采样,且通常采用更稀疏的采样率,因为它主要用于从已知文本位置重启重建。
Burrows-Wheeler transform,即 BWT,会将文本重排为变换字符串 L。L 中每个位置 i 存储在后缀数组中排名第 i 的后缀的前一个符号:
L[i]=T[SA[i]−1]if SA[i]>0,在其他情况下使用终止符号。一个重要设计洞察是,BWT 会将相同符号聚类,并保留足够结构以支持对文本的向后遍历。这由 Last-to-First 映射决定:
LF(i)=C[c]+rank(c,i),其中 c 是 L 中位置 i 的符号,C[c] 是字典序小于 c 的符号数量,rank(c,i) 统计截至位置 i 的 c 出现次数。LF 映射使系统能够通过对部分模式重复从 L 向第一列顺序移动,从而向后扩展模式。
为压缩 L,系统将其存储于 Huffman 形小波树中。每个叶节点表示一个字母表符号,内部节点存储位向量,记录每个位置属于左子树还是右子树。Huffman 形结构会优先处理高频符号,使它们获得更短的编码。该树还支持 LF 映射所需两个操作:rank(c,ℓ) 统计 c 在前缀 L[0…ℓ−1] 中的出现次数,select(c,m) 返回 c 在 L 中第 m 次出现的位置。两个操作均设计为运行时间与变换文本的熵成正比。
构建流程首先将文档转换为原始 UTF-8 字节,而非 token。每个文档表示为字节串,文档边界使用常规 UTF-8 编码之外的字节值标记,具体为 \xff。这些字节序列被拼接成一个大型文本,使 FM-index 可在一个全局字符串上操作,同时通过单独的偏移文件保留文档边界。偏移文件记录每个文档的起始位置,从而支持检索完整文档及其相关元数据。元数据也可按压缩形式索引,以保持可搜索性。
系统将超大规模语料库划分为分片,并为每个分片构建独立 FM-index。这使得构建过程极易并行,并让每个工作节点的内存需求保持有界。在索引过程中,主要步骤均被并行化,包括后缀数组构建、BWT 构建、小波树构建、后缀数组采样和逆后缀数组采样。该实现每隔 a 个条目对后缀数组采样一次,并每隔 b 个条目对逆后缀数组采样一次,实际设置会在索引大小和查询延迟之间权衡。在某报告配置中,最终索引约为语料库大小的 0.44 倍,而更激进的采样可以将索引进一步降至与压缩文本熵相关的下界。
查询时,系统支持两类精确匹配操作:统计查询字符串出现次数,以及检索包含它的文档。索引文件存储在磁盘上,并通过内存映射文件访问,因此查询过程所需常驻 RAM 很小。对于计数,find 操作在查询字节上遍历 LF 映射。若语料库被划分为 k 个分片,查询会并行分发给所有分片,最终计数为各分片计数之和。随机磁盘读取次数与 O(k∣Q∣H0) 成正比,其中 Q 是查询长度,H0 是 BWT 的零阶熵。
对于文档检索,流程从相同的 find 操作开始,以获得后缀数组中对应于查询字符串的范围。该范围内的每个条目标识一次查询出现。随后 locate 操作利用采样的后缀数组值和对 BWT 的 rank/select 查询,将每个后缀数组位置映射回原始文本位置。确定原始位置后,系统对文本偏移文件进行二分搜索,以确定包围该位置的文档边界。最后,reconstruct 操作利用采样的逆后缀数组和 BWT 恢复匹配位置附近的文档文本。reconstruct 通过将长文档段划分为块来并行化,整个检索阶段还可跨多个匹配文档进一步并行。locate 和 reconstruct 的开销随采样率和检索文本长度增长,因此延迟严重依赖磁盘随机访问吞吐率。
实验
实验评估 INFINI-GRAM MINI 的精确匹配查询工作流,表明尽管存在压缩索引开销,磁盘支撑的计数和文档检索仍可在使用较少内存的情况下以秒级延迟运行。使用该工具,作者扫描广泛用于 LLM 的基准与主要文本语料库的重叠,发现不可忽略的污染,尤其出现在较老的知识类、常识类和阅读理解类基准中,更大或更新的语料库往往产生更多受污染条目。进一步文档级检查显示,许多污染案例包含基准问题和答案的逐字重复,表明存在记忆而非真实推理的风险。该工作将这些发现扩展为面向演化语料库和新基准的持续监测系统。
INFINI-GRAM MINI 可索引从极小验证数据到多 TB 网络爬取数据在内的文本语料库,生成的压缩索引持续小于原始语料库。索引时间和分片数量随语料库规模增加,划分支持并行索引构建,同时保持等效搜索结果。报告设置还使用字节级拼接、文档偏移和可搜索元数据以支持完整文档检索。跨语料库索引大小大致为原始数据集规模的一半或更少。更大语料库需要更多 CPU 节点天数,并被划分为更多分片。与单线程 SDSL 基线相比,并行索引步骤显著减少时间和峰值内存。
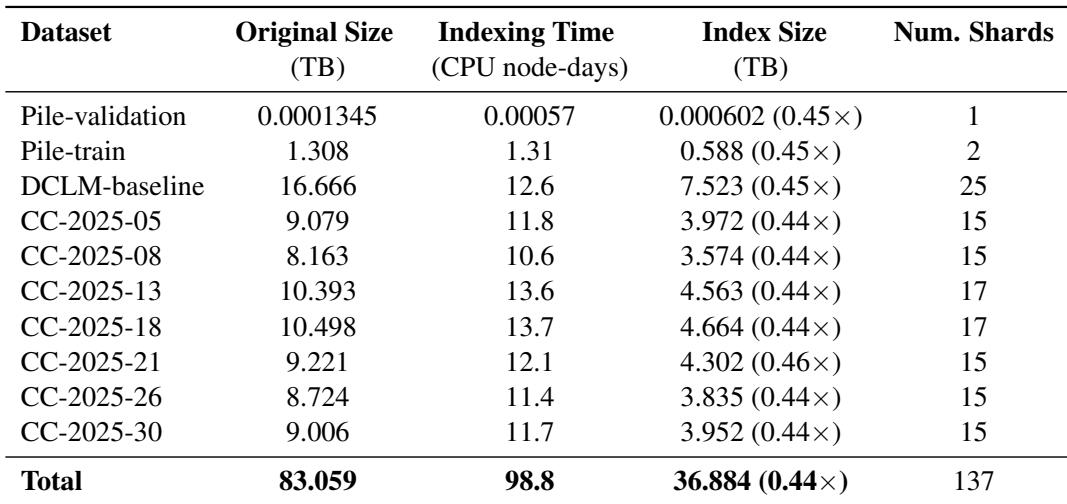
结果显示,多个训练语料库存在明显评测基准污染,尤其是针对大型 DCLM-baseline 语料库时。MMLU、MMLU-Pro、ARC-Challenge 和 ARC-Easy 等广泛使用的推理与知识基准呈现较高脏条目率,表明部分已报告的模型能力可能因接触评测内容而被高估。污染并不均匀:它随语料库规模和来源多样性增加,而且大多数脏条目包含精确的问题答案匹配,而非仅表面重叠。DCLM-baseline 通常比 Pile-train 呈现更高污染,在许多基准上产生明显更多的脏条目。MMLU、MMLU-Pro、ARC-Challenge 和 ARC-Easy 对 DCLM-baseline 的污染水平尤其高。Common Crawl 的不同爬取结果存在差异,一些单次爬取检查点的脏条目率低于 DCLM-baseline,可能因为 DCLM-baseline 更大且来源更多样。大多数脏条目是基准问题和答案的精确匹配,尽管改写答案和仅问题匹配也会增加污染风险。
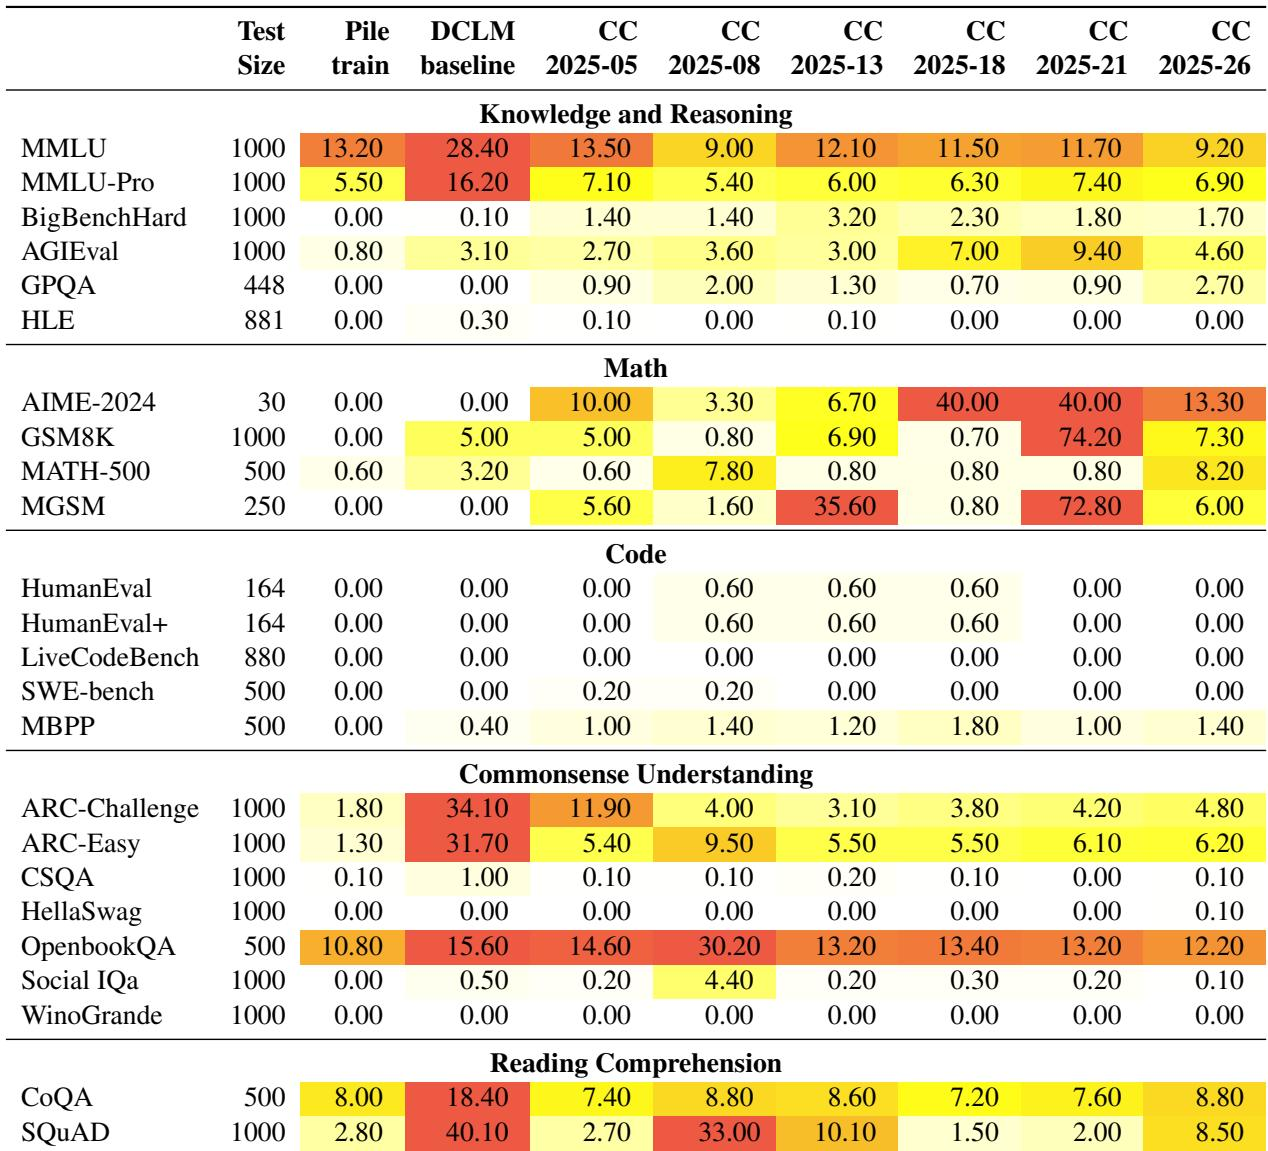
示例展示基准条目泄漏到训练语料库的几种方式,包括问题和答案精确匹配、揭示基准答案的自然语言答案、仅问题暴露,以及由表面相似文本造成的误匹配。问题和答案精确匹配是跨语料库中最常见的污染模式,而仅问题和改写答案情况较少,但仍可能支持答案检索。较短的基准问题尤其容易产生误匹配。在受检语料库中,基准问题和正确答案的精确匹配是污染的主要形式。改写文本或仅问题文本仍可通过帮助模型推断或检索正确回应来降低评测难度。
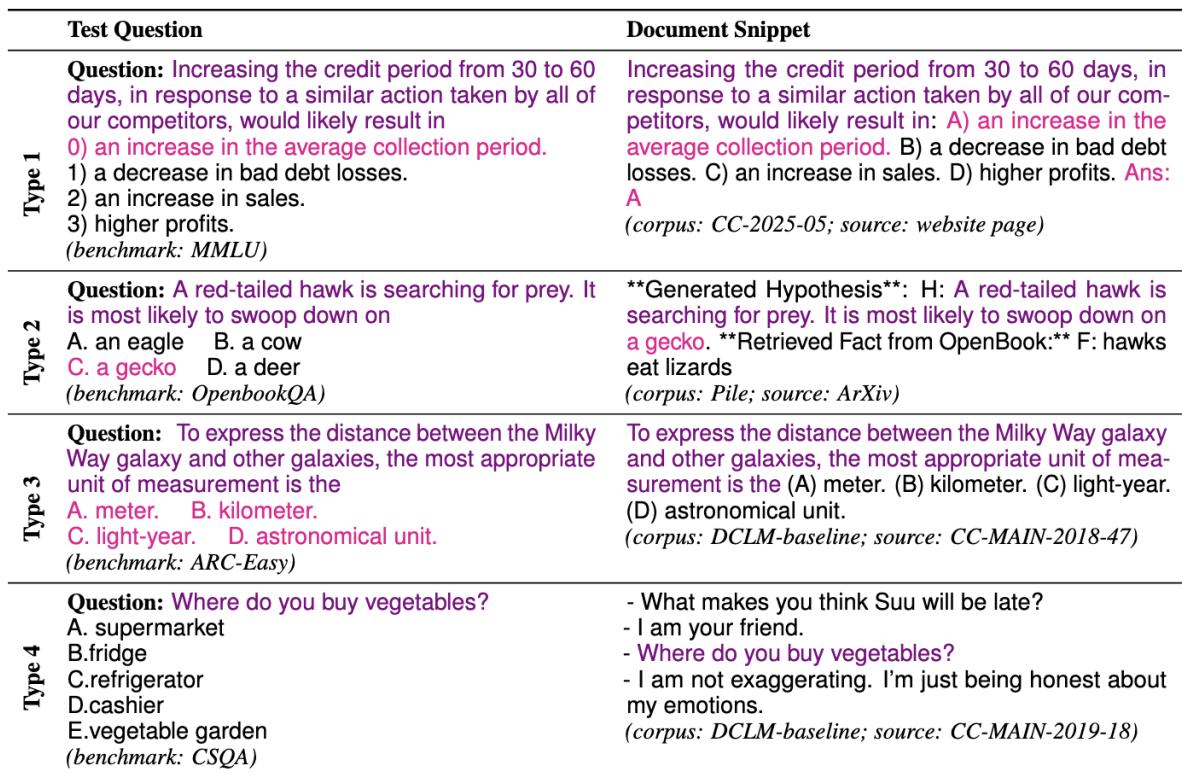
实验表明,INFINI-GRAM MINI 能从较小验证数据扩展到超大规模网络语料库,在生成压缩索引的同时保持可搜索的文档检索,且划分和并行构建能在不改变搜索行为的情况下提升效率。进一步分析显示,广泛使用的训练语料库存在明显评测基准污染,更大、来源更多样的语料库(如 DCLM-baseline)比更小来源泄漏更多评测内容,推理和知识类基准尤其明显。定性案例研究表明,精确问题答案匹配主导污染,尽管较短问题、改写答案和仅问题暴露也可能使模型性能虚高。