Command Palette
Search for a command to run...
“低资源”语言的芝诺悖论
“低资源”语言的芝诺悖论
Hellina Hailu Nigatu Atnafu Lambebo Tonja Benjamin Rosman Thamar Solorio Monojit Choudhury
摘要
自然语言处理(NLP)领域研究的语言不平等通常以“低资源”与“高资源”来表征。然而,对于究竟何种语言构成“低资源语言”,学界尚缺乏明确共识。为理解 NLP 论文如何定义和研究“低资源”语言,我们对 ACL 论文库及主流语音处理会议中提及“low-resource”关键词的 150 篇论文进行了定性分析。基于分析结果,我们揭示了多个相互交织的维度如何共同决定一门语言的“低资源”属性,以及这种多维性为何使得追踪各门语言的研究进展变得困难。我们期望本研究:(1)促使论文在使用该术语时给出明确定义;(2)为将某门语言界定为“低资源”时所应考虑的多维度提供参照依据。
一句话总结
加州大学伯克利分校、MBZUAI、Lelapa AI 等机构的研究人员从 ACL Anthology 和语音处理会议中定性分析了 150 篇论文,揭示了多条相互作用的因素会影响一种语言的“低资源状态”,并妨碍按语言追踪进展,同时呼吁未来研究采用明确的术语定义。
核心贡献
-
一项对来自 ACL Anthology 和常见语音处理会议、提到低资源语言的 150 篇论文开展的定性分析,记录了该术语在 NLP 研究中的定义和使用方式。
-
该分析识别出资源充裕度的四个相互作用维度,包括数据、语言活力和数字支持,并解释了为何单一的“低资源”标签会掩盖具体语言所取得的进展。
-
该研究建议研究人员、社区、会议组织方、机构、产业界、政府和资助方采用明确术语并采取行动,以厘清资源类别,并加强对代表性不足语言的支持。
引言
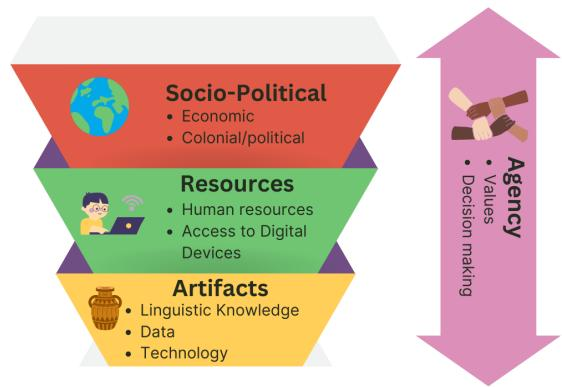
在 NLP 中,语言技术主要面向高资源语言构建,而许多社区,尤其是全球南方地区的社区,缺少可获得的工具。这一点很重要,因为缺失或薄弱的语言支持会加速语言消失,并给依赖数字服务的说话者带来后续伤害。以往研究常常使用模糊或仅基于数据的标准将一种语言标记为低资源,这会掩盖社会、人力、技术和社区层面的障碍,并可能导致偏离需求或带有剥削性的研究。作者借助对 150 篇论文的定性调查表明,低资源状态源于四个相互作用维度:社会政治约束、可用资源、技术制品和社区自主性。作者提出了一个框架,以推动更明确的术语定义和利益相关者建议,从而指导以社区为中心的精准干预措施。
数据集
-
数据集构成与来源
- 作者使用的是一组已发表的 NLP 和语音处理论文语料,而不是用于模型训练的语言数据集。
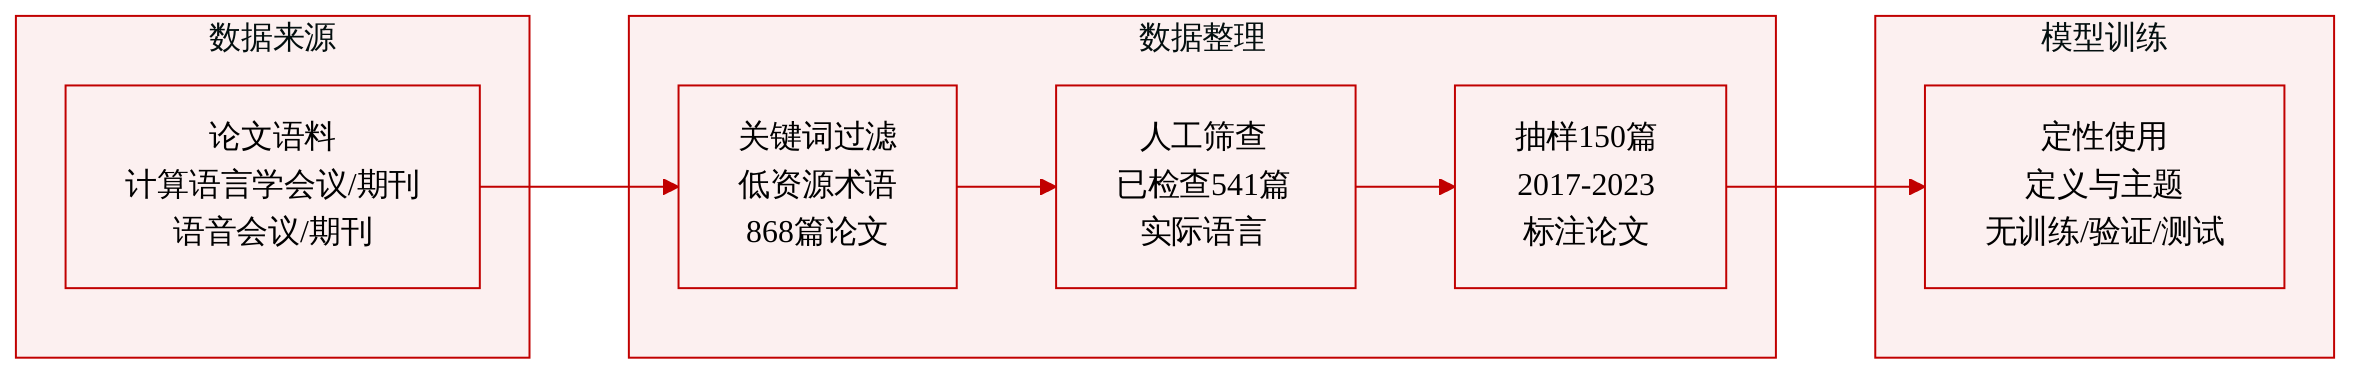
- 他们通过 ACL Anthology 从 *CL 会议收集论文,并通过 Semantic Scholar API 收集 INTER-SPEECH 和 ICASSP 的论文。
- 他们通过检索标题和摘要中的 “low-resource” 或 “under-resource” 来筛选论文。
- 初始语料包含 868 篇去重后的论文。
-
定性子集与筛选规则
- 作者对 541 篇论文进行人工标注,以识别其中明确研究非模拟低资源语言的论文。
- 仅通过欠采样来模拟低资源设置的论文被排除在主要定性分析之外。
- 如果论文研究了至少一种真实存在的低资源语言,即使同时包含模拟低资源实验,也会予以保留。
- 在筛选后的集合中,作者随机抽取 150 篇论文进行详细定性分析。
- 抽样论文涵盖 2017 年至 2023 年的发表年份,且抽样过程未受发表年份约束。
-
处理与标注体系
- 对于每篇抽样的论文,作者记录其中如何定义 “low-resource” 或 “under-resource”。
- 他们标注每篇论文研究了哪些语言。
- 他们还记录论文提到的、与这些语言处于低资源状态相关的其他挑战。
- 这些标注使用归纳主题分析进行分析,以识别反复出现的主题。
- 讨论的主题包括语言特征与描述、数据可获得性或质量,以及技术或计算工具的可获得性。
-
数据用途
- 该语料用于定性分析已发表研究中如何定义和应用 “低资源语言” 这一表述。
- 该论文没有描述该语料的训练集划分、验证/测试集划分、混合比例或模型训练用途。
方法
作者将该研究组织为一条定性分析流水线,而不是一个计算训练过程。该流水线的设计目标是从宽泛的论文语料推进到对研究论文如何构建低资源语言概念的高度聚焦分析。它可被理解为一个包含四个主要阶段的模块化工作流:语料构建、范围筛选、细读标注和主题综合。
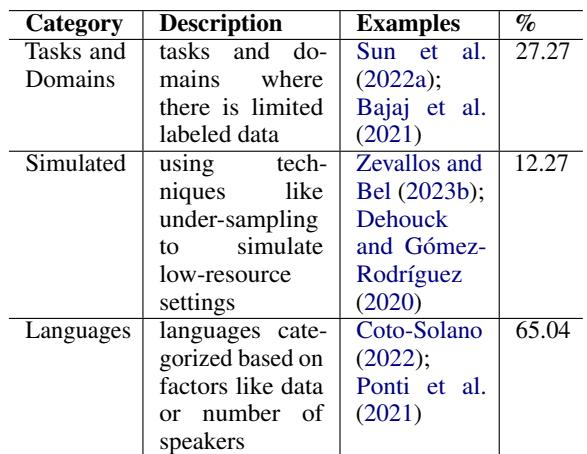
第一个阶段是语料构建。作者利用自然语言处理会议和语音处理会议的书目来源,通过 ACL Anthology 记录和 Semantic Scholar API 检索论文。对标题和摘要应用关键词匹配规则,选择提到 “low-resource” 或 “under-resource” 的论文。此阶段产生一个广泛的候选池,其中目标术语被用于多种研究场景。作者随后进行定性筛选,并观察到该术语出现在三个宽泛类别中:标注数据有限的任务或领域、通过欠采样等方法创建的模拟低资源设置,以及关于语言本身的论断。
第二个阶段是范围筛选。由于该研究旨在理解语言如何被标记为低资源,作者将注意力限制在涉及真实语言而非纯模拟设置的论文上。这需要对较宽语料库进行人工检查,以识别明确研究非模拟低资源语言的论文。如果真实语言是研究设计的一部分,则同时包含模拟低资源实验和真实低资源语言研究的论文会被保留。在得到的筛选集合中,作者随机抽取论文进行详细定性阅读。该抽样不以发表年份为条件,因此抽样语料代表一个跨时间的快照,而不是按年份平衡的设计。
第三个阶段是细读与标注。对于每篇选定的论文,作者通读全文并记录三类证据:论文如何定义 “low-resource” 或 “under-resource”,研究了哪些语言,以及这些语言关联着哪些额外挑战。该标注过程通过将叙述性定义转化为可分析类别来落实研究问题。当论文提供明确定义时,作者直接使用该定义。当定义依赖先前工作时,他们追踪被引用来源,并将该来源视为有效定义。当没有明确定义可用时,他们从论文描述的挑战中推断作者隐含的标准,例如数据有限、语言描述有限或技术基础设施有限。
第四个阶段是主题综合。作者使用归纳编码,这意味着类别来自反复阅读和讨论,而不是来自预定义的编码体系。通过迭代标注和协作讨论,他们把反复出现的模式整合为更高层级的主题。这一综合过程将单篇论文定义转化为概念架构,解释低资源标记反复使用的维度。
作者将这些维度组织为概念层级。参见框架图。
在该概念架构中,社会政治因素构成顶层。它们包括经济约束以及殖民或政治约束,这些约束会影响哪些语言获得制度支持、哪些书写系统或语料得以保存,以及哪些社区可以获得语言技术基础设施。该图将社会政治因素置于上游条件位置,因为它们同时影响资源的可获得性和语言制品的创建。
在社会政治层之下,该框架包含资源和制品。资源涵盖人力资源,例如专家标注能力、社区语言专家和技术参与者,以及参与数字语言工作所需的数字设备接入和连接能力。制品包括常被视作语言技术开发前提的有形研究输入,例如语言知识、有标注或无标注数据以及技术工具。在这种表述中,制品并未被呈现为中性的技术对象。它们受到先前社会政治条件以及资源获取情况的影响。
该框架还将社区自主性视为横向维度。作者没有把自主性放在一个单独的终端类别中,而是将其表示为跨越所有其他层。这意味着关于价值取向、优先级、语言规划、数据收集、标注实践和技术设计的决定,都受到语言社区是否参与研究以及如何参与研究的影响。在所得出的架构中,一种语言可能因为数据或工具有限而被标记为低资源,但所提出的概念设计主张,这些可观察到的短缺与更广泛的社会政治约束以及授予社区成员的决策权程度相关。
实验
实验分析明确将语言作为低资源研究的论文,比较多语和单语场景下的语言覆盖情况,并考察这些语言如何被描述、分类和论证。研究结果显示出描述深度的显著差异:更宽泛的多语研究提供更具概括性的语言信息,而更聚焦的研究则提供更丰富的语言和社群背景。对低资源标记的分析表明,数据稀缺,尤其是缺乏有标注数据,是主导标准;与此同时,计算工具有限、说话者人口规模以及数字化或在线文本的可获得性也被不一致地使用。总体而言,低资源状态主要通过异质化且以数据为中心的定义来框定,而不是通过单一标准化标准。
使用 low-resource 术语的论文被归入标注数据有限的任务和领域、模拟低资源设置以及低资源语言三类。以语言为中心的论文数量最多,模拟设置数量最少,且部分论文同时属于多个类别。low-resource 这一术语跨越数据稀缺、模拟的资源不足设置以及语言层面的分类。研究低资源语言的论文在检索结果中占主导。与以语言为中心或任务和领域的使用相比,模拟低资源设置较不常见。数据可获得性是将一种语言标记为低资源时最常用的标准。在所研究的低资源语言中,印欧语系语言数量最多,其次为尼日尔-刚果语系和南岛语系。
该分析将低资源状态视为多维度的,并建议使用术语明确问题属于社会政治、资源相关还是制品相关。建议使用的术语涵盖语言活力、网络可见性、专家可获得性、正字法和文档质量。上下文还表明,当前将一种语言称为低资源最常见的依据是数据可获得性,尤其是有标注数据。明确的术语将语言资源的经济、政治、说话者、在线存在、专家和制品方面区分开来。数据缺失仍然是主导的分类信号,其中有标注数据尤为关键,而其他因素则影响语言选择和干预措施。
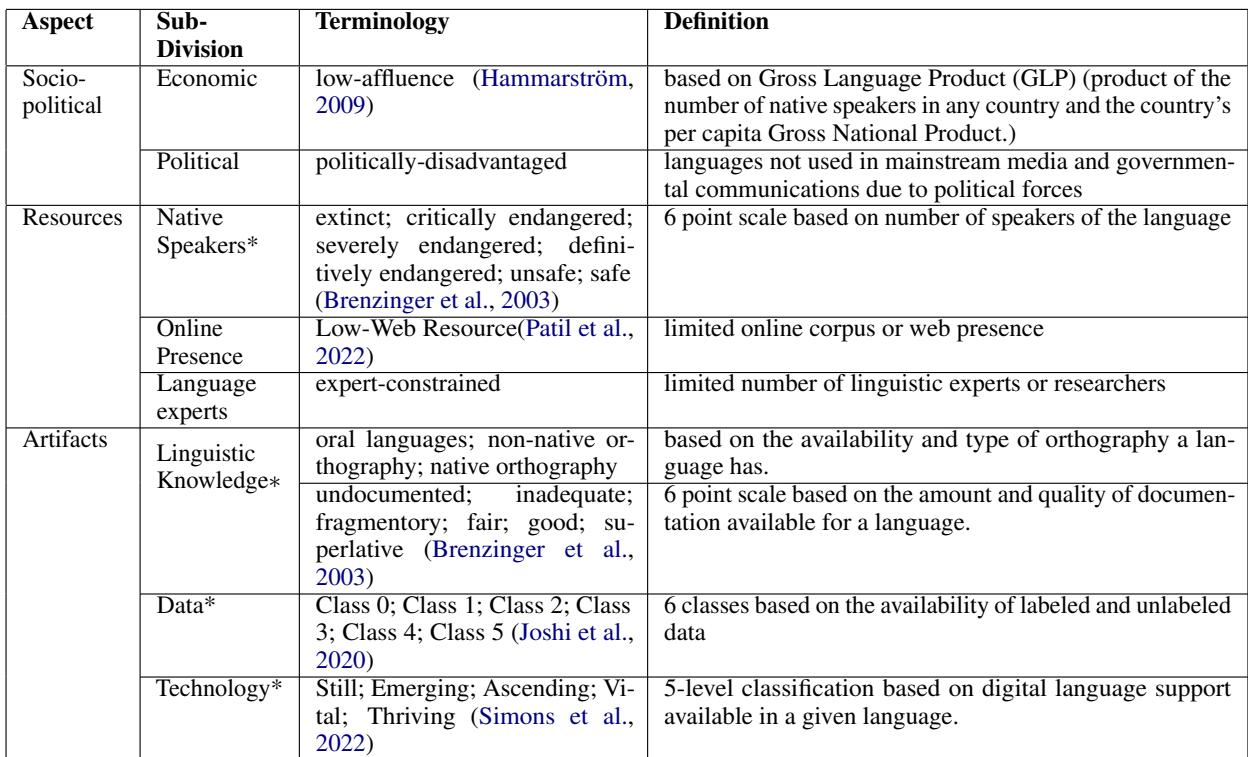
该分析将使用 low-resource 术语的论文组织为任务领域、模拟和以语言为中心三类,其中以语言为中心的研究最为常见,模拟设置最少见。它考察低资源标记如何被分配,发现数据稀缺,尤其缺乏有标注数据,占据主导,同时印欧语系等语系所占比例较高。基于此,它验证了一个多维术语框架,该框架区分社会政治、资源相关和制品相关因素,例如活力、网络可见性、专家可获得性、正字法和文档质量。