Command Palette
Search for a command to run...
大语言模型能否生成人类水平的叙事?
大语言模型能否生成人类水平的叙事?
Yufei Tian Tenghao Huang Miri Liu Derek Jiang Alexander Spangher Muhao Chen Jonathan May Nanyun Peng
摘要
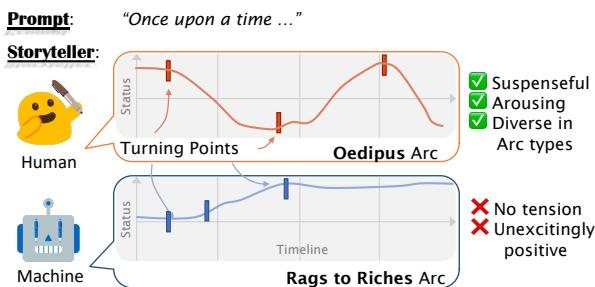
本文研究了大语言模型(LLM)在故事生成方面的能力,聚焦于叙事发展与情节推进。我们提出了一种新颖的计算框架,从三个话语层面的特征对叙事进行分析:i)故事弧线,ii)转折点,以及 iii)情感维度,包括唤醒度和效价。通过结合专家标注与自动标注,我们揭示了 LLM 生成的故事与人类撰写的故事之间存在显著差异。人类撰写的故事具有悬念感、高唤醒度和多样化的叙事结构,而 LLM 生成的故事则呈现同质化的积极情感且缺乏张力。随后,我们将叙事推理能力作为生成能力的先决条件进行度量,发现大多数 LLM 在话语理解方面远不及人类水平。最后,我们表明,显式整合上述话语特征可以有效提升故事生成质量——在多样性、悬念和唤醒度方面,神经故事生成性能提升了超过 40%。
一句话总结
来自 UCLA、USC 和 UC Davis 的研究人员提出了一种计算框架,通过故事弧线、转折点和情感维度来分析叙事,揭示 LLM 生成的故事缺乏人类叙事的多样性与张力,并表明显式整合这些话语特征可使神经故事生成提升超过 40%。
核心贡献
-
本文提出了一种计算框架,通过故事弧线、转折点和情感维度来分析叙事,并使用专家标注和自动标注来衡量叙事结构、情绪唤醒与效价。
-
本文对人工撰写与 LLM 生成的故事进行了定量比较,并结合叙事推理测量,发现人类故事更具悬念、更具唤醒感且结构更多样,而许多 LLM 故事同质化地偏向积极结局,并在挫折与高潮等转折点上表现薄弱。
-
本文表明,显式纳入故事弧线、转折点与情感特征能够改进神经故事生成,报道的多样性、悬念与唤醒提升超过 40%。
引言
随着大型语言模型越来越多地用于故事创作,理解其叙事结构非常重要,因为故事会影响受众参与度、情绪反应与社会意义。现有评估往往关注流畅性、连贯性或对创造力的宽泛判断;先前研究指出情节漏洞、主题重复、节奏薄弱等全局性不足,但缺少可用于话语层面分析的定量框架。作者通过分析三个层面的叙事来弥补这一缺口:故事弧线、转折点,以及唤醒和效价等情感信号。作者构建了一个包含人工标注与自动标注的电影梗概数据集,用它比较 LLM 与人类在故事创作和理解上的表现,并提出话语感知提示,以提升多样性、悬念与参与度。
数据集
-
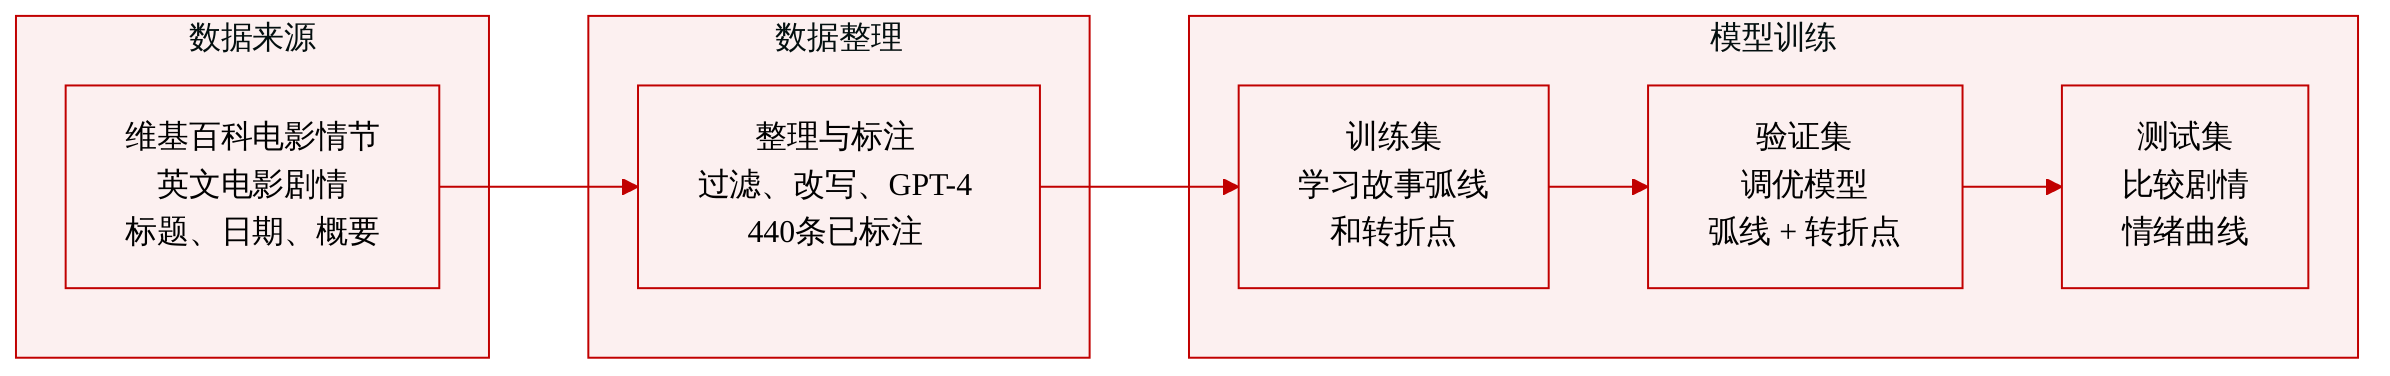
作者基于电影剧情构建叙事数据集,主要来源是维基百科列出的近期英语电影。原始记录包括电影标题、类型、上映日期和剧情梗概。
-
为降低热度偏差并减少潜在数据泄漏,作者使用维基百科页面长度作为近似热度信号,过滤知名电影。该过滤步骤留下 819 条人工撰写的电影梗概。
-
为进一步降低污染风险,作者通过改变专有名词等唯一标识符,对每条梗概的标题和初始设定进行改写。随后,作者使用 GPT-4 为每部电影生成配对的机器撰写梗概,输入包括改写后的标题、初始设定和类型。最终语料库共包含 1638 条梗概,由人工撰写与 GPT-4 撰写的配对叙事组成。
-
人工叙事与机器叙事在长度上大致相当。整体来看,平均剧情包含 705.6 个词和 37.8 个句子,使这些数据比许多其他定量叙事数据集更长、更复杂。
-
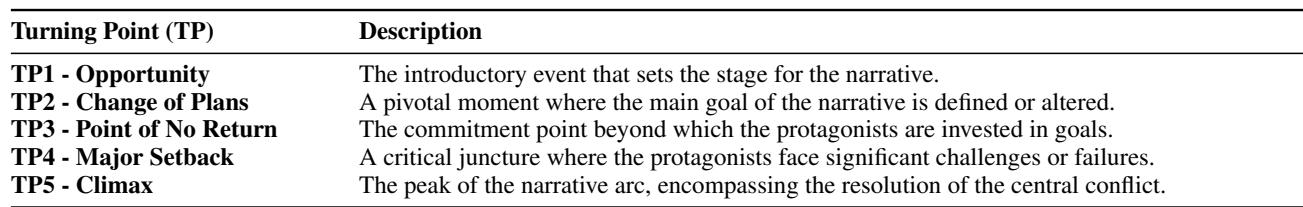
在标注方面,作者选择 440 条叙事进行深入人工标注。每条被选中的叙事由三名具有英语背景或故事分析背景的标注者标注。标注任务要求为每条梗概分配故事弧线,并定位五个句级转折点。
-
转折点标注体系改进了先前的故事结构标注方式,允许 TP3 与 TP4 灵活定位,并在标注者不确定时允许 TP2、TP3 与 TP4 出现缺失位置或多个位置。在一项任务中,使用 Spearman 相关系数报告的标注者间一致性为 0.90;在另一项任务中,使用 Cohen kappa 报告的一致性为 0.62。
-
作者使用这些数据来分析电影叙事中的话语结构,比较人工撰写与 GPT-4 撰写的剧情。作者还采用基于 agentic 的唤醒与效价分析:GPT-4 识别主角,并为每个句子推断三个情绪形容词,作者再使用 NRC VAD 词典将这些形容词映射为唤醒与效价分数。每个句子的情绪分数会取平均值,并在叙事长度上插值,最后聚合为平均曲线以进行比较。
方法
该方法被构建为一个受控的叙事分析与生成流水线。作者首先构建由人工叙事与机器叙事组成的配对语料库。作者收集近期英语电影梗概,并使用维基百科页面长度作为替代信号过滤热门电影,以降低数据泄漏可能性。随后,作者通过改变专有名词和唯一标识符,对剩余叙事进行匿名化处理。再将修改后的标题、初始设定和类型交给大型语言模型,生成与人工撰写梗概配对的机器撰写梗概。这样得到一组比较数据,其中人工叙事与机器叙事长度相近,并以相同初始故事设定为基础。
标注模块将原始叙事转换为结构化的话语标注。标注者为每个故事标注故事弧线,并识别五个转折点的句子位置。该标注体系针对更长、更复杂的故事调整了转折点定义,允许部分转折点具有灵活位置,并在不确定情况下允许缺失位置或多个位置。标注者通过资格任务接受训练和评估,并且每条叙事由多名标注者审查。最终标注结果支持后续对叙事结构、节奏和弧线分布的测量。
在情感测量方面,作者使用基于大型语言模型推理的 agentic 流程。给定一段叙事,模型首先识别主角。对于每个句子 si,模型推断三个情感描述符 Wi={wi1,wi2,wi3},用于刻画主角在该情节节点上的情感状态。这些描述符使用归一化到 [0,1] 的效价词典映射为唤醒与效价分数。对于每个句子,分别计算平均唤醒值和平均效价值,得到 A(si) 和 V(si)。对于包含 N 个句子的叙事,这些数值相对于句子位置 Ni 绘制成图,经插值形成平滑曲线,并在多条叙事之间取平均,得到聚合的唤醒轨迹或效价轨迹。
生成与改进模块使用话语特征来指导故事写作。作者并非一次性生成故事,而是采用先规划后生成的方法:模型先生成大纲,再将其扩展为完整叙事。设计了多个变体,使显式话语结构的程度逐步增强。基础变体要求模型先生成大纲,再进行扩展。较强的变体要求模型在大纲中加入关键转折点,例如不可回头点、重大挫折和高潮,并附上它们的定义。另一个变体用人工撰写的对应内容替换部分机器生成的转折点。这些变体用于测试对叙事转折点的推理是否能提升悬念、情感参与度、情节连贯性和整体偏好。
流水线进一步扩展了弧线增强生成方法。机器生成叙事中观察到的偏差促使作者对故事弧线类型进行显式控制。人工撰写故事与机器撰写故事在弧线类别分布上存在明显差异,机器生成输出更集中地倾向于某些弧线类型,并且呈现出更少的多样曲折。请参考下图。
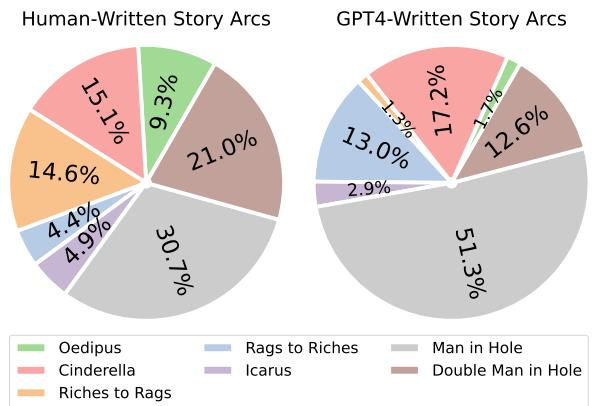
基于这一动机,弧线增强变体要求模型编写具有指定弧线、指定主要上升和下降次数、并明确描述主角初始状态与结局状态的故事。该方法从两个方向进行评估。首先,作者衡量模型遵循指定弧线结构的可靠性。其次,作者在主题、冲突类型和角色方面,比较弧线增强故事与仅大纲基线故事之间的叙事多样性。完整工作流程因此连接了语料库构建、话语标注、情感轨迹测量与结构感知提示生成,目标是使节奏、转折点和弧线选择更加显式,从而改进机器故事生成。
实验
实验比较人工叙事与 LLM 叙事,评估叙事理解能力,并测试话语感知故事生成。结果显示,LLM 在处理节奏和悬念时表现不佳,过度使用积极弧线,并且在理解叙事结构方面仍不如人类,尽管加入转折点或弧线信息可以提升理解。使用显式转折点和故事弧线进行规划后,生成的故事更具吸引力、更符合逻辑且更多样,同时标注者更喜欢具体的反转和有充分动机的情节,而不是过于直白的积极结局。
转折点是按顺序排列的叙事事件,用于塑造从铺垫到承诺、挫折与解决的情节推进。早期类型主要支持铺垫和上升动作,而挫折与高潮对确定故事弧线尤其重要。加入转折点能够改进生成叙事,优于仅大纲基线,其中自行生成的转折点带来最平衡的流程。早期转折点引入目标、风险和承诺。挫折与高潮最强烈地塑造故事弧线。转折点引导优于仅大纲生成。自行生成的转折点比强制使用人类提供的转折点更平衡。
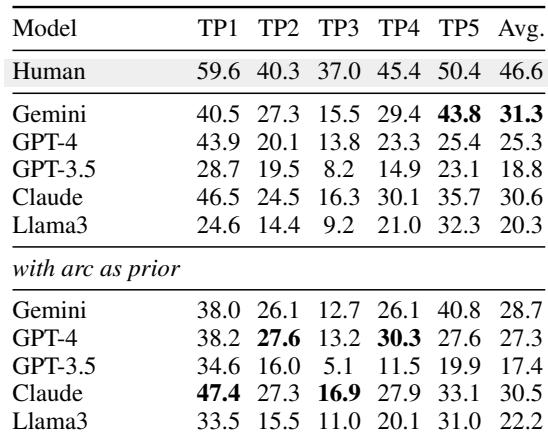
在五个类别中,人类识别叙事转折点的准确率高于所有接受测试的语言模型。Gemini 与 Claude 是最强的机器系统,GPT-4 紧随其后,GPT-3.5 与 Llama3 落后。结果表明,当没有故事弧线上下文时,当前语言模型在识别转折点方面仍难以匹配人类的叙事理解能力。人类标注者在转折点识别的整体准确率最高。Gemini 与 Claude 领先于机器模型,平均准确率超过 30%。GPT-4 表现中等,而 GPT-3.5 与 Llama3 的结果较弱。所有被评估的语言模型仍低于人类表现。
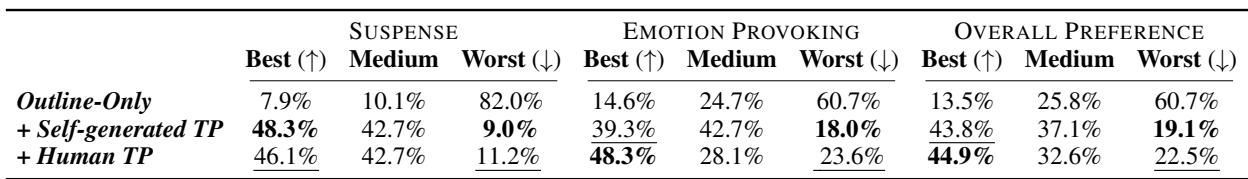
人类评估将基于普通大纲的故事与在规划中显式使用转折点的版本进行比较。在悬念、情绪激发和整体偏好方面,转折点感知方法被认为优于仅大纲基线。自行生成的转折点尤其受到青睐,因为它们能够在保持叙事流畅的同时改进故事表达。与仅大纲故事相比,转折点感知生成获得更多最佳评分并获得更少最差评分。自行生成的转折点产生最均衡的结果,低评分少于人类提供的转折点。人类提供的转折点可以增强情感参与度,但如果过于强制地施加,可能会破坏逻辑流畅性。
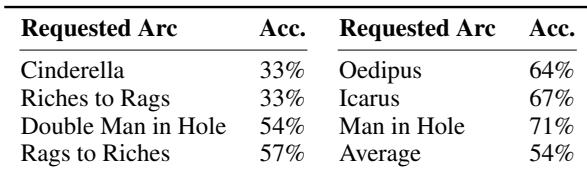
当被要求按照指定叙事弧线生成故事时,GPT-4 只有有限成功,在本次评估中整体准确率不到一半。只有一个拐点弧线的处理比包含更复杂或多次情节变化的弧线更可靠。模型在负面情节推进、低起点和复杂叙事动态方面表现最差。GPT-4 在遵循所请求故事弧线类型时准确率很低。包含一个拐点的弧线比包含两个或更多情节转折的弧线更可能成功。负面弧线、低起点弧线和复杂弧线更难让模型可靠生成。
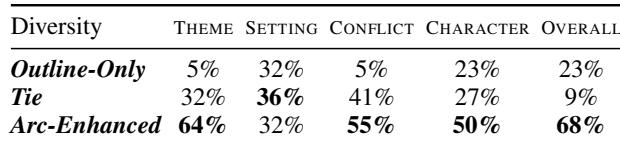
弧线增强故事在多数多样性维度上的胜率高于仅大纲故事,尤其在主题、冲突和角色方面。整体比较也更支持弧线增强故事,而设定是区分度最低的维度。这一模式表明,显式故事弧线指导能够改进仅大纲生成之外的多个叙事多样性方面。弧线增强故事在主题、冲突和角色多样性方面优于仅大纲故事。在多样性评估中,整体比较支持弧线增强故事。两种方法在设定多样性上的差异最小。
实验评估显式叙事转折点与故事弧线是否能改进大型语言模型故事生成,涵盖转折点识别、人类叙事偏好与多样性结果。在所有评估中,与仅大纲基线相比,显式转折点和弧线指导通常能提升叙事质量、悬念、情感参与度、整体偏好和多样性,其中自行生成的转折点产生最均衡且最连贯的故事。然而,所有接受测试的语言模型在识别转折点方面仍弱于人类,而 GPT-4 在处理复杂、负面或多次拐点叙事弧线时表现困难。