Command Palette
Search for a command to run...
衡量语言模型的心理深度
衡量语言模型的心理深度
Fabrice Harel-Canada Hanyu Zhou Sreya Muppalla Zeynep Yildiz Miryung Kim Amit Sahai Nanyun Peng
摘要
对大语言模型(LLM)生成的创意故事的评估通常聚焦于文本的客观属性,如风格、连贯性和多样性。尽管这些指标不可或缺,但它们无法反映故事从读者视角出发的主观心理影响。我们提出了心理深度量表(PDS),这是一个根植于文学理论的全新框架,用于衡量大语言模型创作能够引发情感、共情和沉浸感的真实且叙事复杂的故事的能力。我们通过实证验证了该框架,结果表明人类能够基于 PDS 对故事进行一致性的评估(Krippendorff's α 为 0.72)。我们还探索了自动化 PDS 的技术,以便于未来分析的大规模扩展。GPT-4o 结合一种新颖的人格混合(MoP)提示策略,与人类判断的平均 Spearman 相关系数达到 0.51;而 Llama-3-70B 在约束解码下,共情维度的得分高达 0.68。最后,我们比较了人类与大语言模型所创作故事的心理深度。令人惊讶的是,GPT-4 生成的故事要么超过了、要么与来自 Reddit 的高评分人类创作故事在统计上无法区分。通过将关注点从文本转向读者,心理深度量表为衡量大语言模型通过故事与人类建立连接的能力提供了一种经过验证的、自动化的、系统化的手段。
一句话总结
由 UCLA 研究人员提出的心理深度量表(Psychological Depth Scale, PDS)是一个基于文学理论的框架,用于衡量大语言模型生成的故事在多大程度上引发情绪共鸣与同理心。该研究通过一种用于自动评估的混合人格(Mixture-of-Personas, MoP)提示策略证明,GPT-4 生成的故事在该维度上能够匹敌甚至超越高评分的人类写作故事。
核心贡献
-
该论文提出了心理深度量表(PDS),一种基于文学理论的故事评估框架,通过读者的反应来评估故事,包括同理心、参与感、情绪激发、真实性和叙事复杂度。PDS 的人工评估得到验证,平均 Krippendorff's alpha 为 0.72。
-
使用混合人格提示策略和受限解码开发了 PDS 的自动评估。GPT-4o 与人工评分的平均 Spearman 相关系数为 0.51;使用受限解码的 Llama-3-70B 在同理心维度上达到 0.68。
-
PDS 被用于比较大语言模型生成故事与人类创作故事,结果显示 GPT-4 生成的故事超越或与高评分人类 Reddit 故事在统计上不可区分。这些结果表明,对于具有更丰富前提和提示的短文本,大语言模型能够产出与熟练人类作者可比的具有心理深度的叙事。
引言
随着大语言模型被越来越多地用于故事生成和叙事设计,关键不仅在于其文本是否流畅且风格可接受,还在于它是否能够与人类读者产生共鸣。对大语言模型生成故事的早期评估通常侧重于结构、风格、毒性或创造力等客观特征;而关于读者体验的研究往往只涉及同理心或参与感等狭窄方面,并可能依赖专业评审或简单写作提示。作者团队借助读者反应批评与文本世界理论,提出心理深度量表,该框架涵盖五个以读者为中心的维度:同理心、参与感、情绪激发、真实性和叙事复杂度。
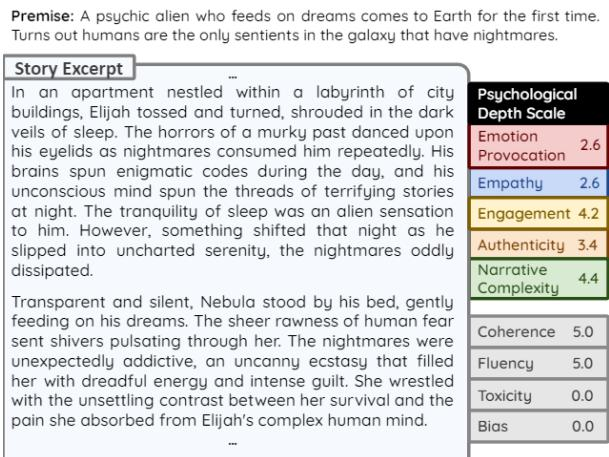
数据集
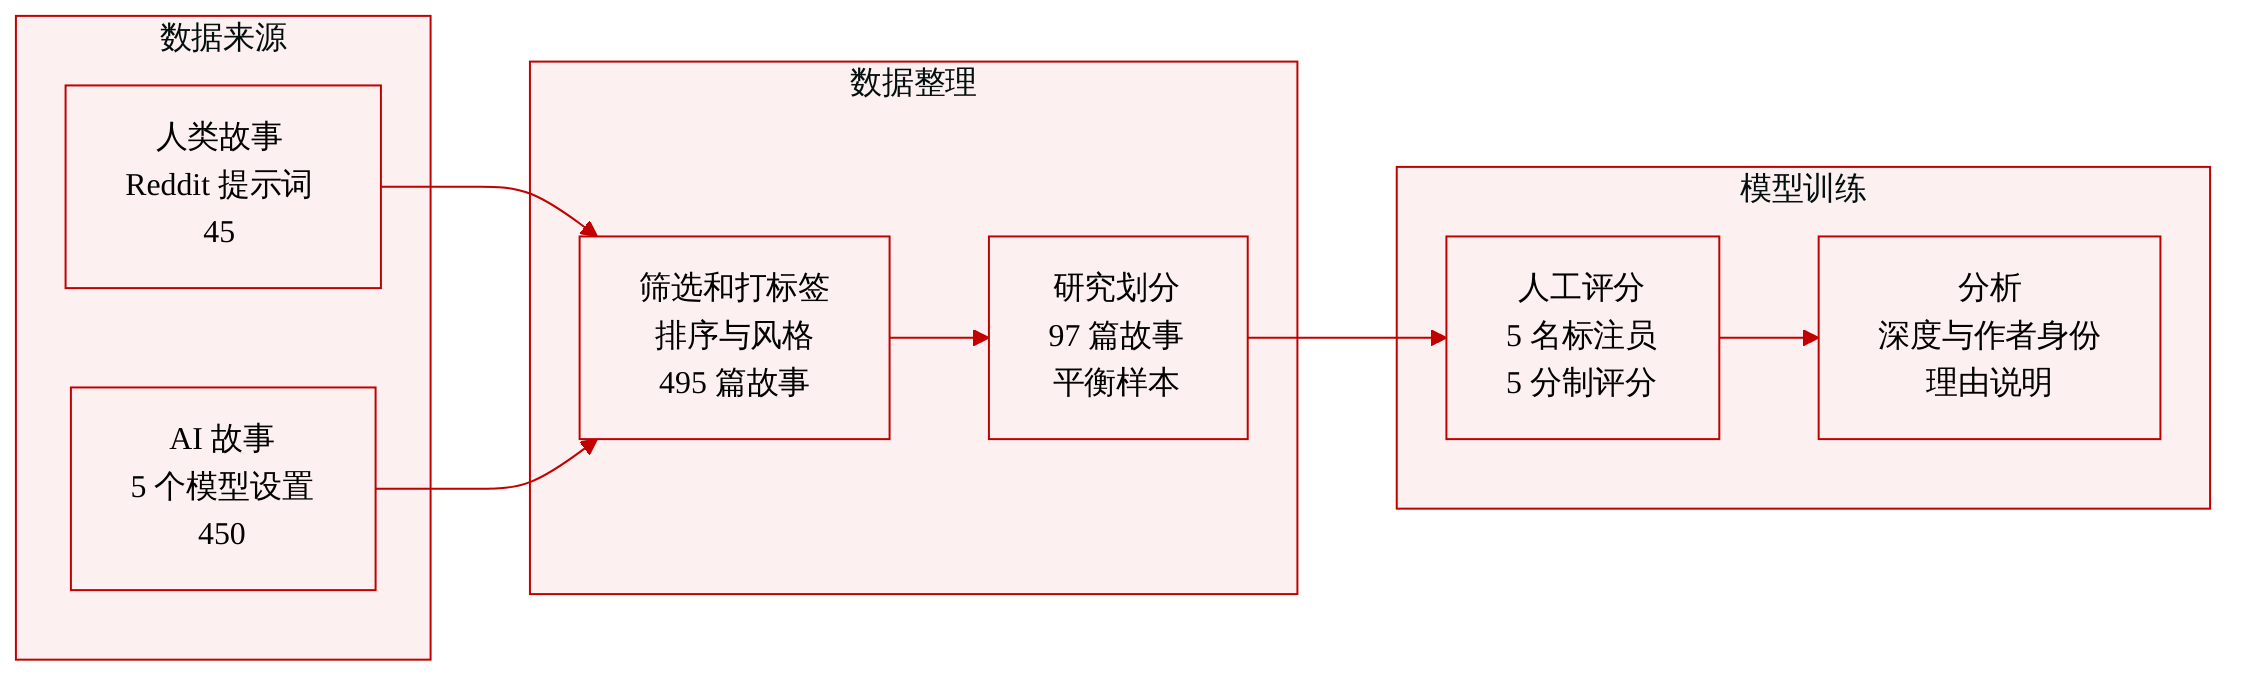
作者团队描述了 PSYCHDEPTH,这是一个基于前提与故事回答对构建的英文短篇小说数据集,并包含作者信息元数据。
-
数据集构成与规模:完整数据集包含 495 篇短篇小说,每篇平均约 450 词。其中包括 45 篇人类撰写故事和 450 篇大语言模型生成故事。每个条目将提示前提与故事回答配对,并包含描述作者身份和生成条件的元数据。
-
人类故事来源与筛选:人类故事收集自 Reddit 的 r/WritingPrompts,该在线写作社区允许用户回应提示前提。作者团队按照社区排名将故事分为 Human-Advanced、Human-Intermediate 和 Human-Novice,平均点赞数分别为 1,434、263 和 9。团队还选取彼此发布时间在 24 小时内的人类故事,以减少非质量因素对点赞数的影响。
-
大语言模型故事来源与元数据构建:大语言模型故事由五种模型配置生成:Llama-2 7B、Llama-2 13B、Llama-2 70B、Vicuna-33B 和 GPT-4。纳入 Vicuna-33B 是为了填补 Llama-2 13B 与 70B 之间的规模差距。作者团队使用 WRITERPROFILE 和 PLAN+WRITE 两种提示策略,并对每种配置采样三次生成结果。WRITERPROFILE 在提示前加入一位资深写作者的人物设定,而 PLAN+WRITE 首先生成人物画像,随后创作故事。这些生成选择被记录为元数据,以支持跨模型规模、提示方法和生成方差进行比较。
-
论文中的数据使用:完整数据集用于分析创意写作中的心理深度。作者团队未描述训练划分或模型微调混合;这些数据主要用于支持人工评估。
-
研究子集与处理:对于人工研究,作者团队使用分层抽样创建了一个 97 篇故事的较小子集,并在提示前提、作者类型和生成策略之间保持平衡。五位经过培训的标注者评估该子集中的每一篇故事。标注过程产出 2,425 条心理深度评分、485 条作者可能性评分以及 1,128 条开放式说明文本。
-
标注规范:标注者使用 1 至 5 级 Likert 量表对五个心理深度组成部分进行评分,并对作者可能性从 1 到 5 进行评分,其中 1 表示由大语言模型撰写,5 表示由人类撰写。同时收集可选的开放式说明文本。由于数据集是纯文本,因此不涉及裁剪策略。
方法
作者团队采用了一种将评估框架与受控叙事生成协议相结合的方法。核心是心理深度量表,这是一种以读者为中心的工具,用于评估人类创作和机器创作的故事。该量表不局限于句子表达的意义,而是追问叙事对读者产生了何种作用。它也将理解视为心理文本世界的动态构建过程,这意味着故事质量依据叙事在读者阅读过程中如何塑造其认知与情绪体验来评估。最终指标集合通过对广泛来源于文献的候选指标空间进行主题分析得到,最终形成五个读者可观察维度:情绪激发、同理心、参与感、真实性和叙事复杂度。
-
第一个指标,情绪激发,评估故事能否稳定诱发具有正向或负向效价的强烈情绪状态。该方法强调,情绪影响并不简单与情绪语言的数量或强度成正比。更有效的叙事应当使效价与唤醒度保持一致,因为情绪一致的表达被认为比冲突组合在认知上更有效。同理心指标评估读者是否暂时采纳人物的视角。这包括沉浸式认同、对叙述体验的认知参与以及视角转换。故事可以通过隐喻和转喻等暗示性结构来支持同理心,这些结构将人物体验与共同的人类主题连接起来。参与感指标捕捉注意力卷入程度,即故事维持专注、保持兴趣并降低分心感知的程度。参与感被视为其他叙事成就的预测因素和结果,因为一部深刻触动读者的故事往往会让读者沉浸其中,而沉浸其中的读者也更有可能产生情绪和视角层面的响应。
-
真实性指标评估叙事是否表达可识别且真实的人类经验侧面。该方法将真实性视为一种共鸣机制,因为即使描写涉及物质或心理上的差异,读者仍然能够进入并感受这些描写。该指标被认为有助于产生归属感、兴趣以及说服效果。叙事复杂度指标评估故事是否呈现复杂情节、层次化的人物发展,以及引发困惑性专注的结构,例如非线性叙述、情节反转和双重视角化。复杂度被定义为叙事深度,而不是叙述难度。一个故事可以在风格晦涩的情况下保持简单,而一个复杂的故事也可以在风格上保持清晰。复杂度也被视为动态的,因为其被感知到的深度取决于语境以及读者所处的具体体验。
-
对于模型生成故事,作者团队实现了一种受控生成流程,旨在隔离模型规模的影响,同时固定提示和采样设计。实验将架构族限制为可比的开源 Llama 模型,包括 7B、13B 和 70B 参数规模,并增加一个 33B 微调的 Llama 变体以填补规模差距,同时纳入 GPT-4 作为高能力参考模型。该协议使用五个模型、两种提示策略以及每种条件下三次采样生成,为心理深度评估提供可比的叙事输出。生成故事会经过质量控制,以移除格式错误或不符合要求的样本。
-
提示模块包含两种策略。WriterProfile 策略在提示前加入一位资深作家的人物描述,其作品以心理深度强且具吸引力的叙事著称。该设定会促使模型在处理故事提示之前优先考虑复杂心理状态和更强的情绪表达。Plan+Write 策略将短篇小说创作分解为两个阶段。第一阶段,模型基于初始前提生成人物画像,扩展主角细节,包括情绪状态和内心想法。第二阶段,模型将前提与这些人物画像整合,创作最终故事。该流程避免为场景、情节或大纲增加更多规划阶段,因为额外阶段被认为会降低短篇幅输出的连贯性和一致性。该设计为系统提供了一条轻量但结构化的推理路径,在正式创作前先规划人物心理。
实验
实验使用一项人工标注研究来验证心理深度量表,然后将其应用于基于大语言模型的评估,以及人类故事与大语言模型故事之间的比较。人工标注者在量表各组成部分之间表现出高度一致性,支持该框架的内部一致性;当大语言模型评审通过多个人格提示进行评估时,其判断与人工评分更接近,不过没有单个模型在所有组成部分上表现最优。故事比较表明,先进大语言模型的输出可以在若干深度维度上与高评分人类写作匹敌甚至更优,尽管作者身份仍然难以区分,而且模型规模本身并不能保证心理深度。
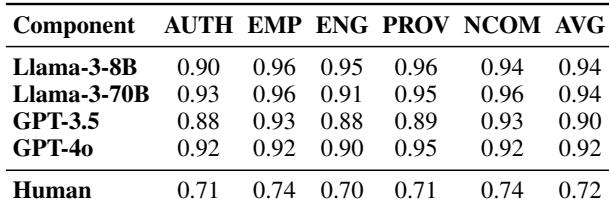
- 对于所有模型评审,各心理深度组成部分上的标注者一致性始终较高,表明混合人格提示能够产生稳定且连贯的判断。人类标注者表现出中等程度但有意义的一致性,支持该框架是评估短篇小说的实用方式。结果显示,人格变化会引入一些观点多样性,同时仍提升了与人工评分的一致性。在混合人格提示下,模型评分在所有心理深度组成部分上表现出高度一致性。人类评分的一致性较为明显,但低于大语言模型人格评审。混合人格提示增加了观点多样性,并提升了与人工评分的相关性。
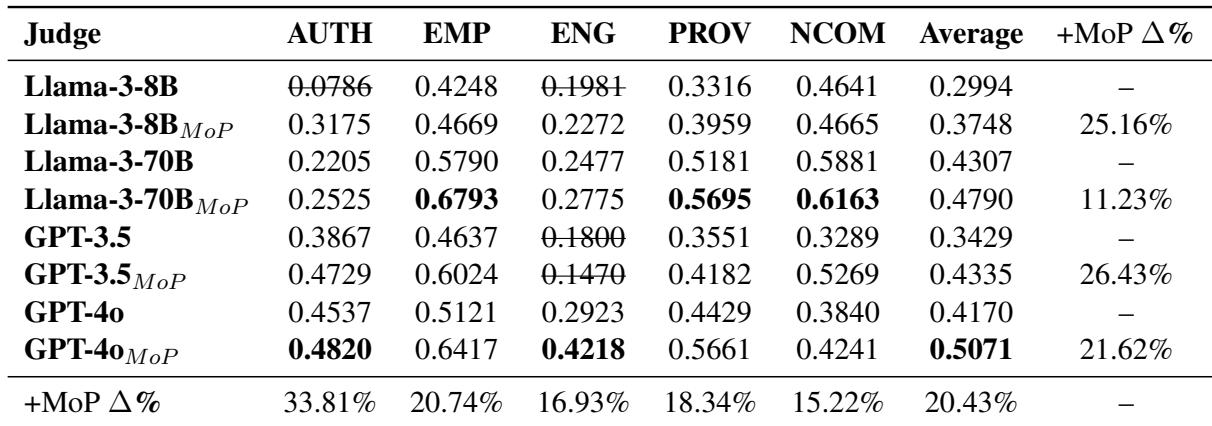
- 在所有被评估的评审模型中,混合人格提示总体上提高了平均零样本相关性,使其相对于标准零样本基线更接近人类心理深度评分。收益并非在所有深度组成部分上均匀分布,部分组成部分表现出较小或混合的变化,具体取决于评审模型。更大且为专有模型的评审通常具有更高的基线一致性,而最小评审模型在人格提示后表现出显著改进。混合人格提示提高了与人工评分的平均一致性,相对于零样本基线有所提升。更大且为专有模型的评审模型通常显示出比最小评审模型更高的基线相关性。人格提示的收益在各组成部分之间有所不同,其中参与感维度的提升一致性较低。
- GPT-4 通常获得比其它大语言模型和若干人类组别更高的平均心理深度评分,在同理心和叙事复杂度方面具有显著优势。人类故事在平均意义上被评为更像人类创作,特别是中间组别,而 GPT-4 仍然是最接近人类创作表现的大语言模型,并被认为接近人类水平。模型规模无法可靠预测深度,因为较小的 Llama 变体可能得到与新手人类相近的评分,并低于 GPT-4。GPT-4 在多数心理深度组成部分上获得最高平均评分,同时具有相对较低的标准差。人类作者在感知人类作者身份上高于大语言模型作者,其中中级人类组被认为最像人类。较小的 Llama 模型在评分上更接近新手人类写作者,而不是 GPT-4,这削弱了简单的规模与深度关系。
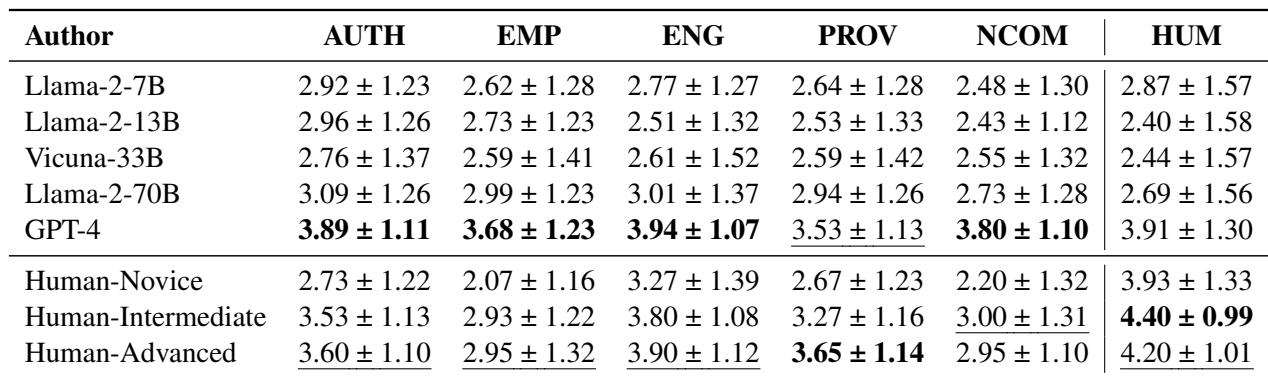
- 这些实验通过比较人工标注者与多个模型评审来评估短篇小说心理深度评分,检验混合人格提示是否产生可靠、连贯且与人工评分一致的评估。混合人格提示通常能够提高稳定性和与人工评分的相关性,同时允许更广泛的观点,但收益因深度组成部分和评审模型而异。更大且为专有模型的评审通常与人类评分的一致性更强,GPT-4 获得最高深度评分,人类故事被评为更像人类创作,而仅凭模型规模无法可靠预测心理深度。