Command Palette
Search for a command to run...
面向跨文化机器翻译的多语言知识图谱检索增强生成方法
面向跨文化机器翻译的多语言知识图谱检索增强生成方法
Simone Conia Umar Farooq Minhas Daniel Lee Saloni Potdar Min Li Yunyao Li
摘要
翻译包含实体名称的文本是一项具有挑战性的任务,因为文化相关的引用在不同语言之间可能存在显著差异。这些差异也可能源于创译——一种超越音译和逐词翻译的适应过程。本文从两个方面解决跨文化翻译问题:(i)我们提出了 XC-Translate,这是首个专注于包含潜在文化细微差别实体名称文本的大规模人工构建机器翻译基准;(ii)我们提出了 KG-MT,一种新颖的端到端方法,通过稠密检索机制将多语言知识图谱中的信息整合到神经机器翻译模型中。我们的实验和分析表明,当前的机器翻译系统和大型语言模型在翻译包含实体名称的文本时仍然表现不佳,而 KG-MT 大幅超越了最先进方法,相较于 NLLB-200 和 GPT-4 分别获得了 129% 和 62% 的相对提升。
一句话总结
罗马萨皮恩扎大学、Apple 和 Adobe 的研究人员提出 XC-Translate,这是首个面向具有文化细微差别的实体名称的大规模跨文化机器翻译基准,并提出 KG-MT。KG-MT 通过稠密检索将多语言知识图谱整合到神经机器翻译中,相比 NLLB-200 和 GPT-4 分别实现了 129% 和 62% 的相对提升。
核心贡献
- 论文引入 XC-Translate,这是首个大规模、人工创建的机器翻译基准,用于包含文化细微差别实体名称的文本,旨在测试超越音译的跨文化适应能力。
- 论文提出 KG-MT,这是一种端到端神经机器翻译方法,通过稠密检索从多语言知识图谱中检索相关实体名称,并将其整合到翻译中,而不是依赖对每一种可能的实体翻译进行合成增强。
- 在 XC-Translate 和现有机器翻译基准上的实验表明,KG-MT 在翻译包含实体名称的文本时,相比 NLLB-200 和 GPT-4 分别实现了 129% 和 62% 的相对提升,同时在通用机器翻译基准上保持可比结果。
引言
多语言大语言模型和大规模多语言数据集显著提升了机器翻译,尤其对于高资源语言。然而,翻译包含实体名称的文本仍然具有挑战性,因为这些实体名称可能包括电影、书籍、人物或地点。直译可能无法捕捉文化特定的指称,并可能产生语义错误的结果。
此前工作在这一领域进展有限。早期方法通常侧重于音译,而不是跨文化名称翻译,尤其是在共享同一书写系统的语言中,并且缺少大规模高质量基准。基于合成数据增强的方法可以提供帮助,但会增加训练成本,并且随着新实体出现需要频繁更新。
作者通过两项主要贡献弥补这一空白。他们引入 XC-Translate,这是一个大规模人工创建的基准,用于跨文化翻译包含实体名称的文本,覆盖 10 个语言对。他们还提出 KG-MT,这是一个机器翻译系统,使用来自多语言知识图谱的检索增强生成来动态检索相关实体名称翻译,从而提高性能,同时相比数据增强方法需要更少监督和更少计算资源。
数据集
-
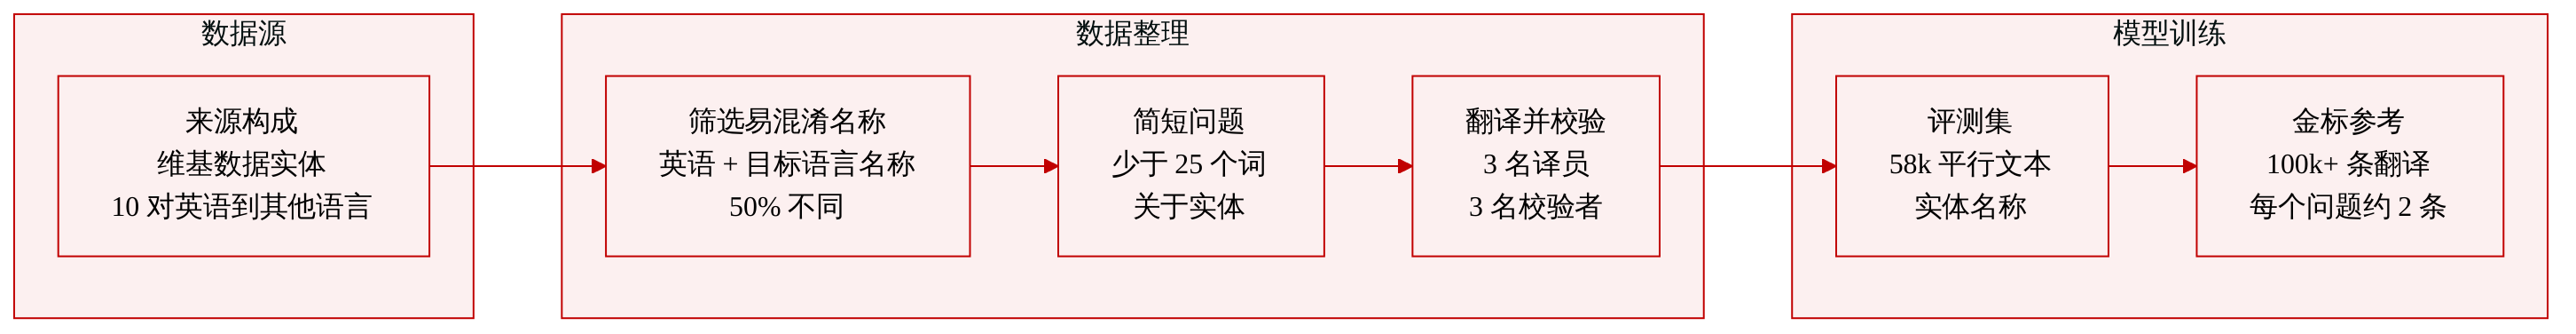
数据集:Cross-Culture Translate (XC-Translate),一个人工整理的基准,用于对包含实体名称的文本进行跨文化机器翻译评估。
-
语言对:10 个英语到 X 语对,覆盖多样的高资源和低资源语言:阿拉伯语、中文、法语、德语、意大利语、日语、韩语、西班牙语、泰语和土耳其语。
-
规模:每个语言对约有 5,000 条源句子,总计超过 58,000 个实例。
-
参考集:每条源文本都提供多个标准参考译文,总计超过 100,000 条参考译文,平均约每句 2 条参考译文。
-
实体来源:从 Wikidata 为每个语言对选择实体,并使用两项过滤条件:
- 实体必须在英文中至少有一个名称,并且在目标语言中至少有一个名称。
- 与逐词直译回英文的译文相比,英文名称与目标语言名称之间的差异必须至少达到 50%,使用 Levenshtein 距离衡量。
- 这有助于选择那些名称更可能涉及跨文化翻译挑战而不是简单音译的实体。
-
源句子构造:人工标注者针对所选实体创建简短的英文知识寻求问题,每个问题少于 25 个词。采用问题格式是为了保持文本简单,并降低引入错误事实陈述的风险。
-
翻译流程:每条英文问题通过两步人工流程翻译到目标语言:
- 至少 3 名译者生成候选译文。
- 至少 3 名标注者验证每条译文。
- 仅保留标注者一致同意的译文。
-
标注者控制:译者和验证者必须精通英语,是目标语言母语者,并居住在目标语言使用国。他们还必须通过入门测试和定期质量检查。
-
翻译过程中提供的上下文:译者会收到实体名称、来自 Wikidata 的实体描述,以及该实体在英文和目标语言中的维基百科页面,以支持正确的名称翻译和上下文理解。
-
数据集用途:论文使用 XC-Translate 评估跨文化翻译方法,尤其用于评估模型在不同语言和不同书写系统中翻译实体名称的能力。该基准没有描述训练划分或混合比例。
方法
作者利用多语言知识图谱,将机器翻译从实体记忆转向实体感知的检索与生成。该框架并没有为所有可能实体使用合成音译来增强训练数据,而是先为源文本检索最相关的实体,然后使翻译器以它们在目标语言中的名称为条件。框架图提供了总体流程概览。
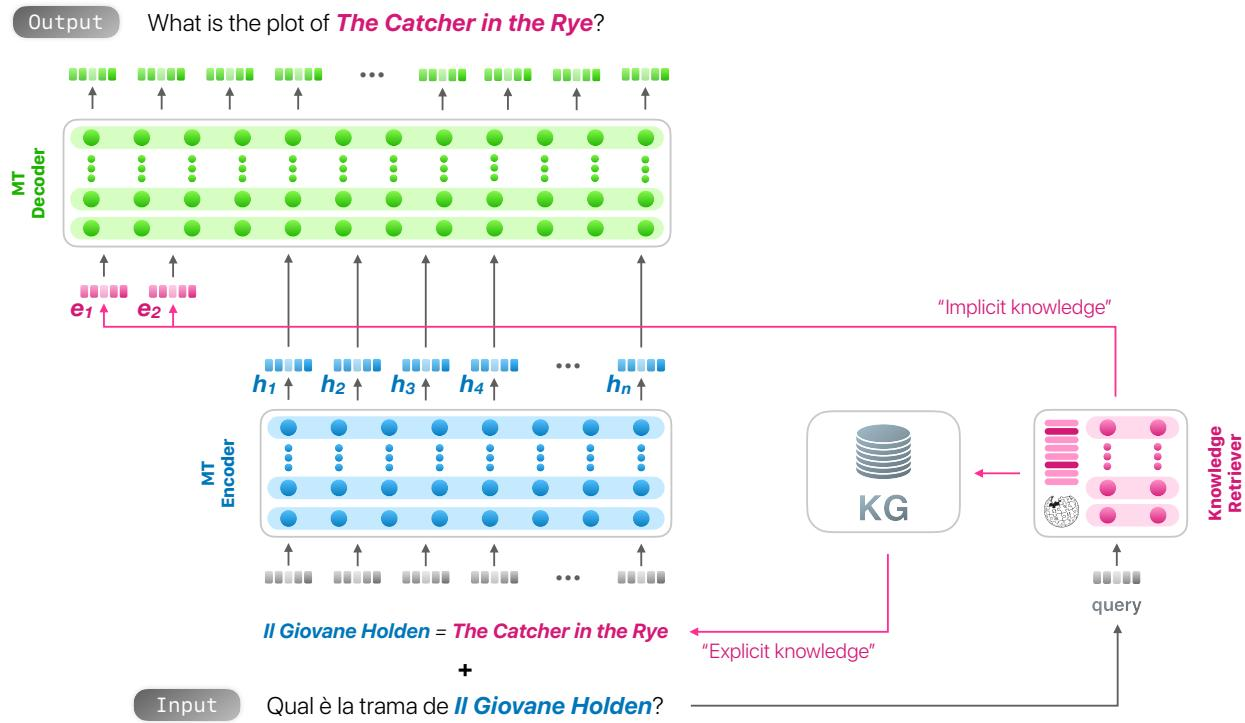
给定源语言 ls 中的源文本 t=⟨w1,…,wn⟩,知识检索器从知识图谱 G=E×R×E 中选择前 k 个相关实体,其中 E 是实体集合,R 是关系集合。每个实体 ei 表示为元组 ei=⟨ni,di⟩,其中 ni 是主要实体名称,di 是其描述。包含描述有助于区分具有相同名称的同名实体。
检索器使用余弦相似度,在实体嵌入 ei 和源文本嵌入 t 之间分配相关性分数:
s(ei,t)=∥ei∥∥t∥ei⋅t.随后获得前 k 个实体集合:
Et=topk({ei∈E∣s(ei,t)}).实体编码器使用对比目标进行训练,该目标鼓励检索相关实体,并抑制检索无关实体。对于相关正例实体 e+ 和无关负例实体 e−,训练损失为:
L=−logexp(e+⋅t)+∑i=1nexp(ei−⋅t)exp(e+⋅t).一个关键设计细节是困难负例采样策略。该方法不是从批次中随机采样负例实体,而是选择与相关实体具有相同名称但与源文本无关的同名实体。这促使检索器依赖上下文消歧,而不是表面字符串匹配。
知识增强翻译器接收源文本以及检索到的实体映射。作者构造知识增强源序列:
t+KG=⟨w1,…,wn, [KG], n1s→n1t,…,nks→nkt⟩,其中 [KG] 是实体信息开始的特殊标记,nis 是源语言中的实体名称,nit 是从多语言知识图谱检索到的目标语言对应名称。该增强序列被传递给标准序列到序列机器翻译模型,该模型经过微调以生成目标文本 t′=⟨w1′,…,wm′⟩,同时关注目标语言实体名称。作者将这一机制称为显式知识整合。
该框架还支持隐式知识整合,具体方式是利用检索器学习到的潜在表示。在使用机器翻译编码器编码增强源序列 t+KG 之后,模型获得隐藏状态 h+KG=⟨h1,…,hn+k+1⟩。随后,来自检索器的实体嵌入 ei 被前置到这些隐藏状态之前:
h+KG+E=⟨e1,…,ek, h1,…,hn+k+1⟩.解码器随后关注这个组合表示。这种融合使翻译器能够同时使用来自知识图谱的显式表面形式,以及存储在检索器实体嵌入中的更细粒度语义信息。该架构融合来自两个不同编码器的隐藏状态,即知识检索器和机器翻译编码器,而不是作为常规的单编码器 Fusion-in-Decoder 系统运行。
实验
实验使用 BLEU、COMET 以及所提出的实体级 M-ETA 评估 XC-Translate 中的实体名称翻译,同时也在 WMT 基准上检查一般翻译质量。结果表明,传统机器翻译系统和大语言模型在实体名称上表现困难,而 KG-MT 一致提升实体准确率,并在标准翻译任务上保持竞争力。消融实验进一步证实知识检索有效,显式知识整合和隐式知识整合都有帮助,并识别出知识整合仍是主要剩余挑战。
该比较汇总了 XC-Translate 上 BLEU、COMET 和 M-ETA 的结果,对比大语言模型与紧凑型多语言机器翻译系统。更大的大语言模型,尤其是 GPT-4,相比紧凑型机器翻译基线表现出更强的整体翻译质量,而原始机器翻译系统在实体敏感性能上较弱。相应分析表明,KG-MT 同时受益于显式知识整合和隐式知识整合,并且二者结合时表现最佳。GPT-4 在列出的系统中于所报告的翻译质量指标上领先。NLLB-200 是最强的紧凑型多语言机器翻译基线,但仍落后于最强的大语言模型。原始机器翻译系统更低的 M-ETA 分数表明,其对依赖知识翻译的处理不可靠。将显式知识整合与隐式知识整合结合,比单独使用任一方法更能提升 KG-MT。仅使用金标准实体只能适度提升 KG-MT,这表明知识整合是瓶颈。
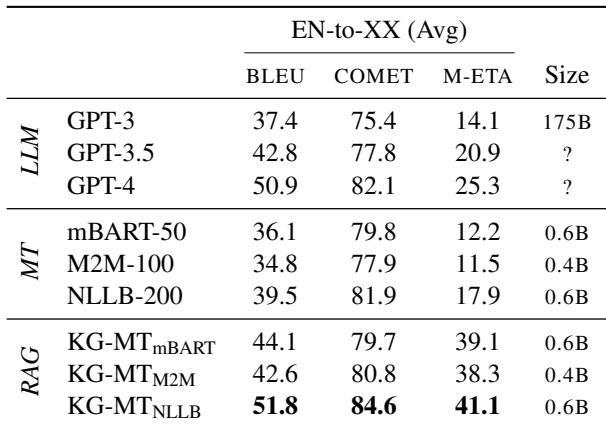
这些结果使用 BLEU 和实体感知 M-ETA 比较多语言机器翻译系统和大语言模型在各语言对上的表现,为 KG-MT 提供基线背景。在所报告系统中,GPT-4 通常表现最佳,尤其是在英语到欧洲语言的语对上。在英语到泰语上的共同弱点,以及许多语言对上实体感知评分的弱点,表明原始系统常常难以处理知识敏感型翻译。GPT-4 在大多数语言对上于 BLEU 和实体感知 M-ETA 均领先所列系统。开放的多语言模型(例如 NLLB-200)具有竞争力,但在大多数语言对上仍低于最强的大语言模型。各系统的英语到泰语分数非常低,表明实体感知翻译质量面临重大困难。
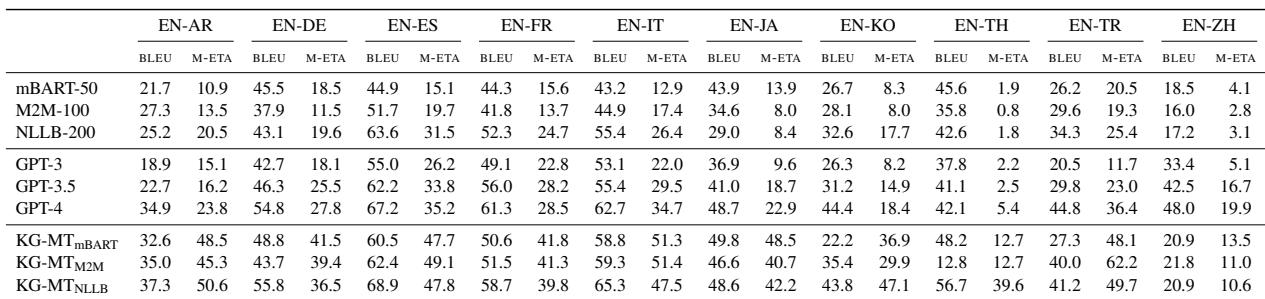
在所评估的英语到其他语言设置中,更大、更新的大语言模型比更小模型取得更强翻译质量,其中 GPT-4 总体表现最佳。所比较的多语言机器翻译模型也具有竞争力,其中 NLLB-200 的分数最接近最强的大语言模型,并且优于其他多语言系统。GPT-4 在平均翻译指标上优于 GPT-3.5 和 GPT-3。NLLB-200 是所比较中最强的多语言机器翻译模型,接近 GPT-4。
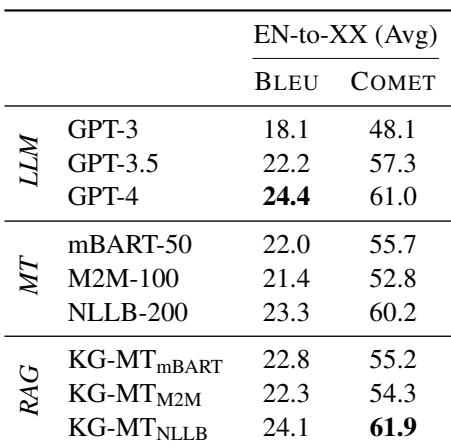
实验评估了大语言模型和紧凑型多语言机器翻译系统在多语言翻译和实体敏感设置中的表现,同时考察 KG-MT 中的知识整合。更大的大语言模型,尤其是 GPT-4,通常提供比紧凑型基线更强的整体翻译质量;NLLB-200 是最强的紧凑型模型,但仍落后于领先的大语言模型。原始机器翻译系统显示更弱的依赖知识性能,尤其在英语到泰语等困难语对上;KG-MT 在结合显式和隐式知识时提升最大,这表明有效的知识整合是关键瓶颈。