Command Palette
Search for a command to run...
基于可解释检查清单发现评估器大语言模型的盲区
基于可解释检查清单发现评估器大语言模型的盲区
Sumanth Doddapaneni Mohammed Safi Ur Rahman Khan Sshubam Verma Mitesh M. Khapra
摘要
大语言模型(LLM)日益被用于评估其他 LLM 生成的文本输出,进而影响排行榜排名和开发决策。然而,这些评估的准确性及其可能导致的误导性结论仍然令人担忧。本文研究了 LLM 作为文本生成任务评估器的有效性。我们提出了 FBI,一种新颖的框架,旨在考察评估器 LLM 在评估其他 LLM 四项关键能力方面的熟练程度:事实准确性、指令遵循、长文连贯性以及推理能力。通过对 LLM 生成的回答引入针对性扰动,使这些扰动明显影响上述某项关键能力,我们测试评估器 LLM 是否能够检测到这些质量下降。我们共创建了 2400 条扰动后的回答,涵盖 22 种扰动类别,并使用不同的评估策略对文献中常用的五个主流评估器 LLM 进行了全面研究。研究发现,当前的评估器 LLM 存在显著不足,平均超过 50% 的情况未能识别出质量下降。单答案评估和成对评估表现出明显的局限性,而基于参考的评估则表现出相对更好的性能。这些结果凸显了当前评估器 LLM 的不可靠性,并呼吁在实际应用中谨慎使用。代码和数据可在 https://github.com/AI4Bharat/FBI 获取。
一句话总结
AI4Bharat 的 Nilekani Centre 和 IIT Madras 提出了 FBI,这是一个引入 22 个类别下 2400 个定向扰动的框架,用于压力测试 LLM 评估器在事实准确性、指令遵循、连贯性和推理方面的表现,结果显示当前评估器平均在超过 50% 的情况下未能检测出质量下降。
核心贡献
-
论文提出了 FBI,一个手工构建的元评估框架,通过对候选答案施加扰动来测试 LLM 评估器在事实准确性、指令遵循、长篇写作和推理方面的表现。该框架在 22 个类别下包含 2,400 个扰动答案,用于细粒度诊断评估器弱点。
-
该工作比较了五个主流 LLM 评估器,涵盖单答案评分、成对比较和基于参考的评分,以识别暴露可靠性差距的评估协议。
-
实验表明,当前 LLM 评估器平均在超过 50% 的情况下未能识别质量下降,而基于参考的评估优于单答案评估和成对评估。这些发现表明,当前 LLM 评判器在许多实际评估场景中仍然不可靠。
引言
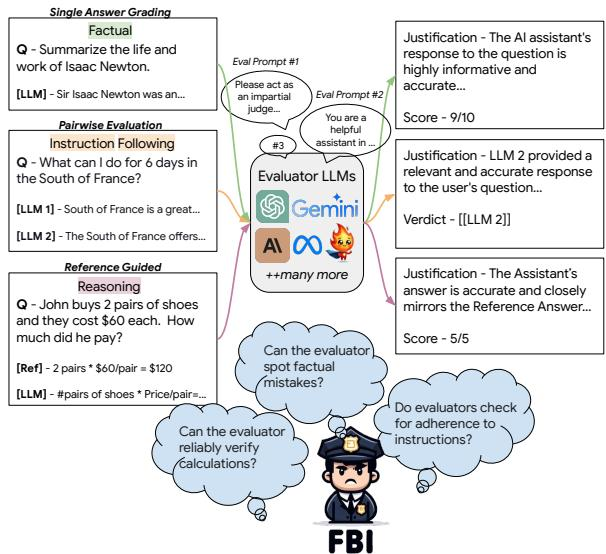
作者考察了以 LLM 作为评估器的系统。由于相比人工评估成本更低、速度更快,这类系统越来越多地用于给模型输出打分并维护 AI 排行榜。已有工作经常报告与人工判断的相关性,但可能忽略细粒度弱点,例如未能检测事实错误、指令被破坏、写作不连贯或推理有缺陷。为解决这一问题,作者提出了 FBI,这是一个使用可解释清单和定向答案扰动的框架,覆盖事实准确性、指令遵循、长篇连贯性和推理。作者使用三种评估设置证明,当前 LLM 评估器存在重大盲点,并且经常在答案质量下降时未能调整分数。
数据集
-
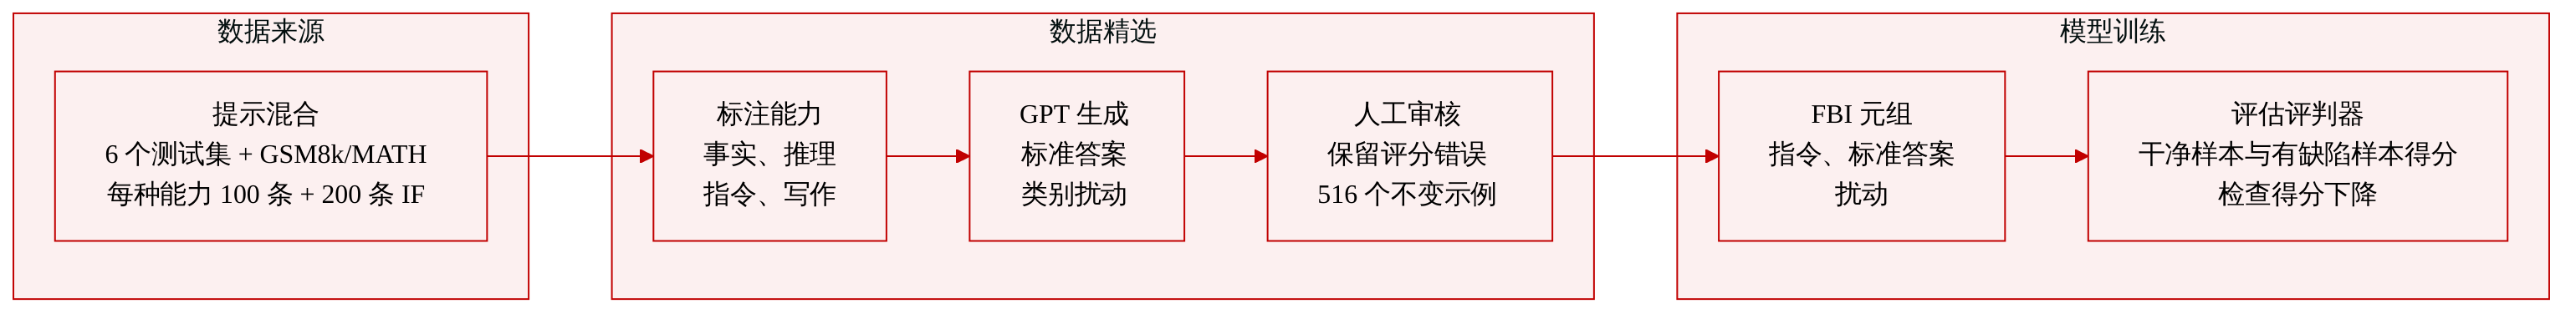
作者提出了 FBI,一个用于测试 LLM 评估器的元评估数据集。每条样本具有 (I, A_gold, A_perturb) 结构,其中 I 是指令,A_gold 是正确答案,A_perturb 是故意扰动后的答案。
-
该基准覆盖四项任务能力:事实准确性、推理、指令遵循和长篇写作。提示词被人工标注到这些类别中。
-
初始提示词池来自六个英文测试集:WizardLM、MT Bench、UltraChat、LIMA、LLMBar 和 IFEval。这些测试集包含 1809 条聚焦于长篇生成、开放式任务、创造力和指令遵循的提示词。
-
作者从该提示词池中为每项能力采样 100 个问题。推理提示词补充了 GSM8k 和 MATH,并为特定扰动类别额外创建了 200 条指令遵循提示词。
-
正确答案由 GPT-4-Turbo 生成。作者人工检查每个类别中 25% 的样本正确性,但答案的绝对质量不如扰动答案得分是否低于干净答案重要。
-
扰动答案通过向 GPT-4-Turbo 提供类别特定指令生成,并要求其解释每个扰动。在人工复核每个类别 25% 的扰动后,指令被迭代改进。
-
所有生成的扰动都经过人工审核。标注者将每个扰动答案与正确答案比较,并将其标记为有效、无效或分数不变。只有逻辑上应当导致扣分的扰动才保留为有效。
-
分数不变扰动是指不会降低得分的修改。数据集中包含 516 个这类样本,来源包括人工标注以及 GEMINI-1.5-PRO 的改写,这些改写保留了原始事实和细节。
-
数据用作评估基准,而不是训练语料。LLM 评估器会接收指令、正确答案和扰动答案,论文检查它们的得分是否正确反映明显错误的存在。
-
未报告任何裁剪策略。主要处理步骤包括提示词分类、基于 LLM 的答案与扰动生成、人工核验、扰动有效性过滤,以及分数不变负样本集构建。
方法
所提出的方法引入 FBI,这是一个用于审查 LLM 评估器检测生成答案错误能力的元评估框架。作者并不是测试评估器模型本身的正确性,而是利用该框架检查 LLM 评估器能否对包含定向缺陷的答案持续给出更低的评价。该设计以成对答案比较为中心:对于每条指令,会提供一个正确答案和一个引入特定错误类型的扰动答案。随后,评估器会在受控条件下被提示对这些答案进行打分、比较或其他判断。
在该框架的核心中,每个实例表示为一个元组 (I,Agold,Aperturb),其中 I 是给模型的指令,Agold 是参考答案,Aperturb 是参考答案的修改版本。该框架围绕四项任务能力组织:事实准确性、推理能力、指令遵循和长篇写作能力。目标不一定在于认证绝对分数,而在于测量方向性分数变化,即在引入明显错误后,Aperturb 是否获得低于 Agold 的评估。
基准构建流程从提示词选择开始。作者利用来自指令数据集的提示词,这些数据集覆盖长篇生成、开放式创造力、推理和显式指令遵循。提示词被人工分类为四种能力类型:长篇写作、事实问答、指令遵循和推理。正确答案使用 GPT-4-TURBO 生成,并由人工审阅者进行部分验证,以确保高可靠性。作者强调,正确答案的绝对质量不如错误引入过程的一致性重要,因为主要评估信号来自比较每个扰动答案与其对应的正确答案。
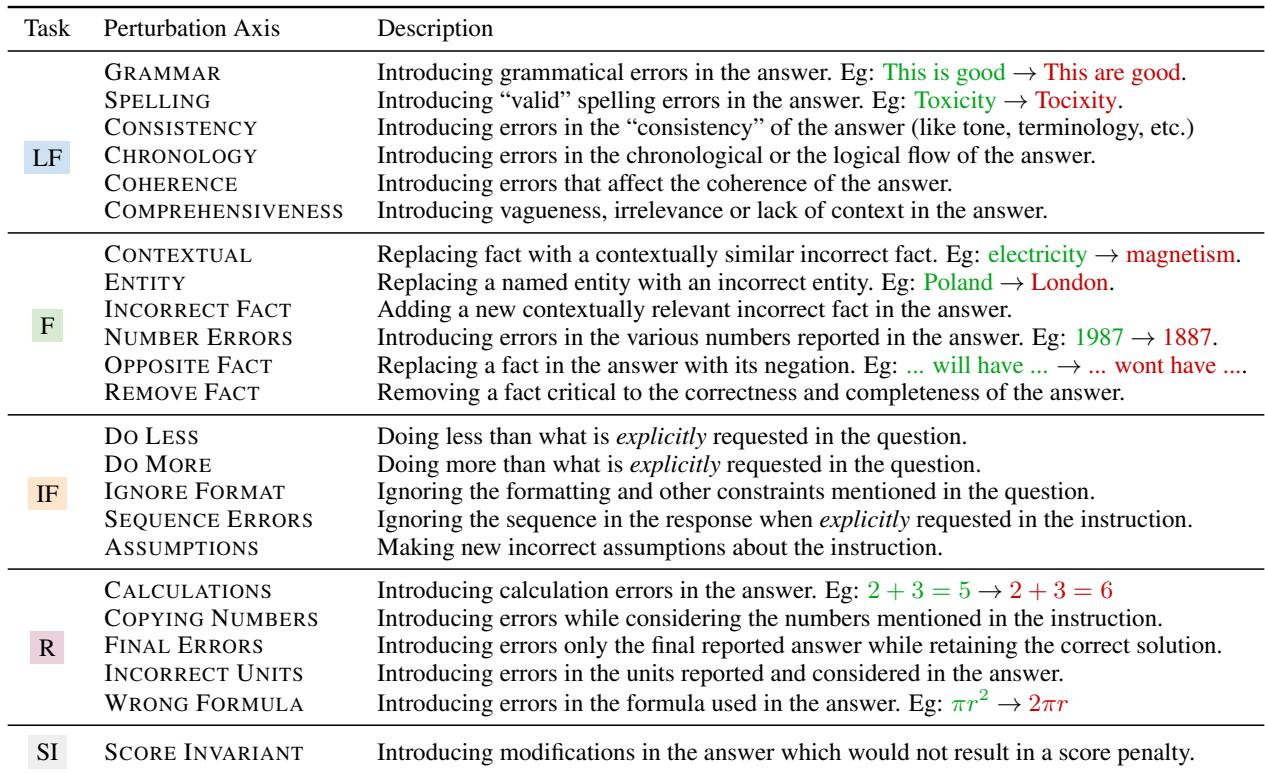
该方法的关键模块是扰动类别体系。作者在这四项任务能力上定义错误类别,其依据是当前 LLM 的常见失败模式。这些错误包括事实不准确、推理缺陷、约束被遗漏或违反、长篇连贯性退化,以及其他答案级缺陷。除了会诱发错误的扰动之外,该框架还包括分数不变扰动,即如果修改保留所有核心内容,就不应降低响应得分的修改。这种双重设计允许该基准不仅测试评估器是否会惩罚有缺陷的答案,也测试评估器是否会不必要地惩罚无害改写。
扰动答案通过使用 GPT-4-TURBO 的受控提示工作流生成。对于每个扰动类别,模型会收到说明目标错误类型的指令,并被要求生成扰动答案以及解释为什么该修改构成错误。通过人工复核生成样本,指令被迭代改进。这形成了一种反馈循环,其中模型的扰动行为被监控、纠正和改进,直到生成编辑可靠地匹配目标类别。
由于自动化生成可能在细微方面失败,作者加入了人在回路验证模块。在这一阶段,每个生成的扰动答案都会与对应正确答案比较。人工审阅者将扰动分类为有效、无效或分数不变。有效扰动必须能够逻辑上证明扣分合理,这意味着合理的评估器应当能够检测所引入的缺陷。审阅者接受过 LLM 失败模式训练,并使用专门的审阅工具来保持一致性。该步骤是方法论设计的核心,确保该基准测试的是评估能力,而不是不完美扰动生成带来的伪影。
在审计集构建完成后,框架定义了几种评估器策略。这些策略不是独立的训练模型,而是用于查询 LLM 评估器的不同提示协议。作者将它们分为三种范式:单答案评分、成对比较和参考引导评分。每种范式让评估器接触不同数量的上下文,因此测试元评估能力的不同方面。
在单答案评分范式中,评估器必须在不能直接访问修正参考的情况下评估响应。最简单的变体只呈现指令和模型响应,要求评估器输出分数。形式上可写作
f(Peval,I,Amodel)(score)其中 f 表示 LLM 评估器,Peval 是评估提示词,I 是指令,Amodel 是候选答案。一个更严格的变体要求评估器同时提供解释和分数:
f(Peval,I,Amodel)(exp,score)更多引导性变体会用额外的评估脚手架丰富提示词。在评分细则策略中,评估器会收到评分细则 R、指令和响应,并被要求先生成解释,再给出分数:
f(Peval,R,I,Amodel)(exp,score)在评估轴策略中,评估器被指示沿特定评估轴 Ax 评估答案,例如事实正确性、推理质量、指令合规性或长篇连贯性。该形式表示为
f(Peval,Ax,I,Amodel)(exp,score)作者还将这些线索组合成更丰富的协议,其中评估器会同时获得评估轴和评分细则:
f(Peval,Ax,R,I,Amodel)(exp,score)从最简提示到完整脚手架提示的这种递进,允许该方法测试评估器在获得显式评估标准时是否表现更好。
在成对比较范式中,评估器会收到两个候选响应,必须判断哪一个更好,或两者是否等价。在最简形式中,评估器只看到指令和两个响应 A1 和 A2:
f(Peval,I,A1,A2)(verdict)一个更具可解释性的变体还要求提供解释:
f(Peval,I,A1,A2)(exp,verdict)该方法进一步引入规则变体和评估轴变体。在规则策略中,评估器会收到详细的比较规则 R:
f(Peval,R,I,A1,A2)(exp,verdict)在评估轴变体中,评估器沿特定评估轴 Ax 比较两个答案:
f(Peval,Ax,I,A1,A2)(exp,verdict)组合策略同时提供评估轴和详细规则:
f(Peval,Ax,R,I,A1,A2)(exp,verdict)作者构建这些变体,以区分评估提示词、评分细则和显式评估轴是否会提升评估器察觉错误的能力。
最终范式是参考引导的单答案评分。这里,评估器会获得指令、候选答案和一个正确参考答案,并必须基于参考答案判断候选答案:
f(Peval,I,Agold,Amodel)(exp,score)该策略比无辅助变体更受约束,尤其适合能够构建可靠参考答案的任务。通过比较所有这些协议的性能,该方法评估评估器模型是否从外部指引中获益、是否能够显式推理错误,以及当同一底层失败通过不同评估界面测试时,其判断是否保持一致。
总体而言,作者利用一个紧密耦合的流程,包括精选指令、受控扰动、人工验证和结构化评估器提示,构建了一个面向 LLM 评估器的诊断系统。该框架把评估视为可测量、可测试的能力,使用明确错误类别、配对的参考答案与扰动答案,以及多种提示模式来揭示评估器模型在哪些地方成功或失败。
实验
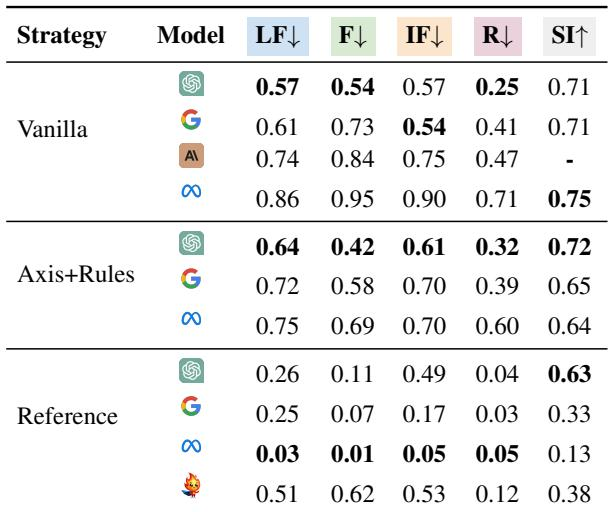
FBI 基准通过测试正确答案和人工核验扰动在事实、推理、指令遵循和长篇写作上的单答案评分、成对比较和参考引导评估,来评估 LLM 评估器,其中分数不变扰动作为对照。这些实验验证评估器是否会惩罚明显错误、是否偏好正确答案、是否避免惩罚无害变化、是否能从解释中获益,以及在更宽评分范围下是否改进,但结果表明当前模型经常无法检测扰动,尤其是在推理任务之外。GPT-4-Turbo 在无参考设置下比其它受测模型更强,但仍不可靠;而基于参考的评估可能过度惩罚正确答案,更宽评分范围只提供轻微改进。
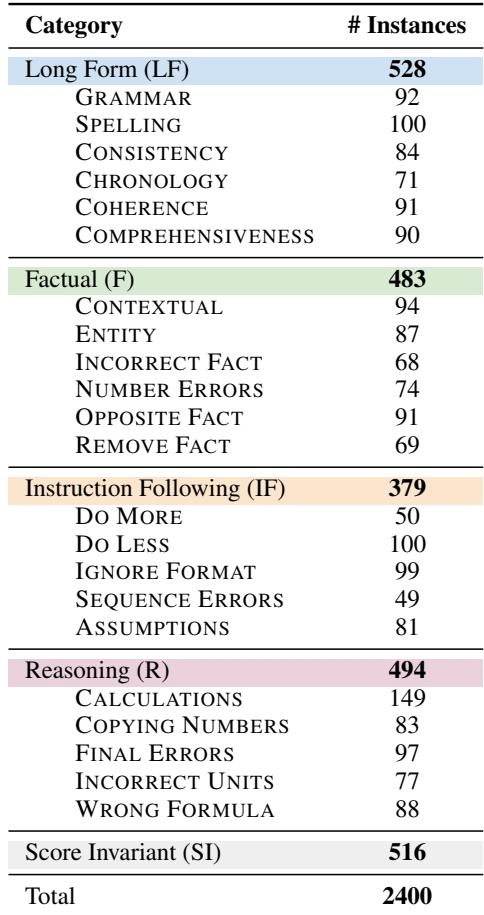
所给出的统计描述人工创建并人工核验的扰动,这些扰动用于在四项任务能力上测试 LLM 评估器。所示各行将长篇写作扰动细分成语法、拼写、一致性、时序、连贯性和全面性等类别。在这些展示的长篇写作类别中,语法和拼写的占比较高,而时序较低。该基准通过测试 LLM 评估器能否检测跨任务能力的受控答案错误来评估它们。长篇写作扰动被划分为多个人工定义类别,覆盖语言形式和篇章质量。在列出的长篇写作扰动类别中,语法和拼写更突出,而时序占比较低。
扰动目录围绕特定文本生成能力组织 LLM 评估器的检查项,包括语法、拼写、一致性、时序、连贯性、全面性和上下文事实错误。这些类别的设计目的是隔离不同失败模式,因此评估器分数只应在扰动影响目标能力时发生变化,而分数不变变化应保持分数一致。人工筛选样本和核验使这些扰动具有可解释性,有助于诊断基于模型评估中的盲点。语法和拼写扰动测试评估器是否注意到表面语言质量。连贯性、时序、一致性和全面性扰动针对长篇写作能力。上下文事实替换通过替换为错误但相似的事实来测试事实准确性。分数不变扰动为应当保持分数的评估器提供对照。
GPT-4-Turbo 是扰动敏感性较弱的评估器,因为除推理任务外,它经常在扰动后保持相同分数或判定。对于单答案评分,更简单的评估提示词在惩罚诱发错误变化时更可靠,而评分细则和评估轴提示词以牺牲这种敏感性换取分数不变变化上更高的稳定性。对于成对比较,更详细的规则有帮助,增加参考答案能明显改善检测,尽管仍存在许多失败。推理任务是最明显的例外,扰动检测更可靠。显式评分细则和评估轴可以在不提升单答案评分对细微错误敏感性的情况下增加细致程度。与单答案评分相比,成对评估从详细评估规则中获益更多。基于参考的评估强于无参考评估,但仍漏掉许多扰动答案。
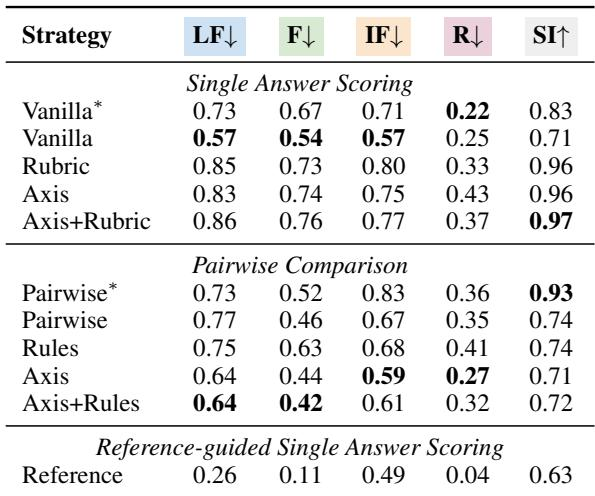
在观察到的最佳评估策略中,GPT-4-TURBO 是无参考范式中最强的通用评估器,而 LLAMA-3-70B-INSTRUCT 在基于参考的评分中看起来最强。然而,LLAMA-3-70B-INSTRUCT 非常严格,经常不给出满分,这可能表明强参考依赖,而不是可靠稳健性。Claude-3-OPUS 和一个训练后的评估器表现不如若干通用模型,而分数不变扰动揭示了剩余弱点。GPT-4-TURBO 在无参考评估中持续领先。LLAMA-3-70B-INSTRUCT 在有参考时表现突出,但异常严格,可能过度依赖参考。分数不变扰动表明许多模型仍会惩罚可接受响应。
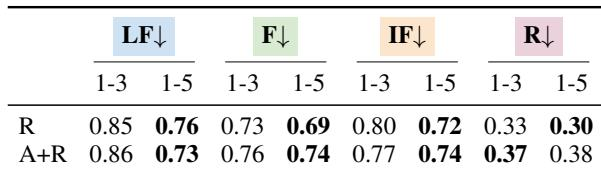
将评估器分数范围从 1-3 扩展到 1-5 通常会降低扰动答案分数保持不变的百分比,表明扰动敏感性略有提升。Axis+Rubrics 在 LF、F 和 IF 中显示出最明显的提升,同时 Rubrics 也有提升,只是 R 出现边际下降。更宽的 1-5 范围通常帮助 Rubrics 和 Axis+Rubrics 比更窄的 1-3 范围更频繁反映扰动。Axis+Rubrics 在 LF 中取得最大改进,而 Rubrics 在更宽范围下在 R 上仍略弱。
这些实验使用人工筛选并人工核验的扰动来评估 LLM 评估器,覆盖写作、事实和推理类能力,包含受控的诱发错误变化和分数不变对照。结果显示,评估器敏感性高度依赖任务和策略:更简单的提示词和更宽评分范围会提升单答案评分的错误检测,而详细规则和参考答案会帮助成对评估,但仍漏掉许多扰动。GPT-4-Turbo 在无参考设置中表现最佳,但经常对推理之外的扰动不敏感;而 Llama-3-70B-Instruct 在有参考时表现更好,但可能过于严格。分数不变测试揭示了当前评估器持续存在的弱点。