Command Palette
Search for a command to run...
OATH-Frames:利用大语言模型辅助刻画对无家可归问题的在线态度
OATH-Frames:利用大语言模型辅助刻画对无家可归问题的在线态度
Jaspreet Ranjit Brihi Joshi Rebecca Dorn Laura Petry Olga Koumoundouros Jayne Bottarini Peichen Liu Eric Rice Swabha Swayamdipta
摘要
警告:本文内容可能令人不安。公众在社交媒体上对关键社会议题所表达的态度,对于政策制定与改革具有重要价值,然而大规模理解这些态度极具挑战。本文以美国无家可归问题为研究对象,借助大语言模型的卓越能力辅助社会工作专家分析数百万条 Twitter 帖子。我们提出了一种框架分类体系——在线无家可归态度框架(OATH-Frames),包含九个层次化框架,涵盖批评、回应与认知等维度。我们发布了标注数据,其中涉及不同程度的语言模型辅助,在规模化方面展现出巨大优势:标注时间实现 6.5 倍加速,同时相较于领域专家标注仅造成 3 个点的 F 分数下降。实验表明,对 OATH-Frames 进行建模相较于现有的情感分类器和毒性分类器具有显著优势。我们对 240 万条涉及无家可归问题的帖子进行了大规模 OATH-Frames 预测分析,揭示了不同州、不同时期以及不同弱势群体间态度变化的关键趋势,为这一问题提供了新的洞见。本文为大规模理解公众对无家可归以外其他议题的细微态度提供了通用框架。
一句话总结
南加州大学研究者提出 OATH-Frames,一个用于刻画对无家可归问题的在线态度的九框架层级类型体系。其中,LLM 辅助标注相比领域专家实现 6.5× 加速,而 F1 仅下降 3 个点,从而支持对 2.4M 条 Twitter 帖子的大规模分析,并揭示各州、时间段和弱势群体之间的细微态度趋势。
核心贡献
- 论文提出 OATH-Frames。这是一个与社工专家共同开发、以框架理论和扎根理论为基础的层级框架类型体系,通过三大主题和九个议题特定框架刻画美国关于无家可归问题的在线态度。
- 论文发布关于无家可归问题 Twitter 帖子的标注,包括 4.1K 条仅专家标注、4.1K 条专家与 GPT-4 标注,以及 2.4M 条模型预测标注。通过使用 OATH 指南和思维链提示,标注速度提升 6.5x,相比仅专家标注的 F 指标性能仅下降 3 个点。
- 论文训练一个多标签 OATH-Frames 分类器,并分析 2.4M 条预测帖子。结果显示,OATH-Frames 能揭示各州、时间段和弱势群体之间的态度趋势,同时找出针对经历无家可归者的有害语言;这些语言常被情感分类器和毒性分类器误分类。
引言
社会议题上的公众舆论对倡导、政策和社会改革很重要,Twitter 等在线平台提供了可被社会科学研究者大规模分析的大规模、多样化公共话语记录。此前关于无家可归等复杂且情绪交织议题的研究,主要依赖民族志、调查和小规模内容分析,难以捕捉广泛的在线态度,尤其是当态度较为微妙、相互矛盾,或者难以被标准情感模型或毒性模型有效表示时。作者通过提出 OATH-Frames 来解决这一问题;这是一个以社会科学为基础的、用于刻画对无家可归问题在线态度的类型体系。作者还开发了一个框架,将社会工作专业知识与 LLM 辅助标注、经过引导的提示、思维链推理以及大规模分类模型相结合。该方法支持对公共话语进行可扩展的标注和分析,包括数百万条帖子,并揭示各州、时间段和相关社会群体中的细微趋势,同时识别通用分类器常遗漏的有害语言。
数据集
-
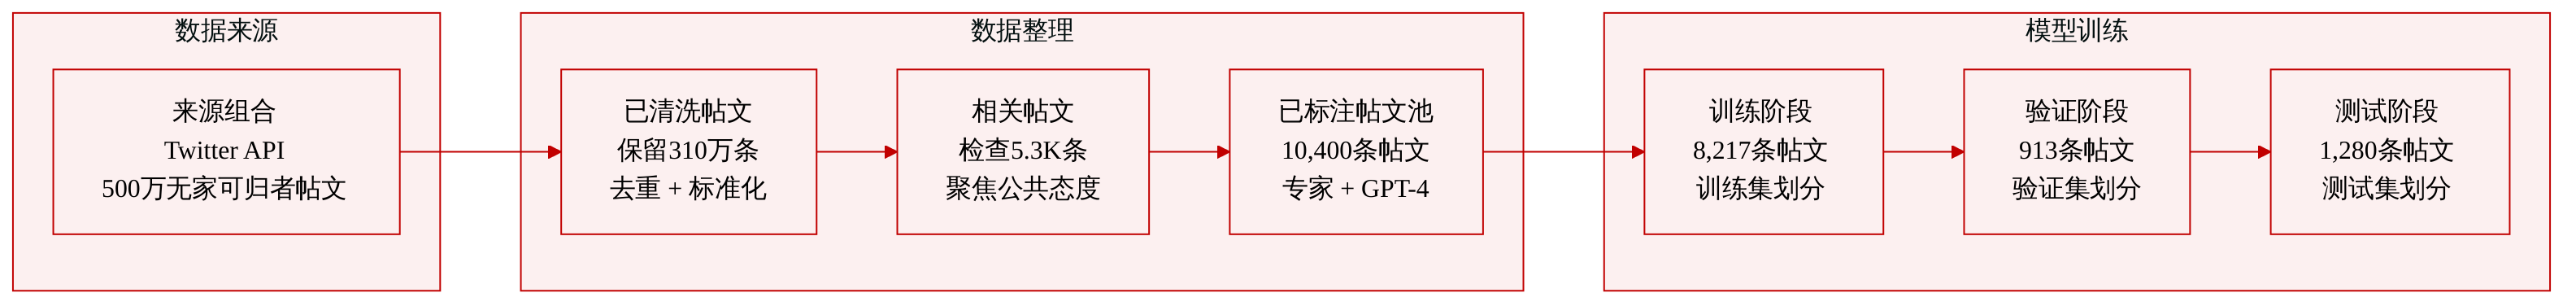
作者基于社交媒体帖子构建 OATH-Frames 数据集。他们使用关键词 “homeless” 查询 Twitter API,并采样 5M 条帖子。
-
采样的帖子经过去重、将 emoji 替换为 unicode、对用户标签进行匿名化、移除非英文帖子等预处理。处理后保留 2021 年至 2023 年间来自 2.1M 名独立用户的 3.1M 条帖子。
-
作者将数据集限定为表达对无家可归问题的公众态度和意见的帖子。他们删除模糊、信息不足或无关的帖子,例如关于政治性无家可归的帖子,也删除描述经历无家可归者自述亲历经历的帖子。
-
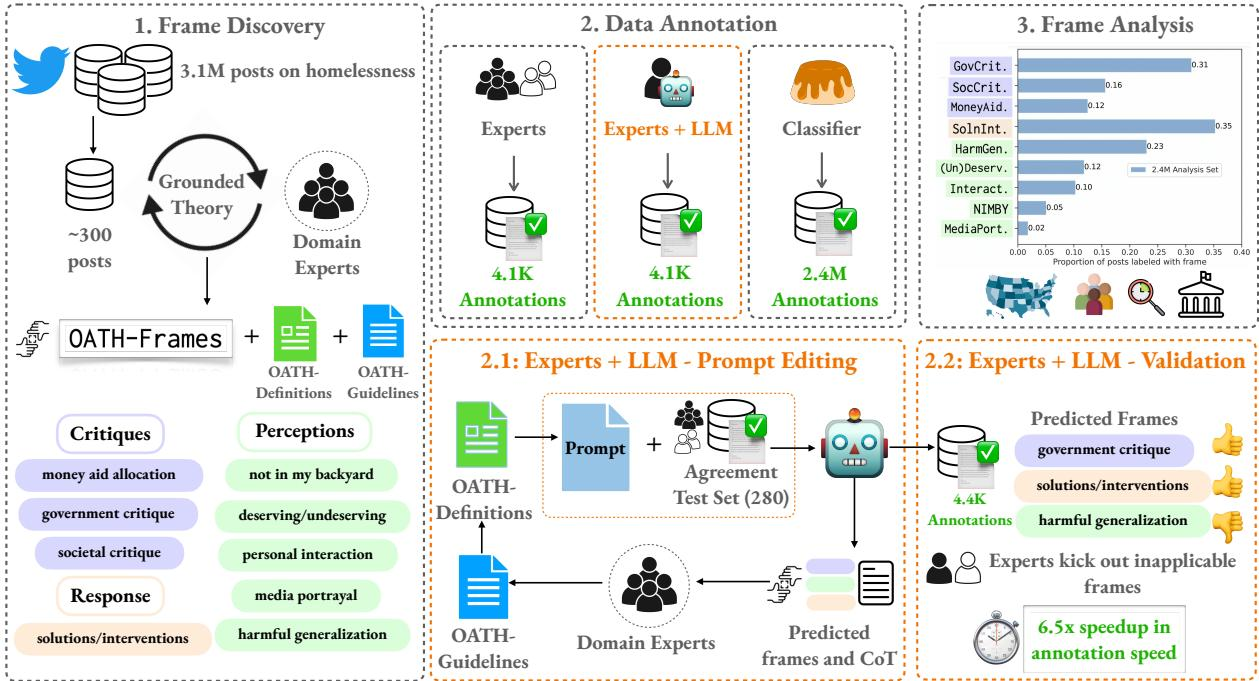
标注模式包含九个议题特定的 OATH-Frames,组织为三大主题:对系统和机构的批评、对经历无家可归者的感知,以及回应或建议行动。该任务是九框架多标签分类,54% 的已标注帖子被赋予多个框架。
-
专家标注子集最初包含 5.3K 条候选帖子,其中 1.2K 条被过滤,留下 4.1K 条专家标注帖子。标注者达到 Fleiss’ kappa 0.46 和宏平均 F1 0.55。一个 280 条多条标注子集也被用于一致性检查和独立 GPT-4 评估。
-
LLM 辅助子集以 GPT-4 对 4.4K 条帖子的预测开始。随后专家验证这些输出,并过滤掉 300 条帖子,留下 4.1K 条 Expert+GPT-4 验证帖子。专家验证移除假阳性标签并提高精确率。
-
监督训练池包含 10.4K 个示例:5.3K 条 Expert 标注、4.1K 条 Expert+GPT-4 标注,以及 1K 条过滤帖子。这些数据被划分为 8,217 条训练帖子、913 条验证帖子和 1,280 条测试帖子。
-
作者使用训练集、验证集和测试集划分,为包含九个框架和一个过滤标签的 10 路多标签任务训练分类器。训练后的模型随后用于标注 2.4M 条未标注帖子,以开展对公众关于无家可归问题态度的大规模分析。
-
未描述图像裁剪策略。数据集元数据通过文本预处理和筛选构建,包括去重、unicode emoji 规范化、用户标签匿名化、语言过滤、相关性过滤,以及由专家或 LLM 辅助专家进行的框架标签分配。
方法
方法与训练流程
作者采用一个三部分框架,将原始社交媒体话语转换为框架级标注,并使用这些标注研究公众态度。该流程始于定性框架发现,随后进入人类与 LLM 混合的标注工作流,最后由监督分类器将类型体系扩展到数百万条帖子。参见框架图。
框架发现模块
第一个模块识别有实践基础的在线对无家可归态度类型体系。从关键词样本出发,作者预处理语料库,移除重复内容、规范化 emoji、匿名化用户标签,并过滤非英文帖子。随后将候选集限定为表达公众意见的帖子,排除模糊、无关或自述亲历经历的内容。
领域专家通过迭代编码过程应用扎根理论。在每一轮中,专家独立检查采样帖子,提出简短的描述性编码,讨论边界案例,并合并相似类别,直到达成共识。该循环在刷新后的样本上重复执行,直到达到主题饱和。输出是议题特定框架的结构化类型体系,组织在三个更广泛的主题之下:对系统和行动者的批评、对经历无家可归者的感知,以及回应或建议解决方案。发现过程还生成正式框架定义和标注指南,这些内容成为后续机器辅助标注的核心资源。
LLM 辅助专家标注模块
为降低标注敏感话语的人力和情感负担,作者构建了一个协作式标注工作流,将专家监督与 GPT-4 辅助相结合。该设计包含两个相互作用的子模块:提示编辑和预测验证。如下图所显示:
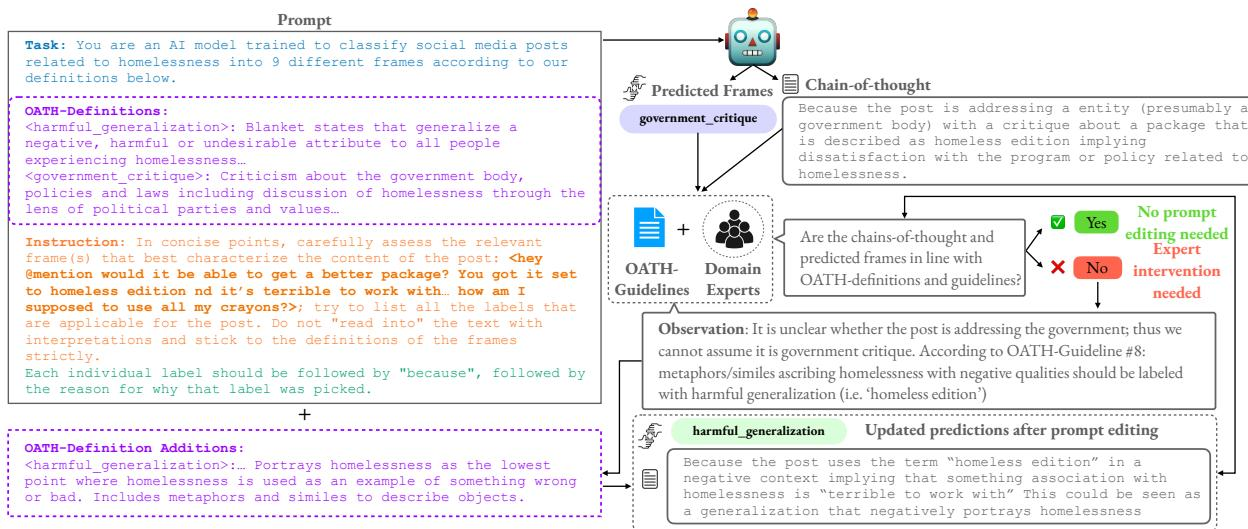
在提示编辑循环中,GPT-4 被指示根据任务描述、框架定义、简洁的标注指令和专家撰写的标注指南,将帖子分配到已发现的框架集合。模型还被要求生成思维链推理,以解释每个预测标签。在多条标注帖子构成的共享评估子集上,记为 ∣Dagreement∣=280,领域专家检查预测框架和理由是否与定义和指南一致。若不一致,专家会使用更清晰的定义或额外的指南示例更新提示。这形成一条迭代精炼流程:将专家知识注入模型提示,同时利用模型生成的理由帮助专家诊断系统性误读。
作者在该子集上以独立设置评估 GPT-4,报告精确率为 0.39±0.05,召回率为 0.64±0.05。这些结果表明标签覆盖度较合理,但假阳性率较高,尤其在帖子包含间接政治指涉或领域特定含义时;这些含义通常更容易由人类专家解决。这促使第二个子模块,即专家验证,要求标注者审查模型预测的框架,移除不适用的标签,只保留可靠标注。混合设计比完全人工标注更高效地生成专家指导的标注,并报告标注速度实现 6.5× 加速。
使用监督多标签分类器进行扩展
由于专家标注和 LLM 辅助标注在超大规模下仍成本高,作者将这些更高质量的标签蒸馏为可训练的多标签分类模型。他们从仅专家标注和专家加 LLM 标注中构建训练集,并加入应被过滤的帖子示例,得到 10.4K 个监督示例。这些数据分别划分为 8217、913 和 1280 条训练、验证和测试帖子。模型作为 10 路多标签分类器训练,其中 10 个目标输出对应九个议题特定框架,外加一个用于无需框架标注帖子的过滤标签。
作者使用 Flan-T5-Large 作为监督主干网络,将标注表述为在社交媒体帖子上生成标签。在评估中,该训练分类器优于独立的 GPT-4 提示设置,取得 0.51 的宏平均 F1。训练后的模型随后被用于为更大的未标注语料库分配框架预测。为了评估扩展是否会改变定性信号,作者比较了专家、LLM 辅助和模型预测标注集合之间的框架分布。如下图所显示:
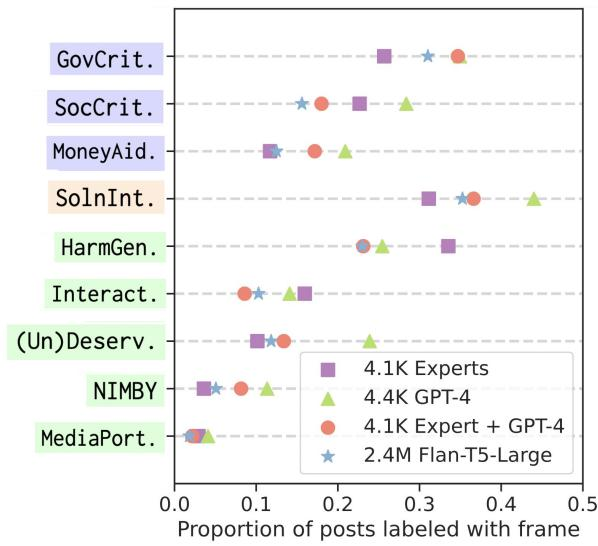
不同标注策略之间的分布相似性支持将该监督分类器用于公众态度的大规模政治与社会分析。
实验
实验验证了 Expert+GPT-4 标注工作流,并证明 OATH-Frames 比情感分类器和毒性分类器更有效地捕捉与无家可归问题相关的态度。结果显示,专家对 GPT-4 输出的审查改善了标注质量和效率,而微调模型提供了有竞争力但专业性较弱的基线。进一步分析显示,OATH-Frames 能区分区域特定态度、不同弱势群体之间的差异,以及与公共政策事件相关的时间变化,为针对经历无家可归者的有害刻板印象和观点提供更具针对性的洞察。
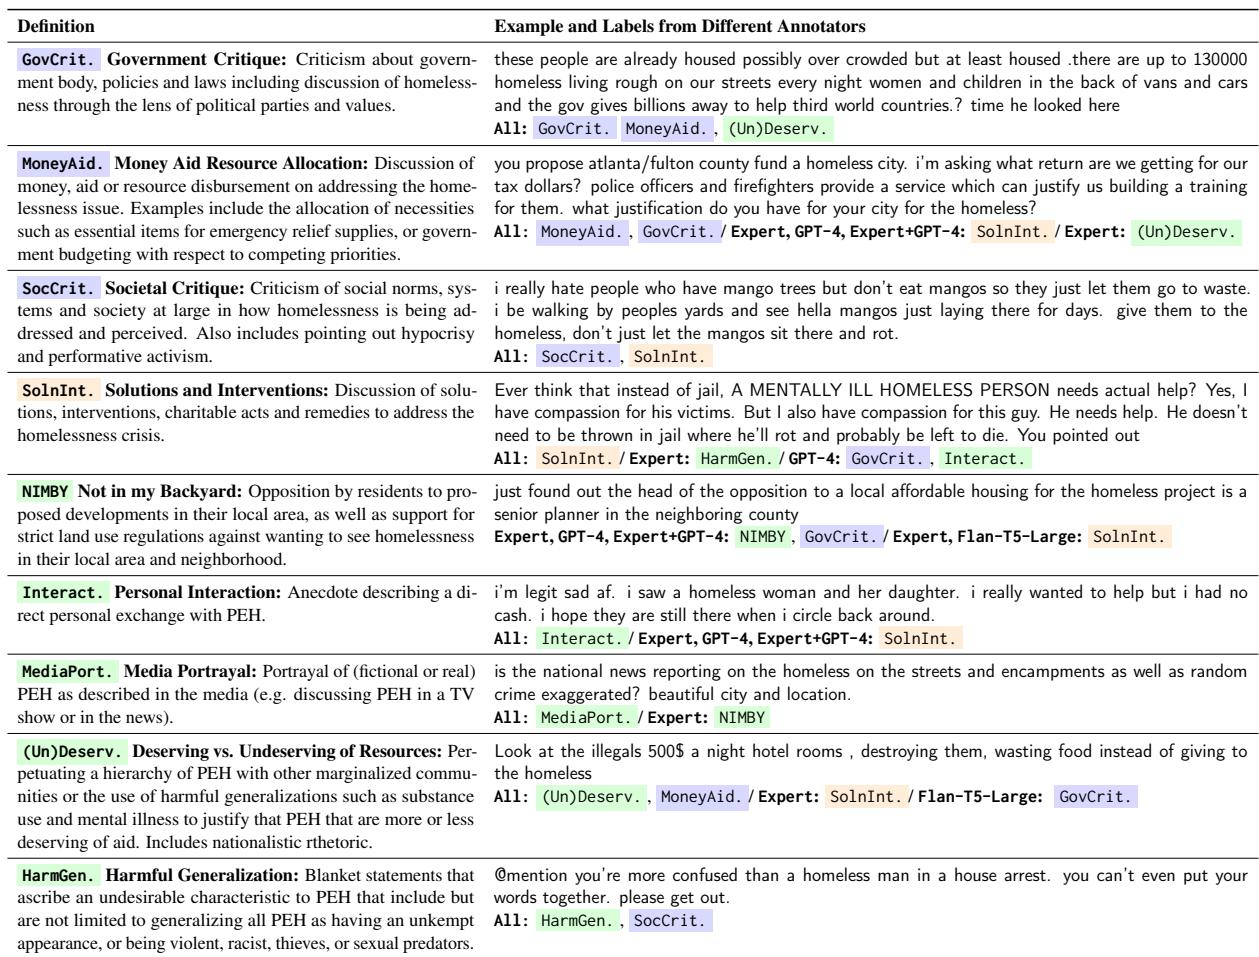
该表展示了关于无家可归问题公众态度的 OATH-Frames 类型体系,按批评、感知和回应组织。其定义和示例帖子表明,同一条帖子可以同时支持多个议题特定框架,并且专家标签与模型预测在较宽泛框架上常重叠,但在更细粒度区分上存在差异。定义和示例在三个总括主题下映射多个议题特定框架。专家和模型常为同一条帖子分配多个标签。在主要框架上常见一致意见,但预测会在相邻类别上出现分歧。
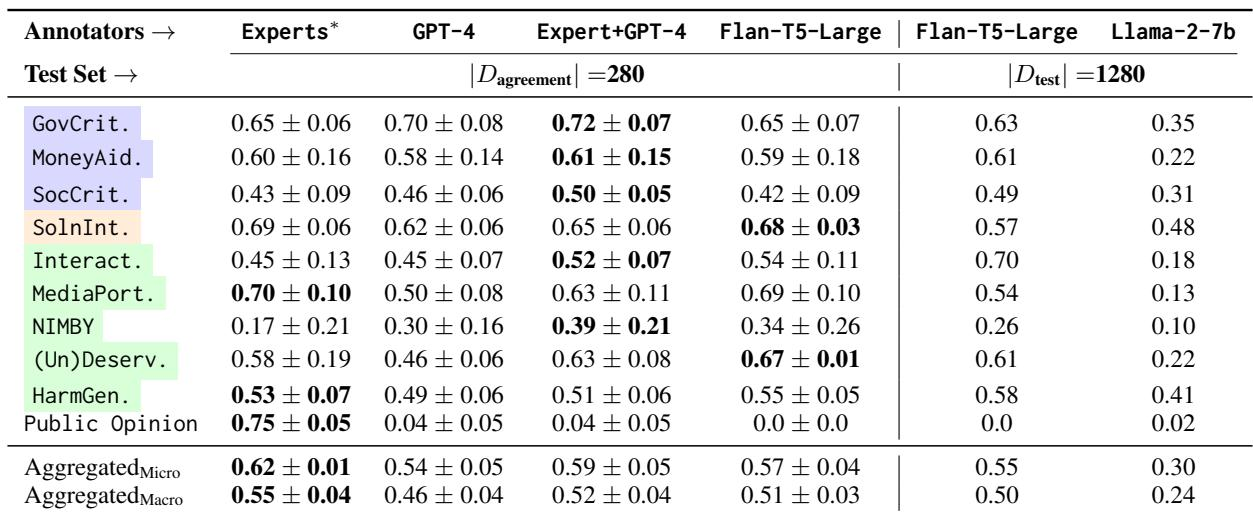
标注结果在多标签框架预测方面比较了专家标注、独立 GPT-4、协作式专家加 GPT-4 验证,以及较小的训练模型或零样本模型。在所报告的框架中,Expert+GPT-4 和 Flan-T5-Large 通常比独立 GPT-4 取得更高的 F1,而由专家导出的参考性能总体上仍更强。逐框架性能差异很大,零样本 Llama 在若干框架上的得分尤其较弱。专家对 GPT-4 输出的验证通过移除假阳性提高了精确率和整体 F1,仅带来较小的召回率代价。协作式标注工作流大幅减少了专家每条帖子所需的时间,同时相比独立 GPT-4 产生了更强的框架预测。
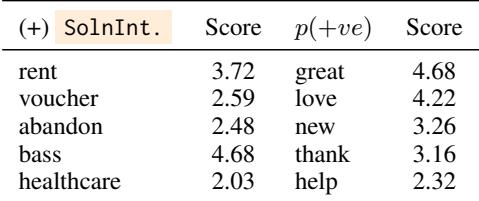
在加州相关帖子中,与解决方案和干预措施相关的词语与具体的无家可归问题相关,例如住房券、租金、医疗和本地庇护所倡议。与正面情感相关的词语更多是感恩或赞成的泛化表达,而不是具体政策或干预话题。这表明,OATH-Frames 可以呈现泛化正面情感可能掩盖的特定领域洞见。被标记为解决方案和干预措施的帖子强调租金、住房券、医疗、被抛弃,以及 Bass 倡议作为可能的话题。被标记为正面情感的帖子强调广泛的支持性词语,例如 great、love、new、thank 和 help。这种差异支持对加州无家可归问题开展有针对性的框架分析,而不是依赖粗糙的情感标签。
实验通过类型体系构建、标注比较和加州帖子的主题分析来评估 OATH-Frames。专家标注和专家与 GPT-4 协作验证相比独立 GPT-4 产生更强的框架预测,尤其通过减少假阳性并节省专家时间,而较小的零样本模型表现更不稳定。定性的词语分析进一步表明,OATH-Frames 可以揭示泛化情感标签容易掩盖的具体政策和干预问题。