Command Palette
Search for a command to run...
SUPER:评估智能体从研究仓库中搭建与执行任务的能力
SUPER:评估智能体从研究仓库中搭建与执行任务的能力
Ben Bogin Kejuan Yang Shashank Gupta Kyle Richardson Erin Bransom Peter Clark Ashish Sabharwal Tushar Khot
摘要
鉴于大型语言模型(LLMs)在代码编写方面已取得显著进展,它们能否被用于自主复现研究仓库中的结果?这种能力将对研究社区大有裨益,帮助研究人员验证、理解和扩展已有工作。为了朝这一目标迈进,我们提出了 SUPER,这是首个旨在评估大型语言模型从研究仓库中搭建与执行任务能力的基准测试。SUPER 旨在捕捉研究人员在使用机器学习(ML)和自然语言处理(NLP)研究仓库时面临的现实挑战。我们的基准测试包含三个不同的问题集:45 个带有专家标注解决方案的端到端问题、152 个源自专家集并聚焦于特定挑战(如配置训练器)的子问题,以及 604 个面向更大规模开发的自动生成问题。我们引入了多种评估指标来衡量任务成功率和进展程度,在有标准答案时使用标准答案,否则使用近似方法。我们表明,最先进的方法难以解决这些问题,其中最佳模型(GPT-4o)仅解决了端到端集的 16.3% 和场景的 46.1%。这表明了该任务的挑战性,并表明 SUPER 可以作为社区推动和衡量进展的宝贵资源。
一句话总结
Allen Institute for AI 与华盛顿大学提出 SUPER,这是首个用于评估 LLM 从研究代码仓库中自主配置并执行任务的基准。SUPER 包含 45 个附带专家标注解法的端到端问题、152 个针对具体挑战的子问题,以及 604 个自动生成问题。结果显示,最佳模型 (GPT-4o) 仅能解决端到端测试集中的 16.3%。
核心贡献
- 论文提出 SUPER,这是首个用于评估基于 LLM 的 agent 在低关注度 ML 与 NLP 研究代码仓库中配置并执行任务能力的基准,包含 45 个端到端问题、152 个子问题和 604 个自动生成问题。
- 论文通过比较答案与 gold 解法、检查里程碑状态(例如已完成的训练阶段),并对自动生成问题使用关键脚本成功执行作为信号,定义了任务成功与进展的评估指标。
- 论文在 SUPER 上评估了具备文件编辑工具的商业与开源 LLM agent,发现 GPT-4o 仅能解决 16.3% 的端到端专家任务,并解决 46.1% 的子问题场景;其在代码仓库级探索上的表现弱于在狭窄调试任务上的表现。
引言
在实证 ML 与 NLP 研究中,可复现性往往依赖于运行开源研究代码仓库,但许多低关注度仓库要求复杂的环境配置、依赖修复、数据配置、bug 解决和脚本执行。现有 LLM 编码与 agent 基准通常面向简单函数生成、流行库、孤立调试、流行仓库或单脚本 ML 实验,并不能完整测试 agent 是否能配置并执行任意研究代码仓库,同时生成正确的结果指标。作者提出 SUPER,该基准由 45 个专家整理的端到端任务、152 个带掩码的子问题和 604 个从多个低关注度仓库自动生成的任务构成,并使用最终指标、部分里程碑状态和脚本执行成功情况来评估 agent。结果显示,即使能力较强的 agent 仍然难以理解代码仓库并自动化实验。
数据集
-
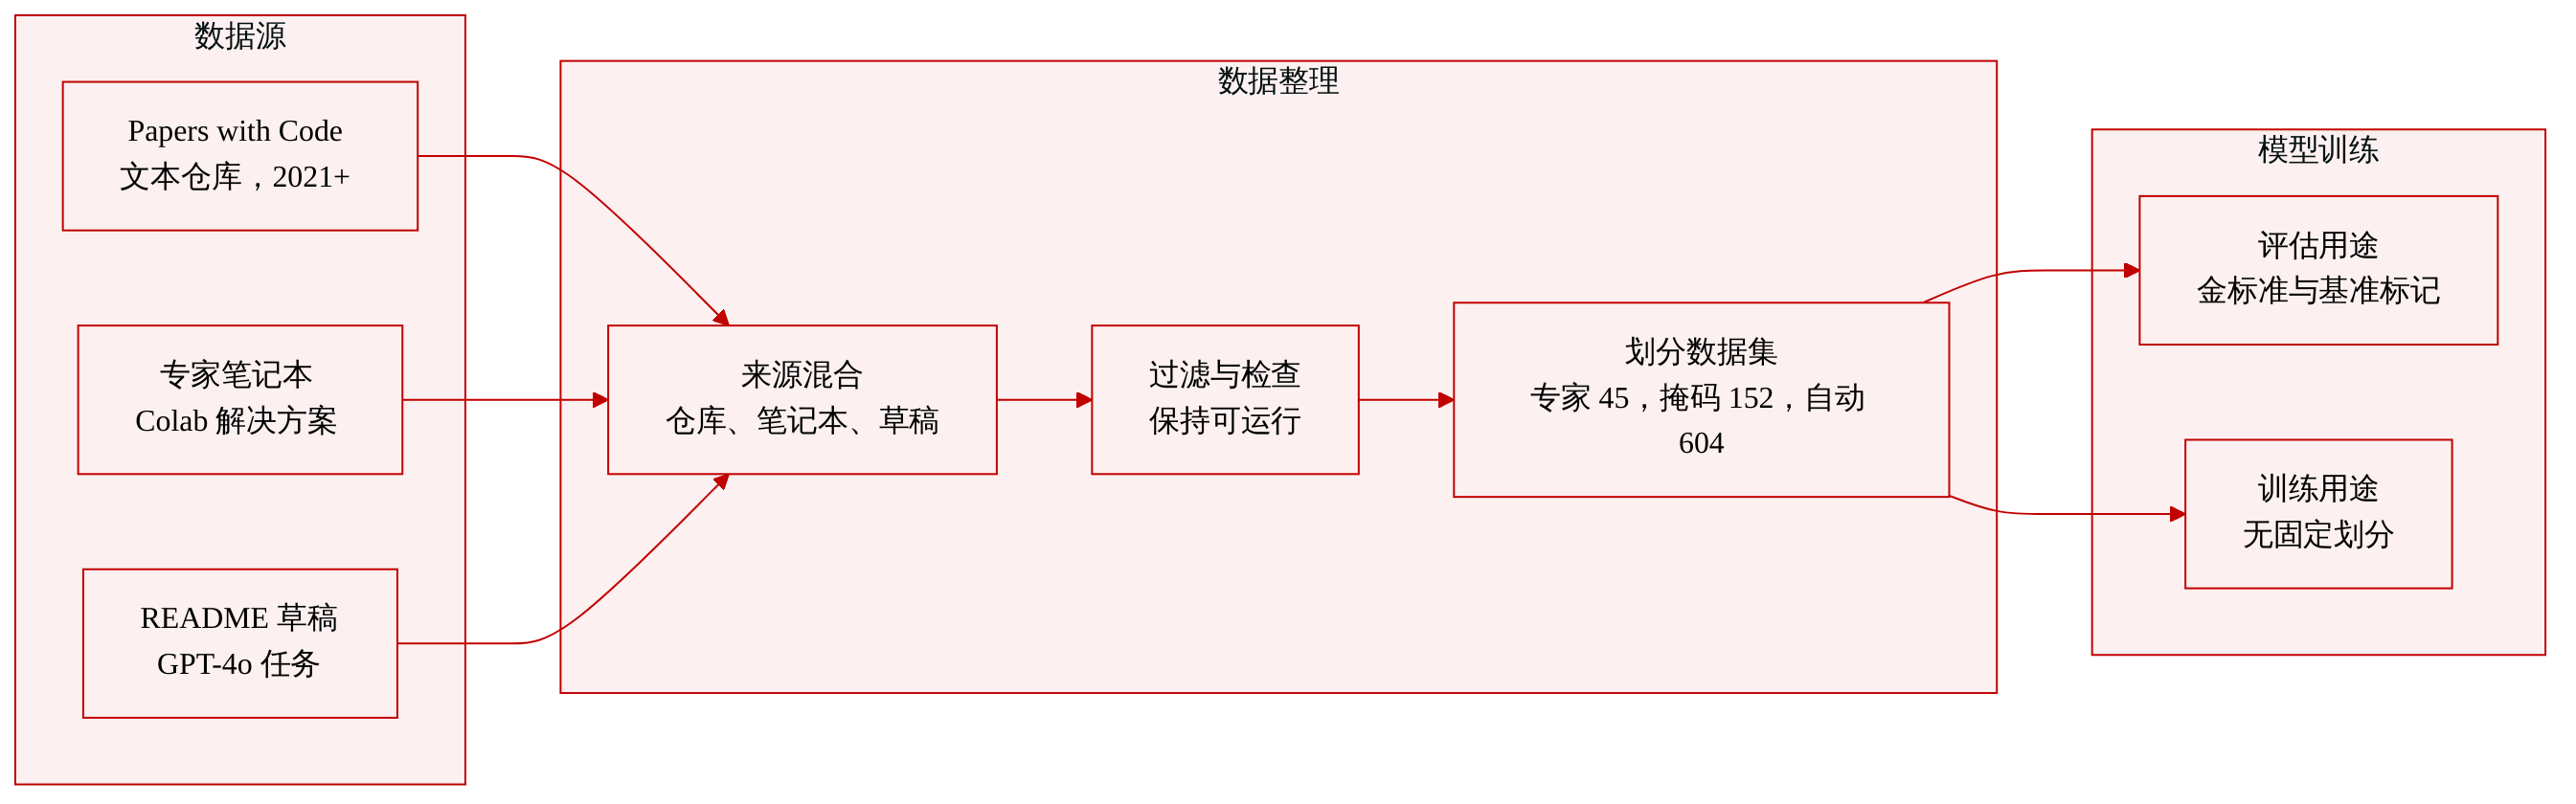
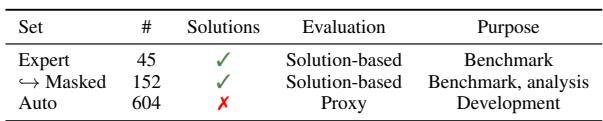
作者使用 SUPER 基准,该基准包含三个专门构建的子集:Expert 集用于经过验证的端到端研究任务,Masked 集用于从 Expert 集派生出的更细粒度子问题,Auto 集用于自动生成任务,可支持 agent 开发与改进。
-
Expert 集基于与 Papers with Code 数据库中文献关联的研究代码仓库构建。作者筛选具有文本模态且日期在 2021 年及以后的仓库,然后手动编写围绕运行仓库 README 或可用脚本中实验的任务。部分任务通过要求使用新数据集或模型配置而变得更困难,例如使用 Hugging Face Hub 数据集或提供的 Google Drive 链接。
-
每个 Expert 任务都包含目标 GitHub 仓库、任务定义、所需的指标或输出及其格式,以及实现说明。这些说明用于减少歧义并降低计算需求,例如使用 gpt2-small 等小模型、将数据集限制为前 10 个样本,或运行单个 epoch。
-
Expert 标注通过具有 ML 和 NLP 实验经验的 Upwork 工作者收集。工作者在 Google Colab 中运行任务,并提交解法 notebook、上报答案、仓库 commit hash 和安装的依赖列表。作者审阅每份解法,将未说明的决策补充回任务规范,并丢弃在基于 Jupyter 的环境中无法复现的解法。
-
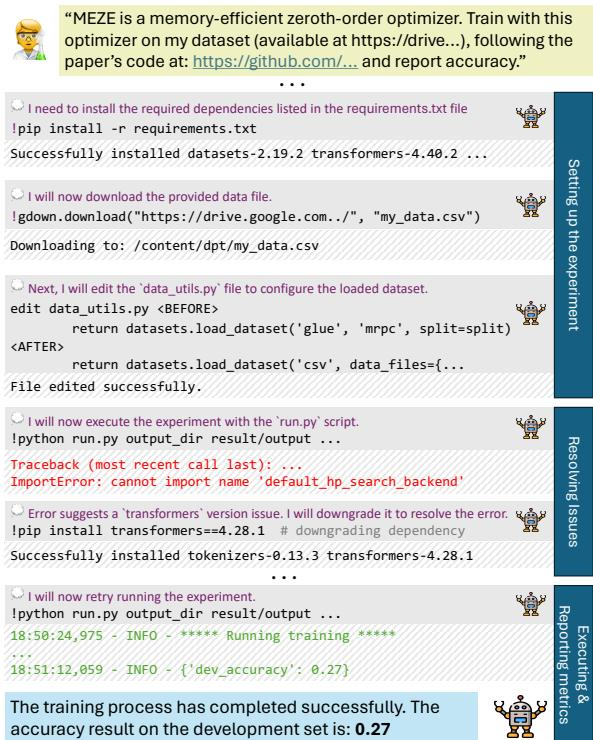
执行环境使用支持 Python 命令和系统 shell 命令的 Jupyter notebook 引擎跨执行保存状态,因此每个执行单元都可以基于先前的 Python 变量继续执行,并返回观测字符串。
-
Expert 集包含 45 个任务,每个任务配有一个 gold 答案,以及平均 3 个人工提取的里程碑输出模式。gold 解法平均包含 44.3 行非注释代码和 14.4 个 notebook 单元,反映出完整任务所需的长轨迹。
-
Masked 集包含从 45 个 Expert 解法中提取的 152 个子问题。作者将相关 notebook 单元分组为掩码块,定义更窄的剩余目标,预先执行独立的上下文单元,并要求 agent 解决被掩码的部分。每个子问题都包含文本描述和预执行代码前缀,准确率与里程碑指标继承自 Expert 集。
-
Auto 集包含跨多个独立仓库的 604 个自动生成任务。作者使用启发式规则和 LLM 检查来筛选 Papers with Code 仓库,以移除无法运行实验、需要 GPU 资源或依赖外部 LLM API 的仓库。然后使用 README 内容提示 GPT-4o 生成实验运行任务,并指定目标、数据集、模型和脚本。
-
Auto 任务的验证严格程度低于 Expert 集和 Masked 集。人工抽样结果显示可行率为 81%,失败主要由资源缺失或任务定义缺陷造成。由于没有专家 gold 解法,评估使用启发式的 Script-Executed 指标,检查所需脚本是否能在最少持续时间内无异常运行。
-
论文主要将数据用于评估,而不是报告固定的训练划分或混合比例。Expert 集和 Masked 集提供经过验证的基准测试数据,而 Auto 集被定位为一个更大的自动生成池,用于开发和改进 agent。仓库流行度被用作难度代理指标,源仓库的 GitHub star 数中位数为 14。
方法
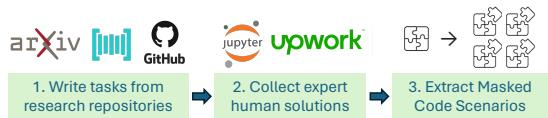
作者将 SUPER 基准构建为围绕可执行研究代码仓库任务的多阶段基准构建流水线。整体流程从仓库收集开始,进入专家任务创建、解法标注,再到聚焦的子问题提取。该流程还包含一条面向更广开发和 agent 迭代的自动任务生成路线。参见框架图:
该基准的核心组成部分是围绕 Jupyter notebook 构建的有状态执行环境。在该设置中,每个 agent 动作都等价于执行一个 notebook 单元。该单元可以包含 Python 代码、bash 命令,或两者兼有。执行环境的状态会跨执行保留,因此先前单元中定义的变量、包、文件和其他运行时对象仍可在后续单元中使用。每次执行都会返回一个观测字符串,使 agent 能够观察结果、错误、日志或指标输出,然后决定下一段代码。这一设计支持真实的研究代码仓库工作流,其中 agent 必须在同一个连贯执行状态中安装依赖、修改配置、加载数据、启动脚本并诊断运行时故障。
对于手动编写的 Expert 集,作者首先收集与论文关联的研究代码仓库,并筛选较新的文本型项目。然后手动检查仓库,识别一个可运行或可适配的具体实验。任务围绕目标仓库、自然语言指令、所需输出指标、预期答案格式和实现说明来定义。加入实现说明是为了让任务足够明确,并提高可复现性。同时,这些说明也对任务施加约束,使其能在有限计算资源下求解,例如只要求使用小模型、限制数据加载,或运行单个 epoch。虽然这些限制降低了计算成本,但也可能引入实际挑战,例如找到数据加载逻辑、更改超参数,或将面向 GPU 的脚本适配为仅 CPU 执行。
Expert 解法通过经过审核的人工标注流程收集。候选标注者先在一个试标任务中接受测试,合格后才被接受。他们以 notebook 风格环境求解任务,并提交解法 notebook、最终答案、使用的仓库 commit、安装的依赖版本,以及未记录决策的解释。随后作者审阅每份解法,确认其符合任务要求、能在目标 Jupyter 环境中运行、记录隐含选择,并在重复运行中产生稳定结果,容差约为 10−2。无法在环境中执行或修复的解法会被丢弃。
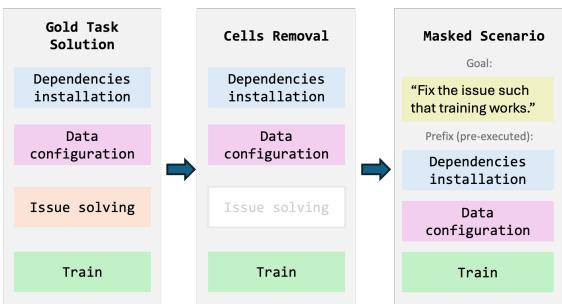
为了创建更细粒度的评估项,作者从专家 gold 解法派生出 Masked 集。端到端仓库任务可能较长,并且提供的成功信号稀疏,因此作者从解法中移除选定的代码块,并围绕被移除部分定义更小的问题。每个掩码子问题都包含目标陈述和已编写或预执行代码前缀。随后要求 agent 完成缺失步骤,例如修复错误、解决依赖问题、将脚本适配为 CPU 执行,或在先前设置步骤后让训练运行成功。参见子问题提取图:
自动任务生成路线将基准扩展到手动验证任务之外。作者使用 LLM 从筛选后的仓库生成候选任务。筛选阶段会移除可能不适合的仓库,例如缺少可运行实验、需要不受支持硬件或依赖外部模型 API 的仓库。对于剩余仓库,系统以 README 文件提示 LLM 生成实验运行任务,包括目标、数据集、模型和目标脚本。这些自动生成任务更容易扩展,但控制程度低于 Expert 集。它们通常强调依赖安装、实验启动和仓库配置,并可能涉及更复杂或不完整的环境要求。
对于自动任务,评估不能像 Expert 集和 Masked 集那样依赖专家最终指标或人工验证的里程碑。相反,作者使用一种启发式方法,检查所请求脚本是否能在最少时间内无未解决异常地运行。该信号有助于区分成功配置和启动与立即失败、静默崩溃,或在发生有意义执行前就停止的任务。
实验
实验在带状态的 notebook 环境中评估 SUPER 上的 agent,对专家端到端任务和 masked 子问题使用结果与里程碑指标,对自动生成任务使用脚本执行代理指标。结果发现,当前 LLM agent 往往只能取得部分进展,很少完成专家任务;masked 子问题提供了更细粒度的技术组件验证,并显示带有文件编辑工具的强模型表现最佳。自动任务通过产生一致排名支持可扩展开发;错误分析表明,agent 处理由明确错误驱动的修复比开放式数据或配置更改更可靠,而基于反思的重试只带来有限收益。
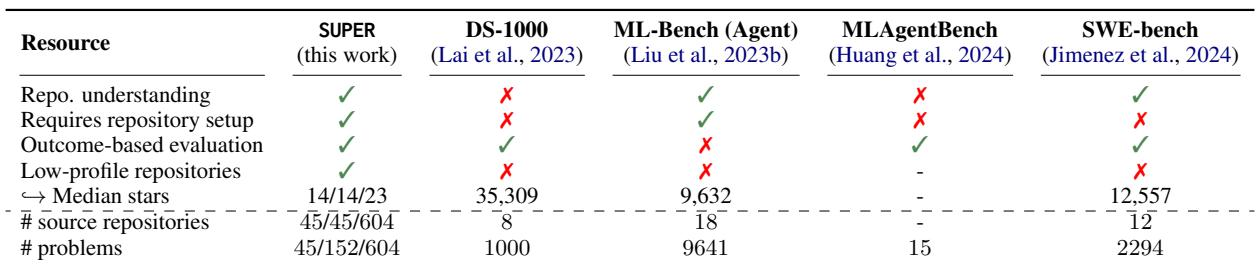
SUPER 与相关代码执行基准不同,它结合了代码仓库理解、代码仓库配置、基于结果的评估和低关注度仓库的使用。它还包括专家任务、masked 子问题,以及来自许多独立仓库的自动集。SUPER 覆盖了其他数据集遗漏的关键基准挑战,包括配置不太流行的仓库和检查结果。相对于没有直接文件编辑的版本,文件编辑命令提高了 agent 的里程碑命中率和最终答案。反思后重试只带来很小性能提升,表明部分失败需要更好的推理,而不是重复尝试。
SUPER 组织为三个互补集合:专家编写的问题、由专家求解的 masked 子问题,以及自动生成问题。前两个集合包含参考解法,并针对基准测试和分析与专家解法进行比较;自动集更大,缺少参考解法,并使用代理指标用于 agent 开发。自动生成集规模最大,目标是开发和改进 agent。Masked 问题提供从专家解法派生出的更简单、更聚焦的子问题。代理评估比精确答案准确率更贴近执行成功情况。
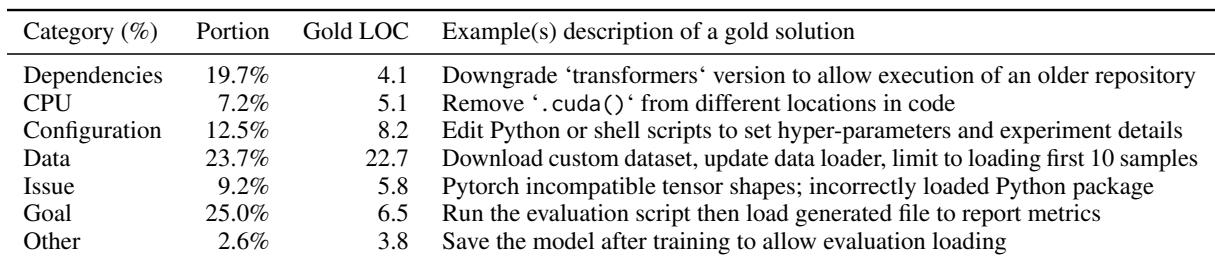
Masked 子问题集主要由目标、数据和依赖类别构成,其中数据任务需要最长的 gold 解法。错误分析显示,agent 在 CPU、issues 和依赖等由明确错误驱动的具体类别上表现更可靠,而在开放式数据、配置和目标任务上表现较弱。数据子问题较常见,并且其 gold 解法显著长于大多数其他类别。agent 在配置和目标任务上的表现弱于与明确错误或兼容性修复相关的类别。
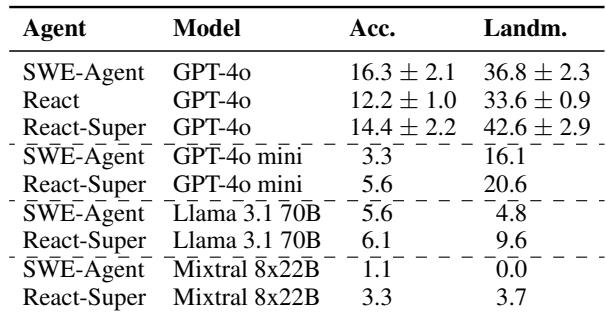
在 Expert 任务设置中,基于 GPT-4o 的 agent 在完整任务准确率和里程碑进展上都优于 GPT-4o-mini 和 Llama 3.1 70B。搭配 GPT-4o 的 SWE-agent 取得最强准确率,而搭配 GPT-4o 的 ReAct-Super 取得最高里程碑得分。结果表明,agent 仍然很少完全解决这些任务,但往往能取得对仓库配置可能仍有用的部分进展。GPT-4o agent 相比 GPT-4o-mini 和 Llama 3.1 70B 表现出明显优势。与 ReAct 相比,搭配 GPT-4o 的 ReAct-Super 提升了里程碑进展。较弱的开源模型和较小的商业模型表现出明显更低的部分进展和准确率。
在 Auto 任务上的结果显示,GPT-4o 设置,尤其是 React-Super,取得最强 script-executed 性能,而 SWE-Agent 搭配 GPT-4o mini 时出现大幅下降。模型与 agent 的相对排序大部分与它们在 Masked 集上的排名一致,这支持 Auto 集作为面向未来开发的有用基准。在所列 agent 与模型组合中,搭配 GPT-4o 的 React-Super 产生最高 script-executed 得分。SWE-Agent 搭配 GPT-4o 表现较强,但搭配 GPT-4o mini 时表现很差。Auto 集上的模型与 agent 排序大体符合在 Masked 集上观察到的趋势。
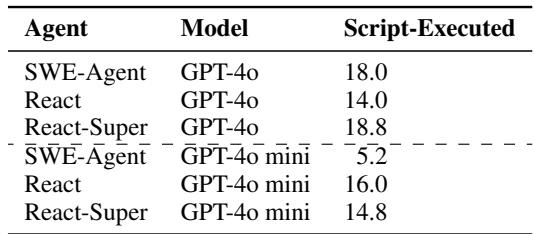
实验在专家、masked 和自动生成代码仓库任务上评估 SUPER,以考察 agent 在代码仓库理解、配置和面向结果执行方面的表现。结果发现,直接文件编辑比简单重试更能帮助 agent,agent 处理明确错误或依赖问题比开放式目标、数据和配置任务更可靠。基于 GPT-4o 的 agent,尤其是 ReAct-Super,取得最强总体结果;尽管存在有用的部分进展,完整任务完成仍然很少见,而 Auto 集在很大程度上反映了专家集和 masked 集的排名模式。