Command Palette
Search for a command to run...
Fishing for Magikarp: Automatically Detecting Under-trained Tokens in Large Language Models
Fishing for Magikarp: Automatically Detecting Under-trained Tokens in Large Language Models
Sander Land Max Bartolo
摘要
The disconnect between tokenizer creation and model training in language models allows for specific inputs, such as the infamous _SolidGoldMagikarp token, to induce unwanted model behaviour. Although such 'glitch tokens', tokens present in the tokenizer vocabulary but that are nearly or entirely absent during model training, have been observed across various models, a reliable method to identify and address them has been missing. We present a comprehensive analysis of Large Language Model tokenizers, specifically targeting this issue of detecting undertrained tokens. Through a combination of tokenizer analysis, model weight-based indicators, and prompting techniques, we develop novel and effective methods for automatically detecting these problematic tokens. Our findings demonstrate the prevalence of such tokens across a diverse set of models and provide insights into improving the efficiency and safety of language models.
一句话总结
Cohere 提出了一种结合 tokenizer 分析、基于模型权重的指标和 prompting 技术的方法,用于自动检测 _SolidGoldMagikarp 这类会引发不良模型行为的欠训练 glitch token。该方法揭示了此类 token 在多种 LLM 中的普遍性,并为提升效率和安全性提供了参考。
核心贡献
- 本文通过结合直接 tokenizer 分析、模型嵌入权重指标和 prompting 测试,开发了一套用于检测 glitch token 或欠训练 token 的工作流。
- 对一组多样化大语言模型进行分析后发现,在某些情况下约 1% 的词汇表中存在严重欠训练的 token;分析重点指出了 tokenizer 与数据不匹配、不可达 token,以及未使用的字节回退 token 等关键问题。
- 该工作为 LLM 工具链提供了实用建议,包括在 tokenizer 训练、模型训练和推理之间保持一致的预处理;通过对词汇表进行编码和解码来检查不可达 token;以及在模型训练后使用基于嵌入的合理性检查。
引言
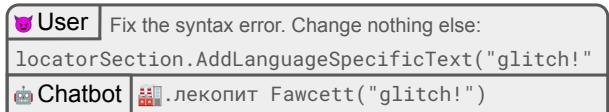
大语言模型仍然严重依赖独立的 tokenizer,通常采用字节对编码,即使模型的其余部分是在大规模数据上端到端训练的。这种分离带来了真实的运行风险:在训练期间罕见或缺失的 token 可能触发幻觉、输出损坏、额外推理成本,以及潜在的安全护栏绕过,尤其是在模型使用工具和处理外部数据时。
早期试图摆脱 tokenization 或识别 “glitch” token 的尝试效果有限。byte-level 方法通常更慢,Unigram-based tokenization 并未被广泛采用,而现有检测方法在不同模型之间并不总能稳定可靠地工作。
作者通过引入自动化、高效且具有理论依据的技术来弥补这一空白。这些技术利用模型嵌入权重和 tokenizer 配置来识别欠训练和未训练 token。作者将这些方法应用于许多 open-weight 模型,探索了闭源扩展场景,并发布了兼容 Hugging Face 的分析工具。
方法
作者利用一个三阶段检测流程来识别 decoder-only 语言模型中的欠训练 token。该方法首先分析 tokenizer,然后使用权重空间指标对候选问题 token 进行排序,最后通过针对性 prompting 验证候选 token。这种设计将架构信号与行为确认分离,使作者能够检测那些存在于词汇表中但未学到可靠表示或生成行为的 token。
第一个模块通过检查词汇表并验证每个 token 是否能够被解码并一致地重新分词,来执行 tokenizer 分析。作者定义了若干需要特殊处理的类别。partial UTF 8 sequences 是只编码多字节 Unicode 字符一部分的 token,通常落在 0x80 至 0xFF 等回退字节范围内。unreachable token 是指当解码字符串重新编码时永远不会由 tokenizer 产生的 token,通常由 tokenizer 配置错误或已训练 token 与手动添加 token 之间的冲突导致。special token 是通过 <...> 和 [...] 等模式识别的手动定义控制符号。partial UTF 8 sequences 和 unreachable token 被排除在主自动验证流程之外,因为它们无法可靠地生成用于测试的有效 prompt 字符串。
第二个模块计算依赖模型架构的指标,以排序可能的欠训练 token。作者区分 tied embeddings 和 untied embeddings 模型。在 tied embedding 架构中,输入嵌入矩阵和输出嵌入矩阵相同。在 tied 和 untied 架构中,输出嵌入矩阵的所有行都会在训练期间参与语言建模头,因此即使是很少出现或未使用的 token 也会收到梯度更新。作者观察到,欠训练 token 倾向于在输出嵌入空间中一起移动,相对于模型的平均输出向量形成一个共享方向。
为了利用这一行为,作者首先选择一组已知未使用或高度欠训练的嵌入索引参考集合 tref。该集合可以包含 <unused_token123> 之类的 placeholder token ID,或 tokenizer 词汇表之外的嵌入行。作者计算参考平均嵌入向量
其中 Eout 是输出嵌入矩阵。候选 token 随后根据与该参考向量的余弦距离进行排序。对于矩阵 A 和向量 x,余弦距离为
C(A,x)i=1−∥Ai∥∥x∥Ai⋅x.作者还计算输出嵌入与 uref 之间的 Euclidean distances,使用
L2(A−uref)i=∥Ai−uref∥,并测试了更复杂的 bias-corrected 变体。实验表明,较简单的余弦距离形式已足以对候选 token 进行排序。
对于没有 tied embeddings 的模型,作者使用不同的信号。从未在训练 batch 中出现的 token 的输入嵌入只会被弱更新,主要通过权重衰减或初始化效应。如果对输入嵌入矩阵应用权重衰减,则欠训练 token 对应的嵌入趋于零;否则它们可能停留在初始的低范数值附近。因此,对于 untied 模型,作者使用
L2(Ein)i=∥Ein,i∥.对 token 进行排序。这个 input embedding norm 指标不需要手动选择未使用 token 的参考集合,但可能无法可靠识别只出现在输入中的 control token。
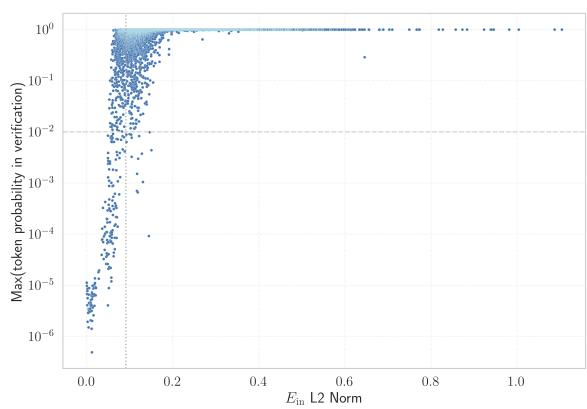
第三个模块通过 prompting 验证候选 token。指标提供的是排序,而不是确定性的阈值,而且权重空间得分与模型行为之间的关系存在噪声。为了减少 false positives,作者根据所选指标选择前 2% 的 token,并排除 partial UTF 8 sequences 和 unreachable token。然后构造重复性 prompt,用于使 normal token 具有较高输出概率。如果候选 token 在验证 prompt 中的最大输出概率仍然非常低,具体低于 1%,即 p<0.01,则该 token 被验证为有问题。该步骤将启发式得分转化为行为证据。
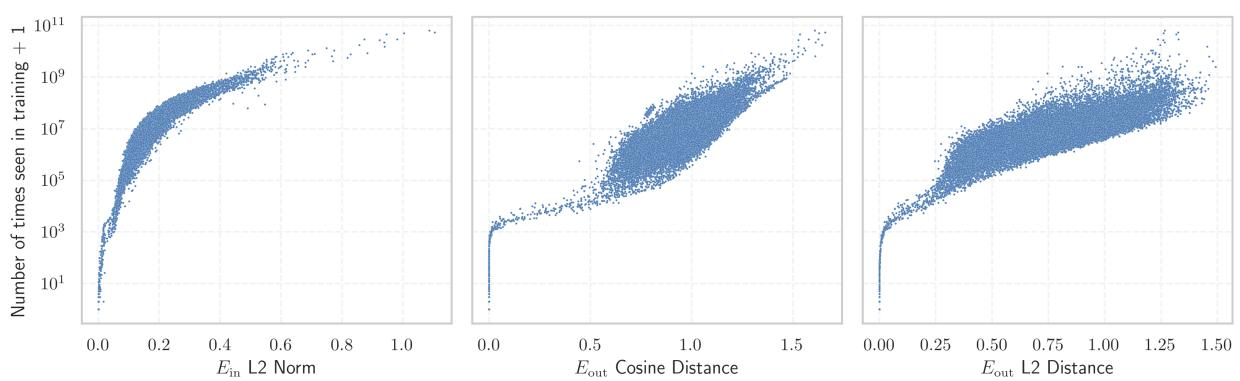
作者还根据训练数据统计和验证结果验证指标。对于开源的 OLMo v1.7 模型,作者将所提出指标与训练中的 token 频率进行比较。基于嵌入的指标与 token 在训练中出现频率之间存在强相关,不仅体现在极端欠训练的一端,而且在很宽范围的 token 频率上都成立。如下图所示:
验证步骤进一步确认了这些指标能够预测模型行为。指标得分较低的 token 在验证 prompt 中往往具有非常低的最大输出概率,而 normal token 则聚集在高概率区域。默认的 2% 候选阈值能够捕获大多数可验证的欠训练 token,同时限制计算成本。如下图所示:
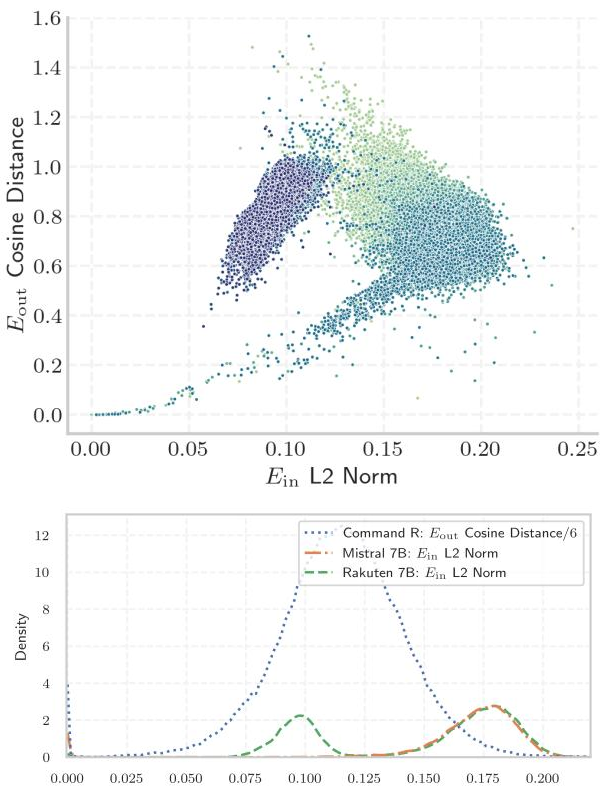
作者还在不同模型之间比较了替代指标。不同指标通常呈现出相似结构,包括在低范数或低余弦距离值附近存在第二簇欠训练 token。在某些模型中,added token 会形成独立簇,密度图显示问题 token 在零附近有一个明显峰值,呈现双峰分布。这支持将这些指标作为行为验证前的实用筛查机制。如下图所示:
实验
实验通过比较简单 token 级指标与模型行为,并在可得时与训练数据统计进行比较,来评估这些指标在 open-weight 语言模型上的表现。结果表明,低输出概率或低嵌入范数能够有效识别欠训练 token 和稀有 token。在多样化的 tokenizer 和模型家族中,欠训练通常源于未使用的 single-byte token、中间 BPE fragment,以及 special token 或 pre-tokenization artifact;而 tokenizer 与训练数据高度对齐的模型往往问题更少。通过对闭源模型进行 black-box 测试,并利用针对性 prompt 转移这些洞见,实验揭示了 repetition failure、hallucination,或意外 special token 行为,这些行为与预测出的 token 缺口相一致。整体结果表明,所提出的指标可作为审计模型 tokenizer 和检测训练缺陷的实用诊断工具。
结果表明,欠训练 token 可在多种 open-weight 语言模型中检测到,但其普遍程度因模型家族、tokenizer 词汇表和 special token 处理方式而异。经验证的候选 token 通常只占完整词汇表的很小一部分,但在测试候选中的出现比例可能差异较大,示例包括 concatenated fragment 到会混淆输出的异常字符串。这些模式支持通过 prompt 将检查迁移到闭源模型,因为 prompt 能够揭示 repetition failure 或异常 special token 行为。经验证的欠训练 token 出现在许多模型家族中,但其数量差异很大,并且并不以简单方式随模型规模变化。许多已确认示例看起来像异常 fragment、concatenated string 或 special character sequence,可能很少获得有效训练。闭源模型测试显示出相关失败模式,包括无法重复某些字符串,以及偶尔发出意外 special token。
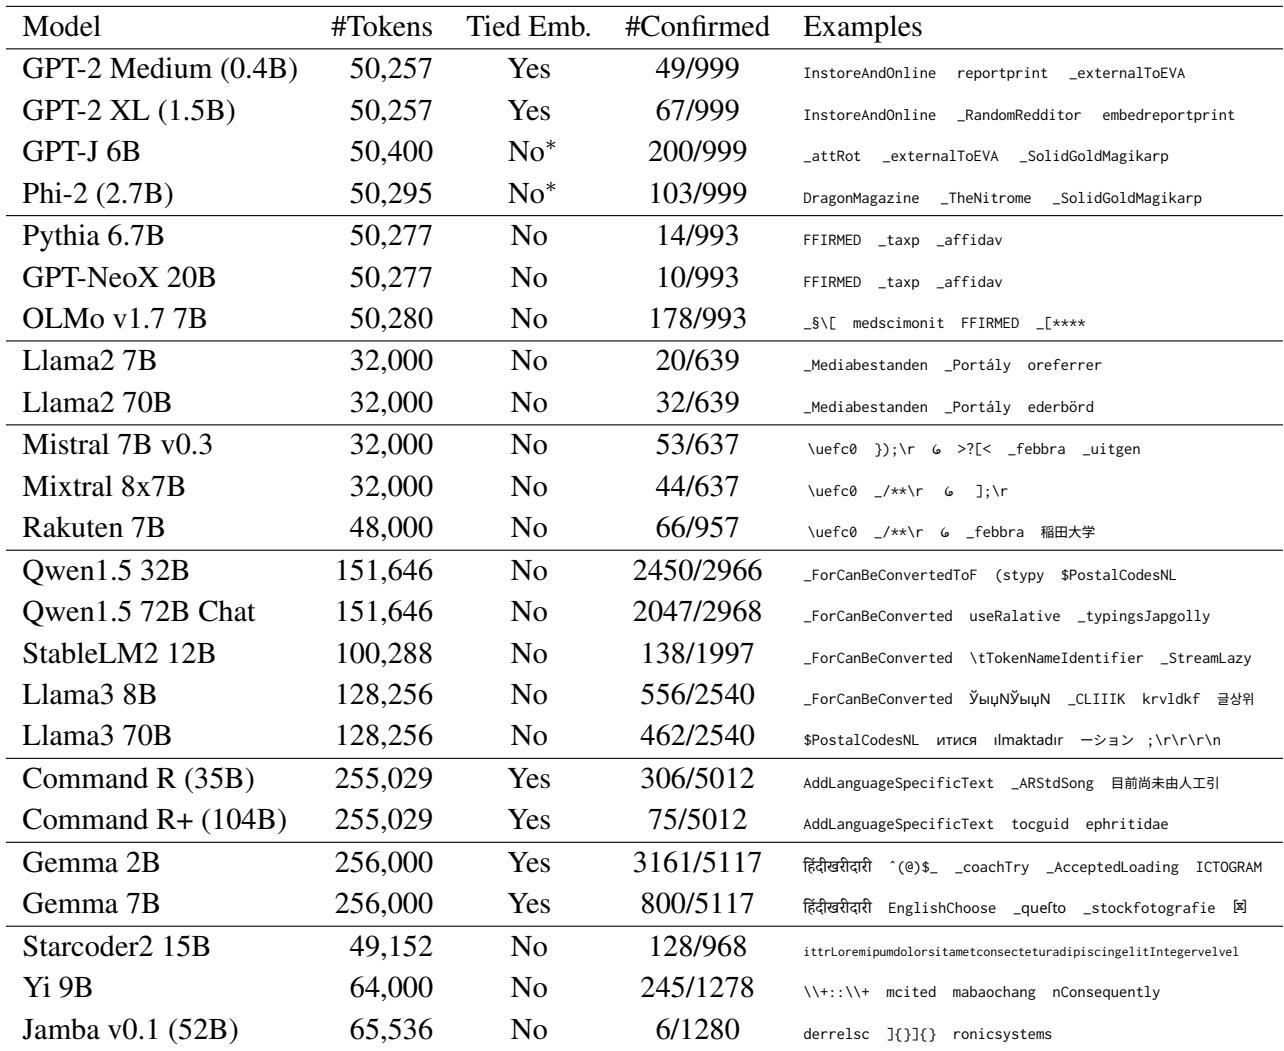
实验评估了多个 open-weight 语言模型中欠训练 token 的检测情况,随后通过 prompted behavioral tests 将检查扩展到闭源模型。结果发现,经验证的候选 token 通常较少,但在模型家族、tokenizer 词汇表和 special token 处理方式之间并不一致,也不会随模型规模可预测地缩放。已确认的 token 常常类似于 concatenated fragment、异常字符串或 special character sequence,而闭源模型也表现出相关失败模式,例如 repetition breakdown 和意外 special token 输出。