Command Palette
Search for a command to run...
一图胜千言,但人人都能听懂吗?——论面向文化相关性的图像创译
一图胜千言,但人人都能听懂吗?——论面向文化相关性的图像创译
Simran Khanuja Sathyanarayanan Ramamoorthy Yueqi Song Graham Neubig
摘要
随着多媒体内容的兴起,人类译者 increasingly 将跨文化适应的重心从文字扩展到图像等其他模态,以传达相同的含义。尽管多种应用场景可从中受益,现有机器翻译系统仍局限于处理口语和文本中的语言。本文提出了一项新任务——对图像进行翻译以使其具有文化相关性。首先,我们构建了三条流程,结合最先进的生成模型来完成该任务。其次,我们构建了一个两部分评估数据集——(i)概念集:包含 600 张跨文化连贯的图像,每张聚焦单一概念;(ii)应用集:包含从真实应用场景中精心挑选的 100 张图像。我们开展多维度的人工评估,从文化相关性和语义保留两方面对翻译后的图像进行评判。研究发现,截至目前,图像编辑模型在该任务上表现不佳,但通过引入 LLM 和检索器协同工作可有所改善。即便最优流程,在较易的概念集上对某些国家的图像翻译成功率也仅为 5%,而在应用集上对某些国家甚至无一成功,凸显了该任务的挑战性。项目主页见此处,代码、数据及模型输出见此处。
一句话总结
卡内基梅隆大学提出图像创译(image transcreation),这是一种跨语言对图像进行文化适应的新任务,提出三种由 LLM 和检索器增强的生成式流水线,并建立一个包含 600 张概念图像和 100 张应用图像的两部分评估数据集;研究发现,即使最好的方法在某些国家也仅在 5% 的图像上成功,凸显了该任务的难度。
核心贡献
-
论文提出图像创译,这是一种新的机器学习任务,用于为目标受众对视觉内容进行文化适应,同时保留原始含义,从而将翻译从语音和文本扩展到视觉内容。
-
三种基线流水线将最先进的生成式图像编辑模型与大语言模型和检索器组合在回路中,表明显式语言理解和检索相较直接端到端图像编辑有所改进。
-
发布一个两部分评估数据集,包括 600 张图像的概念集和 100 张图像的应用集,内容取自教育学习单和儿童文学。跨七个国家的人类评估显示,当前图像编辑模型大多失败;最好的流水线在概念集中某些国家仅能成功创译 5% 的图像,在某些国家的应用集中则没有任何图像成功。
引言
翻译已从词语扩展到多模态意义,因为视觉、音乐和语境都会影响受众反应。这在电影、教育和广告等领域尤为重要,因为这些领域的本地物品、货币、食物和庆祝活动等文化元素有助于保留预期效果。现有工作大多研究文本翻译或图像生成中的文化偏见,而当前图像编辑模型通常只处理表面风格变化,而不是深层文化含义。作者提出图像创译作为新的 ML 任务,构建三种流水线,分别使用直接编辑、基于 LLM 的标题改写或检索,并创建覆盖概念和真实应用的跨国数据集;通过人类评估表明,当前模型仍表现不佳,而 LLM 和检索器回路可以改善结果。
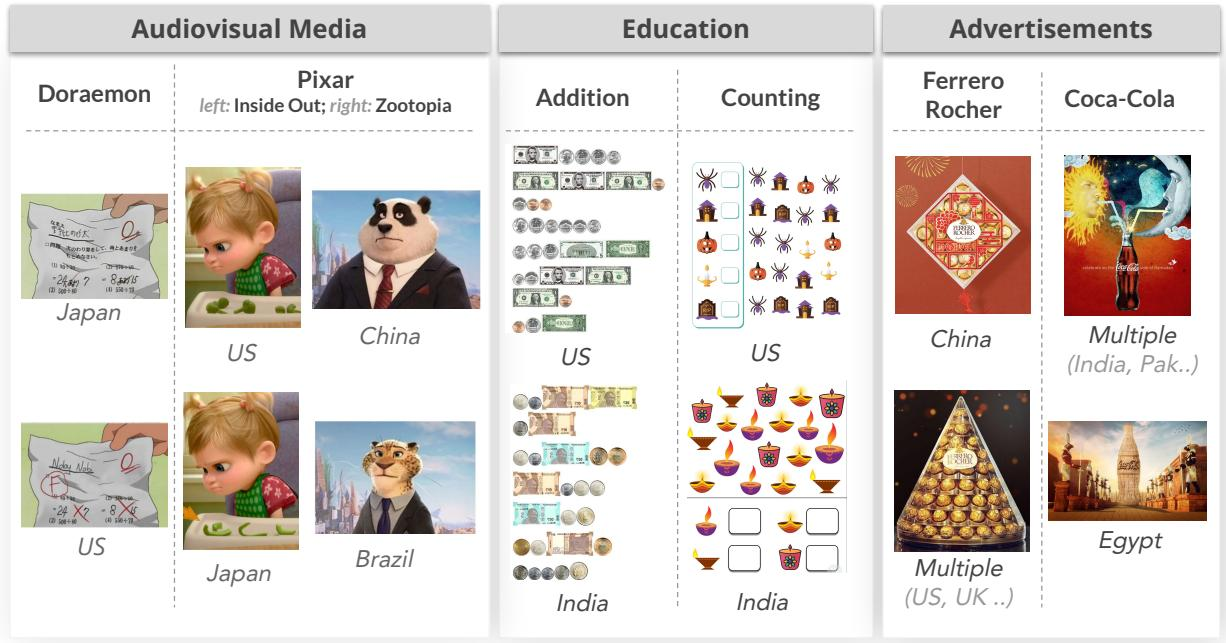
数据集
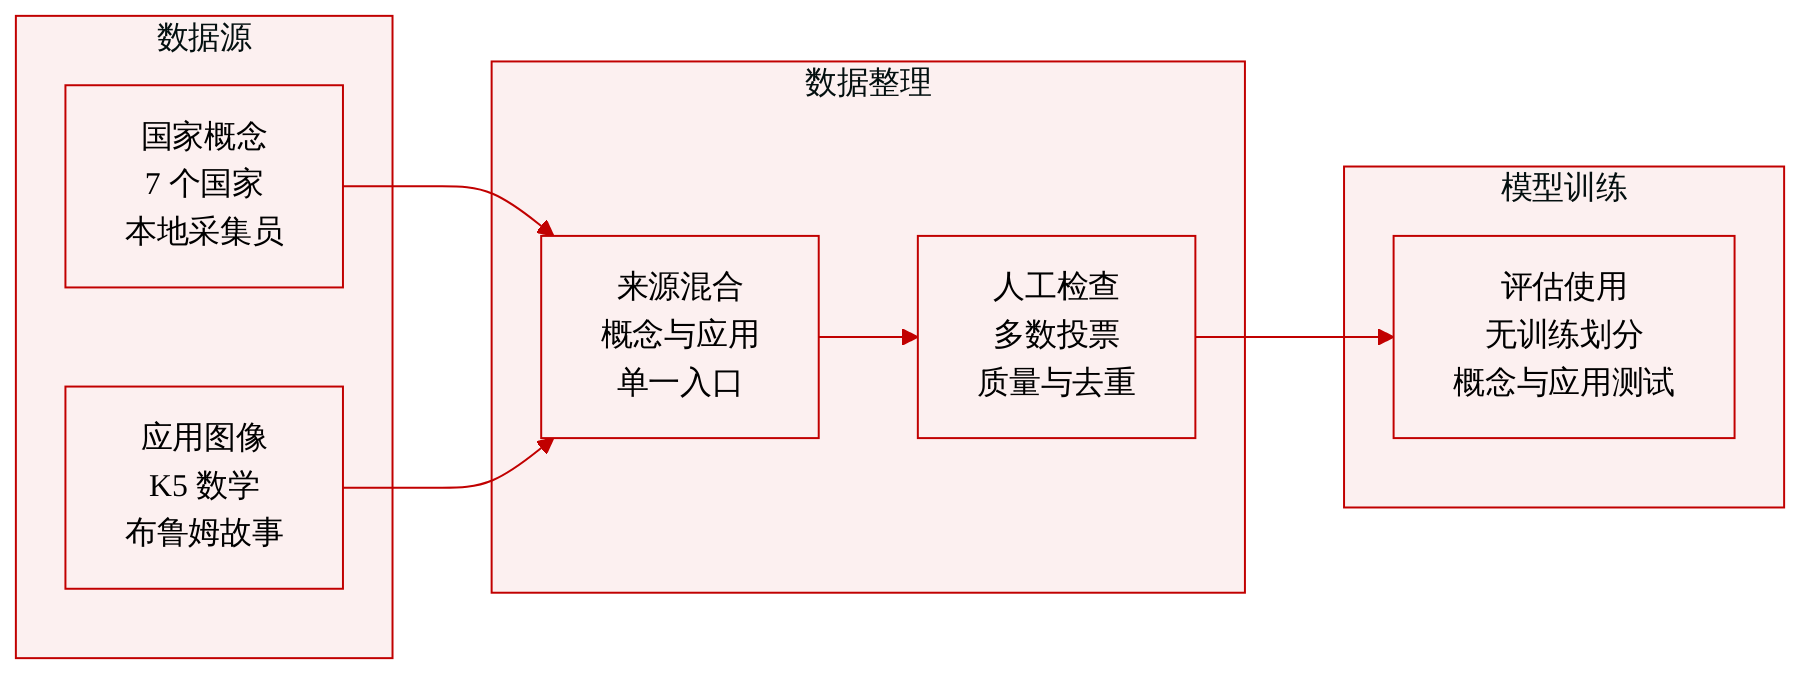
-
作者构建了一个两部分评估数据集:一个概念原型子集,以及一个基于教育和文学的应用子集。
-
概念子集:
- 来源与组成:在七个国家收集的通用概念图像:巴西、印度、日本、尼日利亚、葡萄牙、土耳其和美国。
- 标注来源:各国的本地标注者在 MaRVL 协议指导下开展采集,有助于捕捉真实生活文化语境。
- 概念选择:每个国家由五名熟悉当地文化的标注者列出五个显著、常见且具体的概念。每个国家保留出现频率最高的五个概念。
- 过滤:三名母语者验证选定的概念和图像,未获得至少两票的条目会被移除。
- 规模:每个国家约 85 张图像,过滤后总共约 580 张图像。
- 模式与元数据:图像与国家和通用概念类别绑定,每张图像旨在单独呈现一个概念或对象。
-
应用子集:
- 来源:来自 K5 Learning 一至三年级数学学习单和 Bloom Library 儿童故事的真实世界应用数据。
- 教育数据:源自 K5 Learning,一个美国学习平台。学习单图像包含任务特定约束,例如保留对象数量,或使用可支持测量的对象。
- 文学数据:源自 Bloom Library。作者使用每则选定故事的第一个图像及其文本,以指导创译。
- 选择:从 400 个英文版 Bloom Library 故事中,手工选择约 60 张高质量且去重的图像。
-
在论文中的用途:
- 数据被描述为评估数据集,而非训练集。未报告训练划分、混合比例或模型训练数据使用。
- 概念子集用作受控研究原型,具有多样的国家、每图一个对象和宽松的输出约束,以支持误差分析。
- 应用子集评估更困难的真实世界设置,其中包含复杂场景、文本指导和应用特定约束。
-
额外处理说明:
- 处理过程主要依赖标注者驱动的过滤和人工整理。
- 主要过滤规则包括对概念图像采用多数投票,以及对应用图像进行人工质量和去重检查。
- 未描述裁剪策略。元数据和组织方式按国家、概念类别、来源应用以及适用情况下的关联故事文本来定义。
方法
作者利用三种生成式流水线进行图像创译,每种流水线从源图像和目标国家指定出发,目标是生成在视觉内容、文化线索和所呈现概念上与该国家更加自然匹配的输出。三种设计的概览在框架图中展示。
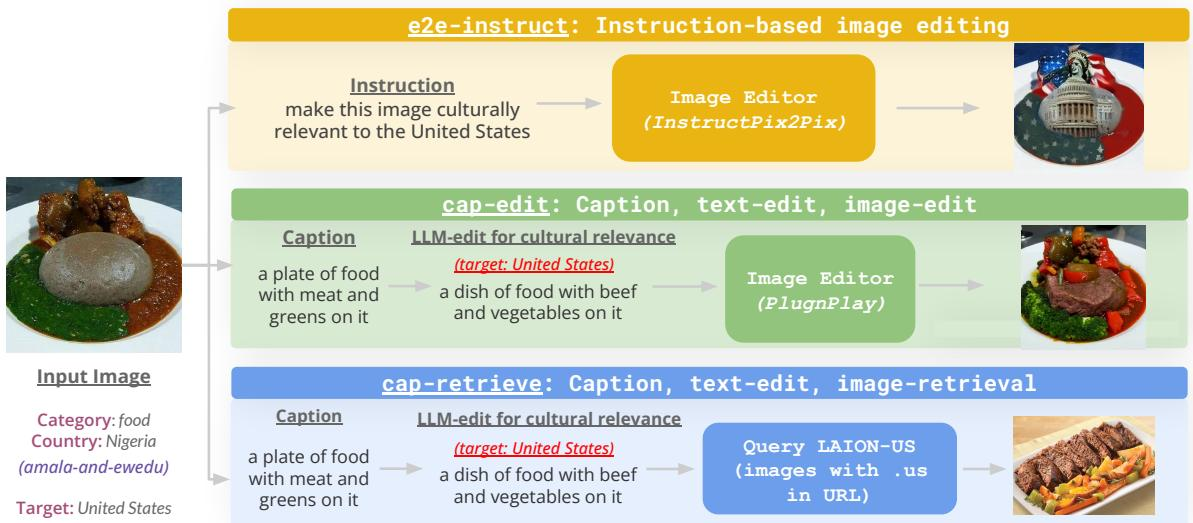
第一种流水线是一种直接基于指令的编辑设计,称为 e2e-instruct。它将原始图像和一条自然语言指令输入基于指令的图像编辑模型,要求模型使图像与目标国家具有文化相关性。这种单遍方法简单且灵活,因为它不需要分割掩码、示例输出图像或其他辅助标注。然而,它严重依赖图像编辑模型推断文化上恰当变化的能力;当模型未被明确训练用于此类转换时,这是重大局限。
第二种流水线是模块化的标题、文本编辑、图像编辑设计。它将一部分文化推理负担从图像编辑模型转移到大语言模型。流程从图像描述模型开始,将输入图像转换为文本描述。随后,语言模型编辑该标题,使其中描述的对象、食物、人物、场景或视觉细节与目标国家在文化上相关。修改后的标题作为图像编辑模型的编辑指令,图像编辑模型在保留整体结构的同时修改原始图像。在所描述的实现中,图像描述模型生成初始描述,语言模型执行面向文化相关性的标题转换,基于指令的图像编辑器合成经过本地化的图像。
第三种流水线是基于检索的替代方案,称为 cap-retrieve。它与标题、文本编辑、图像编辑流水线采用相同的初始路径:首先对图像生成标题,然后使用语言模型改写标题,使其具有文化相关性。它不通过直接编辑生成新图像,而是将编辑后的标题作为检索查询,在按国家划分的网络级图像集合子集中检索。这些子集通过解析图像 URL 并根据国家代码顶级域名将图像分配到对应国家来构建,例如将包含日本域名后缀的 URL 归入日本子集。该设计针对直接编辑的一个局限:图像编辑模型可能过于僵硬地保留空间布局,因而无法以在目标国家看来自然的方式呈现概念。
实验
研究在一个两部分数据集上评估图像创译,该数据集包括来自七个国家的文化标注通用概念图像,以及来自教育和文学的真实世界应用图像。人类实验评估生成编辑是否有意义、是否保留原始类别、是否提升文化相关性,以及是否满足应用特定约束,结果显示流水线即便在孤立概念上也表现困难,在更复杂的真实世界任务上表现更差。定量分析显示,基于标准嵌入的指标只与人类判断部分一致,说明该任务需要更强的评估方法。
评估比较三种图像创译流水线在多项人类评分属性上的表现,包括视觉变化、语义等价、空间布局、文化相关性、自然度和冒犯性。cap-edit 倾向于进行适度且更有意义的编辑,更好地保留原始语义类别;e2e-instruct 通常变化很小或只是表面编辑;cap-retrieve 进行更显著的改动,但质量波动更大。成功的创译仍然困难,在不同国家之间表现不均,标准定量指标无法完全捕捉整体编辑质量。cap-edit 通常与有意义的编辑相关,这些编辑能更好地保留原始图像的通用类别。e2e-instruct 在视觉变化上常常得分较低,并且可能产生无法可靠传达文化相关性的表面编辑。cap-retrieve 通常比其他流水线更强烈地编辑图像,但其结果因目标国家和任务不同而差异很大。不同应用施加不同约束,因此成功需要在编辑量、布局保持、文化相关性和自然度之间取得平衡。总体创译成功率很低,并且高度依赖国家,这表明任务远未被解决。
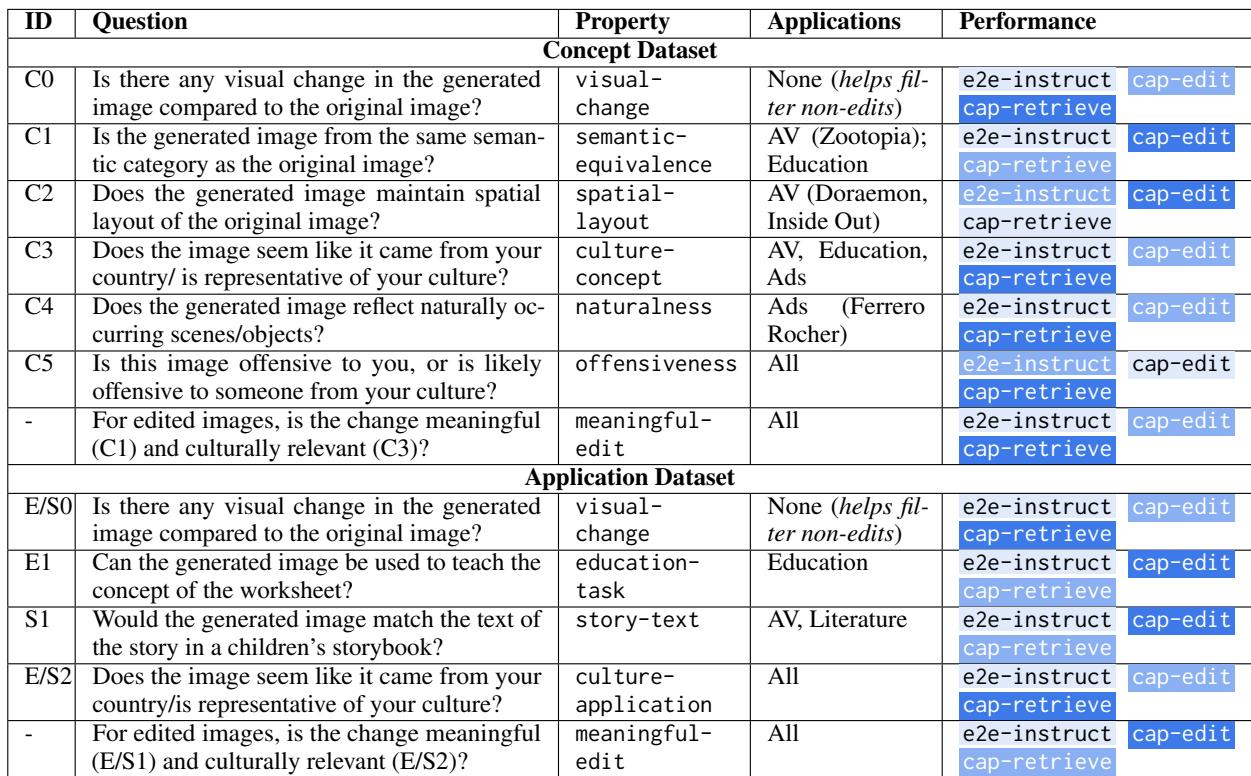
实验使用人类对视觉变化、语义等价、布局、文化相关性、自然度和冒犯性的判断,比较 cap-edit、e2e-instruct 和 cap-retrieve 的图像创译表现。cap-edit 通常进行适度且有意义的编辑,保留原始语义类别;e2e-instruct 常常变化很小或流于表面;cap-retrieve 会进行更大但一致性更低的编辑。总体结果表明,创译成功率低、国家之间不均,且未被标准指标充分捕捉;因此,实用成功需要平衡编辑量、布局、文化相关性和自然度。