Command Palette
Search for a command to run...
面向数千种语言的鲁棒语音表示学习
面向数千种语言的鲁棒语音表示学习
William Chen Wangyou Zhang Yifan Peng Xinjian Li Jinchuan Tian Jiatong Shi Xuankai Chang Soumi Maiti Karen Livescu Shinji Watanabe
摘要
自监督学习(SSL)通过减少对标注数据的需求,帮助将语音技术扩展到更多语言。然而,现有模型距离支持全球 7000+ 种语言仍相去甚远。我们提出了 XEUS(Cross-lingual Encoder for Universal Speech),一个面向通用语音的跨语言编码器,在涵盖 4057 种语言的超过 100 万小时数据上训练,将 SSL 模型的语言覆盖范围扩展了 4 倍。我们将现有公开语料库中的 100 万小时语音与新构建的包含 4057 种语言、7400+ 小时的新语料库相结合,该语料库将公开发布。为应对多语言语音数据的多样化条件,我们在典型的 SSL 掩码预测方法基础上引入了一种新颖的去混响目标,从而提升了鲁棒性。我们在多个基准上对 XEUS 进行了评估,结果表明它在多种任务上一致地优于或达到与最先进(SOTA)SSL 模型相当的性能。XEUS 在 ML-SUPERB 基准上创造了新的 SOTA 纪录:尽管参数量或预训练数据更少,它仍分别超越 MMS 1B 和 w2v-BERT 2.0 v2 0.8% 和 4.4%。模型检查点、代码和数据可在 https://www.wa vlab.org/activities/2024/xeus/ 获取。
一句话总结
来自卡内基梅隆大学、上海交通大学和丰田芝加哥技术研究院的研究人员提出 XEUS,这是一个在超过 100 万小时、覆盖 4,057 种语言的语音上训练的跨语言语音编码器,它在 SSL 掩码预测基础上增加了一种新的去混响目标,以提升鲁棒性,并在 ML-SUPERB 基准上取得了最新前沿结果。
核心贡献
- 本文介绍 XEUS,一个在超过 100 万小时、覆盖 4,057 种语言的跨语言语音自监督编码器,并发布一个新的 7413 小时无标注语料库,将模型语言覆盖扩大约四倍。
- 该工作在标准自监督掩码预测上增加一种新的联合去混响目标,使编码器对混响和有噪多语言语音条件具有更强鲁棒性。
- 实验表明,XEUS 在多种语音任务上与强自监督基线相当或超越它们,并在 ML-SUPERB 上取得新成绩,分别超过 MMS 1B 和 w2v-BERT 2.0 v2 0.8% 和 4.4%,同时发布代码、数据、检查点、日志和中间检查点。
引言
由于转录语音稀缺,且许多低资源录音存在噪声或声学多样性,语音处理模型仍只覆盖世界上很小一部分语言。自监督学习可以减少对标注的依赖,但现有多语言模型通常仅覆盖 50 到 150 种语言,依赖封闭爬取数据,即使模拟噪声,仍然容易受到混响和说话风格变化的影响。作者利用这些空白提出 XEUS,一个在超过 100 万小时公开音频以及包含 4,057 种语言、7,413 小时的新公开语料库上预训练的跨语言语音编码器。作者还在掩码预测和去噪旁边增加声学去混响目标,从而得到更鲁棒的通用编码器,并发布代码、检查点和训练日志,以支持可复现的大规模多语言语音研究。
数据集
-
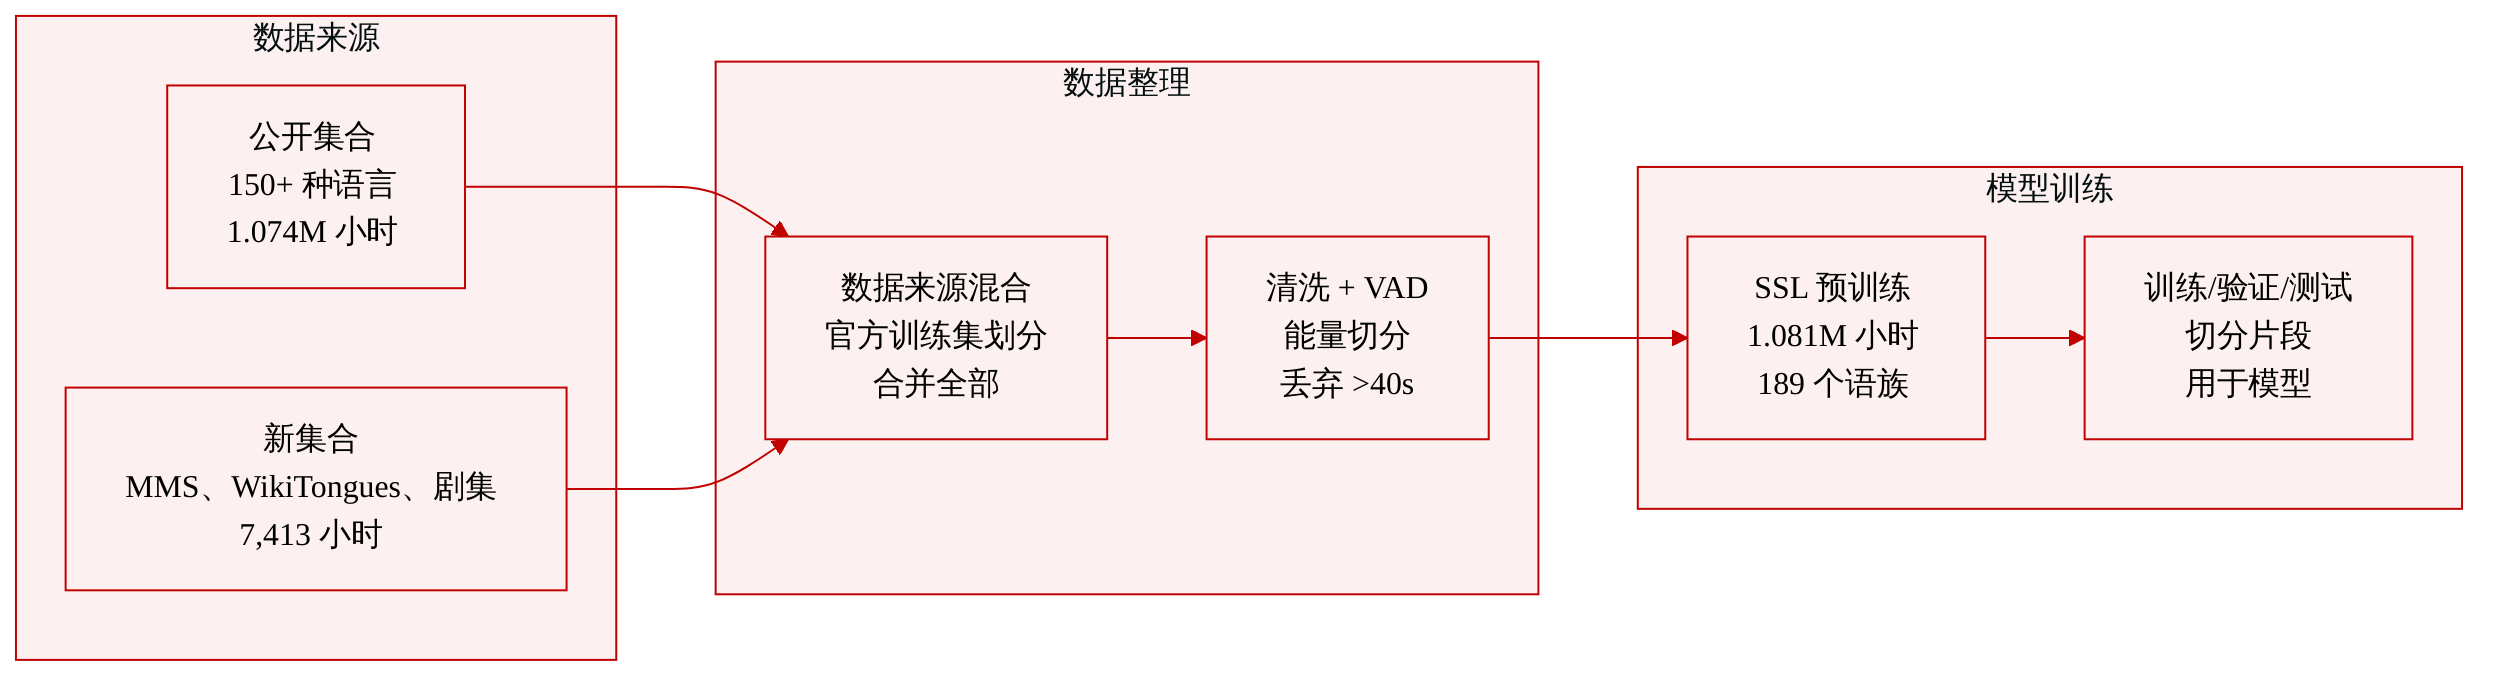
作者将 37 个公开语音数据集与 3 个新收集数据集组合,构建用于语音自监督学习的大规模无标注预训练语料库。
-
现有数据集:
- 作者仅使用每个公开数据集的官方训练划分,以避免在损坏或泄漏的测试数据上训练。
- 这些公开来源覆盖 150 多种语言,贡献 107.4 万小时音频。
- 显著内容包括带口音语音、语码转换和歌声,这些是较早的自监督语音模型未覆盖的。
-
MMS-unlab v2:
- 作者通过从 Global Recordings Network 爬取宗教有声读物,重新构建了较早未发布的 MMS-unlab 数据集。
- 与原版本不同,作者将覆盖范围扩展到额外 200 多种语言。
- 由于该数据用于自监督学习而非语言识别,作者不会过滤掉音频很少的语言。
- 为了效率以及跨多种语言的鲁棒性,作者使用基于能量的语音活动检测器分割长录音,而不是使用神经 VAD 模型。
- 该子集包含 4,023 个 ISO3 语言共 6,700 小时,语言覆盖范围比原版更广。
- 由于来源网站未明确说明许可条款,作者获得了使用并再分发该数据的明确书面许可。
-
WikiTongues:
- 作者从 WikiTongues 创建一个新语料库,该项目是一个旨在保护低资源、濒危和已消亡语言及方言的民间录音项目。
- 录音时长为 2 到 20 分钟,通常包含 1 到 2 名说话人以随意方式说出目标语言或方言。
- 该数据以 CC-BY-NC 许可发布。
- 所收集子集包含约 700 种语言或方言、821 条录音和约 70 小时语音。
- 作者使用与 MMS-unlab v2 相同的基于能量 VAD 设置,将录音分割为更短片段。
-
Jesus Dramas:
- 作者从 Inspirational Films 收集第二个新语料库,该机构以非商业许可发布了 430 种语言的 “Story of Jesus” 广播剧。
- 每部剧是 90 分钟多说话人录音。
- 完整子集共 645 小时语音。
- 作者使用相同 VAD 设置,将广播剧分割为话语级片段。
-
最终语料库与用途:
- 三个新收集子集合计覆盖 4,057 个 ISO3 语言,共 7,413 小时。
- 与公开数据集合并后,完整预训练语料库达到 108.1 万小时音频。
- 由于内存约束,作者过滤所有超过 40 秒的话语。
- 最终数据涵盖 189 个语系,并呈现长尾语言分布:前 50 种语言占 99.5% 的数据,而约 2,000 种语言各自至少有一小时。
- 由于 YODAS 的语言标签噪声过大,部分语言分析中会排除其数据。
- 作者跟踪语料库元数据和许可信息,并在 ISO3 级别分析已收集和公开子集的语言覆盖。
方法
作者将 XEUS 设计为一个掩码预测预训练流程,将语音目标学习与声学增强任务结合。该框架包含教师分支、破坏分支和学生分支:教师分支生成干净目标,破坏分支修改输入波形,学生分支从受损输入预测干净目标。如框架图所示:
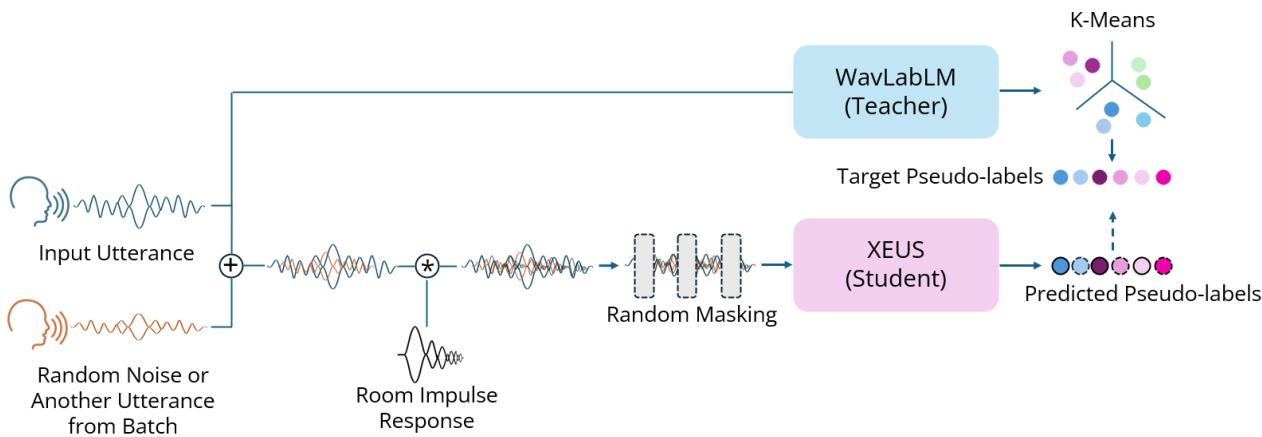
目标生成过程使用预训练的 WavLabLM MS 模型作为教师。作者利用该教师从干净语音中提取编码表示,然后使用 2048 个聚类中心对这些表示进行 k-means 聚类。所得离散码作为语音学伪标签。这些目标仅来自未破坏的语音,因此即使输入波形已被破坏,学生也必须推断出相同的干净目标。
第一个破坏机制是掩码预测。在波形进入学生编码器之前对其进行随机掩码,迫使模型从周围声学上下文中恢复缺失的目标信息。第二个机制是声学去噪。以概率 p,输入话语会增强随机噪声,或使用同一批次中的另一话语作为干扰进行增强。由于伪标签仍绑定到原始干净语音,学生被鼓励在内部去除新增声学干扰。
作者还引入去混响目标。以概率 pr,选定话语会通过采样的房间冲激响应进行增强。设 u 表示原始话语,un 表示采样的房间冲激响应。该方法首先根据冲激响应中的最高峰值估计样本位移 dt。然后通过卷积模拟混响信号:
r=u⊛un.卷积后,使用 dt 将 r 与原始话语重新对齐,并归一化以匹配 u 的能量。该重对齐步骤至关重要,因为若没有它,增强后的音频会相对于干净伪标签发生位移,造成标签对齐错误。如果对同一话语同时应用噪声和混响增强,则先应用噪声增强。
对于学生模型,作者基于 HuBERT 风格架构构建 XEUS,但将原始 Transformer 替换为 E-Branchformer 主干。作者选择该设计,因为卷积增强模型提供更强的自监督表示学习能力,而 E-Branchformer 相比 Conformer 具有实际训练优势。架构由卷积特征提取器和随后 19 层 E-Branchformer 层组成。每层包含 8 个注意力头、1,024 隐藏维度、4,096 前馈大小和 31 卷积核大小。完整模型有 577M 参数。训练目标使用预测伪标签与教师生成的干净目标之间的交叉熵损失。
预训练过程使用 ESPnet 工具包在 64 个 NVIDIA A100 GPU 上完成。每个 GPU 的最大 batch size 为 100 秒,总 batch size 为 106 分钟。噪声增强概率设置为 p=0.2,随机噪声和作为干扰的同一批次话语概率相等。去混响增强概率设置为 pr=0.3。模型训练两轮数据,相当于总共 670K 个优化步骤。作者还优化开源 ESPnet 基础设施以支持该大规模训练流程。
实验
下游实验使用 ML-SUPERB、FLEURS、低资源语音翻译、英语 SUPERB 基准和语音重合成,评估 XEUS 在多语言语音处理、任务通用性和声学表示质量上的表现。结果表明,XEUS 与强多语言和仅英语 SSL 基线相比普遍具有竞争力或更优,尤其在众多语言和低资源设置中表现突出,说明其具有广覆盖并高效利用训练数据。它还产生强通用语音表示和高质量生成声学特征,同时支持识别与合成应用。
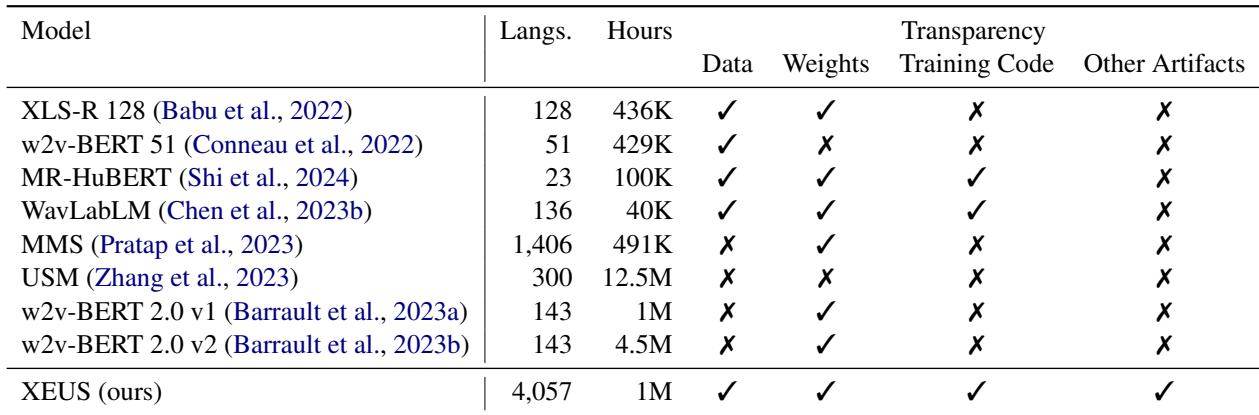
比较显示,在多语言语音 SSL 模型中,广泛语言覆盖、大训练数据规模和开放发布实践很少同时出现。具有更广泛语言覆盖或更大数据预算的模型通常公开更少组件,例如数据、权重、训练代码或产物,而更透明的模型往往规模较小。所描述的 XEUS 设置被表述为一种努力,将广泛语言覆盖与公开数据、代码、检查点、日志和中间训练产物结合起来。透明度通常是不完全的,模型可能只发布数据、权重、代码和产物中的部分组合。语言覆盖更广或数据预算更大的模型往往比规模较小、更透明的模型开放程度更低。
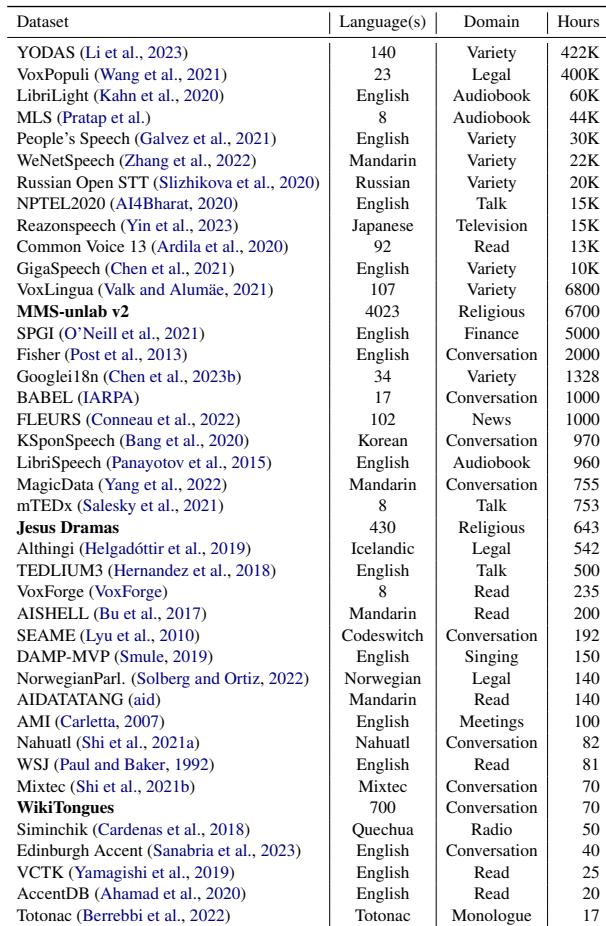
预训练数据组合许多公开可用语音数据集,形成覆盖多样领域和音频类型的广谱多语言混合。该混合包括大量通用语音、法律语音、有声书语音,以及英语、普通话和俄语等多个大规模语言群体。它还包含带口音语音、语码转换和歌声等内容类型。数据集混合强调广泛语言覆盖,而非单一语言或单一领域。YODAS 和 VoxPopuli 位于最大贡献者之列,显示对极大型精选语音来源的依赖。语料库既包含多语言覆盖,也包含英语、普通话和俄语等聚焦语言数据集。部分列出的数据集是拟发布的新语料库。
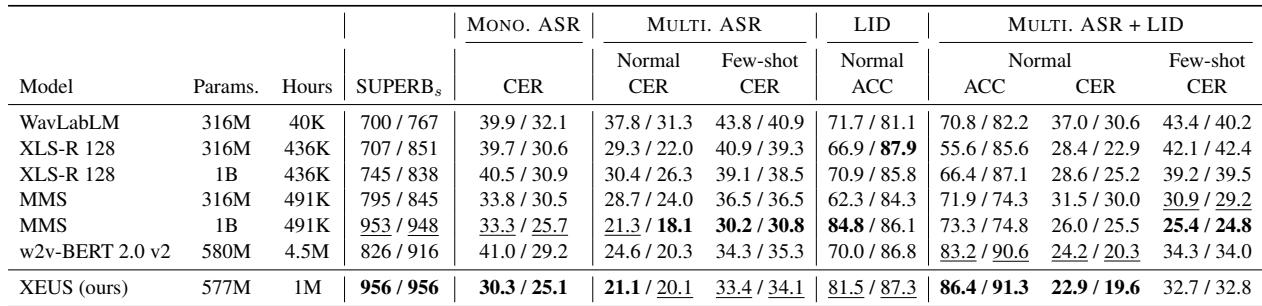
XEUS 是多语言语音处理基准上综合表现最佳的模型,在数据受限和数据更充足设置中均取得最高综合分数。它在单语语音识别以及正常设置下带 LID 的多语言 ASR 上领先,并在参数量相当的情况下,于各任务类别中优于 w2v-BERT 2.0 v2,同时使用少得多的可访问训练数据。MMS 在某些多语言 ASR 和少样本 ASR 设置中仍更强,但 XEUS 仍超过多数其他自监督基线。XEUS 在两种数据设置中的整体多语言基准上排名第一。XEUS 在两个赛道上均取得最佳单语 ASR 性能。XEUS 在两个赛道上都是正常多语言 ASR with LID 的最佳模型。MMS 在某些多语言 ASR 和少样本 ASR 结果上优于 XEUS。XEUS 以少得多的可访问训练数据,在各任务类别上优于 w2v-BERT 2.0 v2。
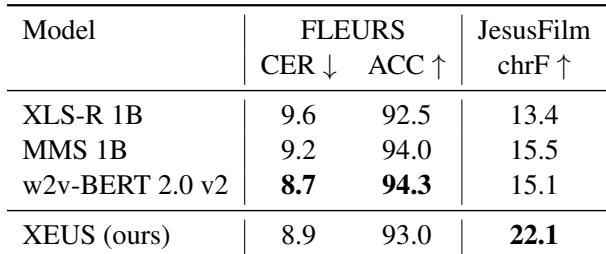
XEUS 在 FLEURS 多语言 ASR 上表现具有竞争力,在识别错误上优于 XLS-R 和 MMS,并接近 w2v-BERT。它还在所有被比较模型中给出最强的 Jesus Film 英语语音翻译字符级质量,这与其更广的语言覆盖一致。XEUS 在 FLEURS 上使用更少训练数据即可与 w2v-BERT 竞争力相当。XEUS 在 FLEURS 识别错误上优于 XLS-R 和 MMS。XEUS 在 Jesus Film 语音翻译质量上领先所有被比较模型。
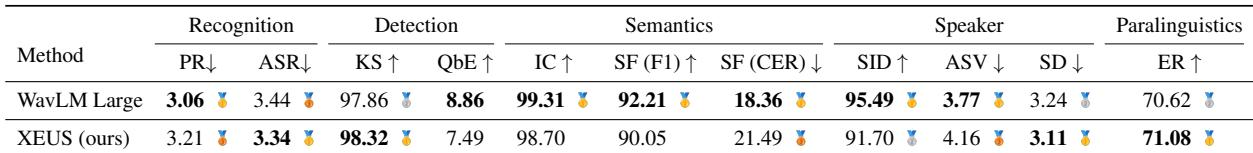
在仅英语 SUPERB 评估中,XEUS 与 WavLM Large 在识别、检测、语义、说话人和副语言任务上竞争力相当。它在多个任务上取得最佳分数,包括自动语音识别、关键词检测、说话人分离和情感识别。比较表明,XEUS 在多种语音任务上具有良好迁移能力,尽管 WavLM 在若干剩余指标上仍更强。XEUS 在四个评估任务中取得最佳结果:ASR、关键词检测、说话人分离和情感识别。WavLM Large 在若干剩余任务上仍优于 XEUS,尤其是某些语义和说话人任务。
实验评估 XEUS 的透明度、预训练数据构建以及在多语言和仅英语语音基准上的性能。分析表明,XEUS 通过将广泛多语言和多领域语音与公开组件结合,缓解了广泛语言覆盖、大数据预算和开放发布之间常见取舍,而可比较模型通常缺少这些属性中的一项或多项。在所有基准上,XEUS 在两种数据设置中均为最强整体多语言模型,尤其在单语和正常设置下带 LID 多语言 ASR 方面,并能在多种仅英语任务上良好迁移,尽管某些现有基线在特定领域仍然更强。