Command Palette
Search for a command to run...
语言模型从较不罕见的现象中学习罕见现象:AANN 构式缺失案例
语言模型从较不罕见的现象中学习罕见现象:AANN 构式缺失案例
Kanishka Misra Kyle Mahowald
摘要
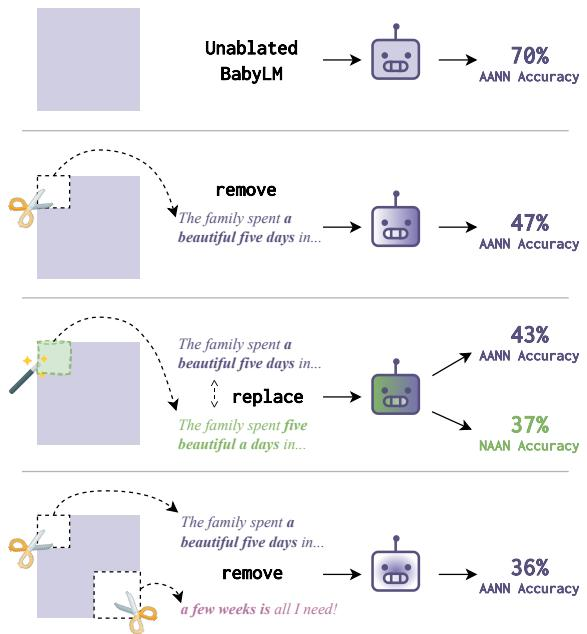
语言模型能够学习罕见的句法现象,但这种现象在多大程度上归因于泛化而非记忆,仍是一个重大开放问题。为此,我们在人类规模的系统性操控语料上迭代训练 Transformer 语言模型,然后评估其对一种罕见语法现象的学习:英语的冠词+形容词+数词+名词(AANN)构式(如 "a beautiful five days")。我们比较了模型在默认语料上相对于移除 AANN 句子的反事实语料对该构式的习得效果。我们发现,AANN 构式的学习效果仍优于其系统性扰动的变体。通过额外的反事实语料,我们提出这种学习是通过从相关构式(如 "a few days")进行泛化而实现的。另一项实验表明,当输入中具有更多多样性时,这种学习效果会得到增强。综合来看,我们的结果提供了存在性证明:语言模型能够通过从较不罕见的现象进行泛化来学习罕见的语法现象。
一句话总结
得克萨斯大学奥斯汀分校的研究人员通过反事实语料实验证明,transformer 语言模型能够从较不罕见的相近结构(例如 “a few days”)进行泛化,从而习得英语 Article+Adjective+Numeral+Noun 结构(例如 “a beautiful five days”)。这提供了存在性证据,说明罕见语法现象的习得由泛化而非记忆驱动。
核心贡献
-
在 BabyLM 上训练的 transformer 语言模型能够从人类规模且经过系统操作的语料中学习英语 Article+Adjective+Numeral+Noun 结构;即使未接触 AANN,模型也能以远高于随机水平的表现对新的 AANN 进行判定,而经过词序打乱变体训练的模型泛化效果较差。
-
反事实语料表明,对未见 AANN 的泛化取决于相关结构:将类似 “a few days” 的度量名词短语的单数处理从训练数据中排除后,未见 AANN 的似然平均降低 36.5%;数据量控制表明,这种下降反映的是结构相关证据的缺失,而不是训练集规模变小。
-
罕见结构输入的变异性会提升泛化能力:在包含更多样形容词、数词和名词槽位的 AANN 上训练的模型,优于在受限重复实例上训练的模型,这支持罕见现象习得的统计学习解释。
引言
人类能够接受并产出罕见语法结构,例如 “a beautiful five days” 或 Participle Island Protection Property 模式,即使这些结构在实际经验中几乎不存在。大型语言模型能否同样从现实规模数据中学习罕见语法,这一点很重要,因为它检验统计学习和一般抽象能否在缺乏强先天偏好的情况下解释语言知识。已有工作存在局限,因为现代 LLM 通常会看到远多于人类的数据,导致难以判断罕见结构是被记忆还是真正被抽象出来;此外,受控预训练研究大多关注常见结构,而非语言长尾。作者利用 1 亿词的 BabyLM 语料和系统数据操作,针对一种罕见的 adjective-adjective-numeral-noun 结构训练 transformer,同时排除或修改相关常见现象。研究结果表明,模型即使没有直接暴露也能泛化到新的罕见结构;当相关结构(例如表现得像单数名词短语的度量短语)存在于训练数据中时,泛化尤为明显。这为罕见语法可由更常见结构上的抽象产生提供了证据。
数据集
-
基础训练语料: 作者使用 BabyLM-strict 语料作为主要训练集。它包含约 1 亿 tokens,选择它是由于其规模接近人类水平,同时足以进行大规模建模并对目标结构进行细致检查。
-
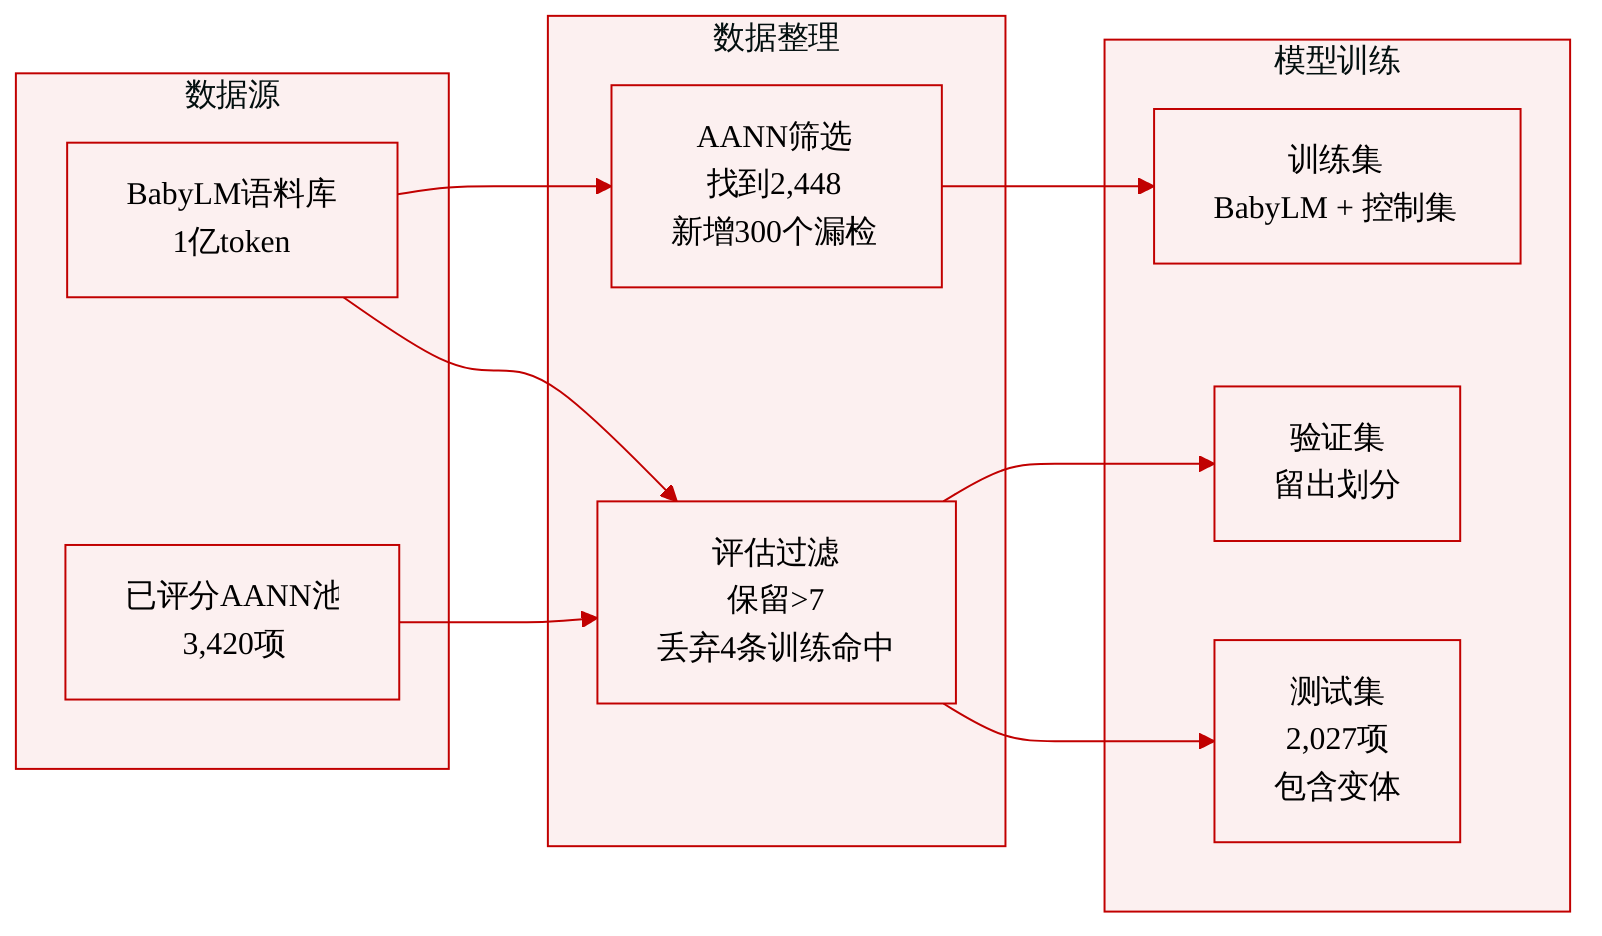
训练语料中的目标实例检测: 为识别 BabyLM 中的 AANN 结构,作者对经过词性标注的语料应用正则表达式。作者使用非常宽松搜索模式选取手工标注示例来改进正则表达式,获得了较高的估计召回率。最终正则表达式找到 2,448 个 AANN 实例,约占 1150 万条话语的 0.02%。
-
召回率稳健性控制: 由于基于正则表达式的检测无法保证完美召回,作者还创建了一个保守控制,假设漏检了 300 个 AANN 实例,并用这些实例人工污染数据。这用于检验发现是否依赖未检测到的实例。
-
评测语料: 测试数据来自 Mahowald (2023),其中包含 12,960 个模板生成、含 AANN 结构的句子。其中 3,420 个句子包含 190 名参与者在 1 到 10 分量表上的人类可接受性评分。
-
评测过滤: 作者仅保留人类平均可接受性评分高于 7 的项目。作者还移除 4 个出现在 BabyLM 训练集中的实例,以避免污染。最终得到 2,027 个项目的评测集。
-
元数据与替代形式: 每个评测项目包含目标 AANN 句子,以及修改形容词与数词顺序、冠词是否存在、形容词是否存在和数词是否存在的损坏变体。这些变体可用于评估模型是否对合规 AANN 句子赋予更高似然,而不是系统损坏版本。
方法
作者采用一套紧凑的自回归语言建模流程,结合模型训练、目标结构检测和基于可接受性的评分。核心模型是 OPT 风格的 transformer 语言模型。它使用 12 个 transformer 层和 12 个注意力头、16,384 个 subword tokens 的词汇表,并使用 transformers 库训练最多 20 个训练轮次。报告的估计值基于三次不同随机种子的独立运行取平均,以降低方差。
检测模块识别训练语料中目标 AANN 结构的实例。工作流基于带词性信息的语料版本。它从一个较宽的正则表达式开始,查找类似冠词后接数词和复数名词的序列,然后使用人工标注反馈迭代收紧规则。这形成了一个实用的过滤流程,能够隔离目标结构并减少误报。由于基于规则检测仍可能漏掉罕见实例,作者包含一个稳健性控制,假设存在较多未检测 AANN,并用合成实例人工污染数据。该步骤使流程能够检验在结构检测不完美时,观察到的效果是否仍保持稳定。
在评测阶段,作者使用包含模板生成句子的人类可接受性评分的数据。作者仅保留人类参与者将结构评为明显可接受的示例(阈值为高于 7),并丢弃也出现在训练语料中的示例。剩余示例与损坏替代项配对,这些替代项修改形容词与数词顺序、冠词是否存在、形容词是否存在和数词是否存在。这构成了强制选择测试:了解目标结构的模型应在每种损坏变体面前偏好合规版本。
模型使用句法对数几率比(Syntactic Log odds Ratio)进行评分。给定语言模型 m、unigram 估计器 u、目标结构 C 和一个前缀,分数定义为:
SLORprefix(C)=∣C∣1logpu(C)pm(C∣prefix)unigram 估计器在同一语料上使用与自回归模型相同的 tokenizer 训练。该归一化降低了准确率差异仅由数据操作引入的表面频率变化所驱动的可能性。对数概率使用 minicons 工具计算。如果合规结构的 SLOR 值高于所有四个损坏变体的 SLOR 值,则该项目被视为正确。准确率是这些正确项目所占比例;在五个选项比较中,随机水平为 20%。
实验
在 token 匹配消融的受控 BabyLM 设置中,实验检验语言模型是否学习罕见 AANN 结构、哪些周边现象支持该学习,以及实例变异性如何影响能产性。即使几乎没有或没有直接证据,模型仍能以高于随机的水平接受 AANN,偏好合乎语法的 AANN 而非反事实词序,并追踪已知词汇约束。消融实验表明,在未见过 AANN 时,相关结构、冠词周围的频率平衡以及度量名词的单数处理至关重要;而直接暴露加上高槽位变异性会进一步提升泛化,表明模型依赖系统性的分布和构式线索,而非浅层统计。
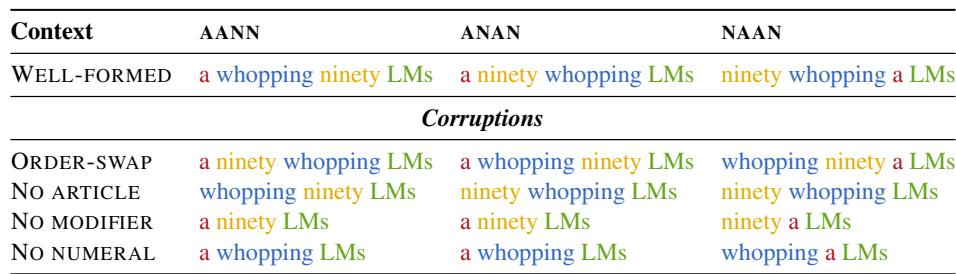
这些示例使用相同词汇项,将合规 AANN 模式与两个反事实变体 ANAN 和 NAAN 进行对比。它们展示如何通过改变顺序或移除冠词、形容词、数词,对每种结构进行最小损坏。合规 AANN 示例及其损坏版本支持相关测试,检验模型是否偏好合乎语法顺序而非被改动版本。损坏示例包括形容词与数词重排,以及缺少冠词、修饰语或数词。
该实验检验语言模型是否从与 AANN 共享特征的其他结构中学习 AANN 结构,例如限定词后的复数短语、few/couple/dozen 名词短语,以及搭配单数动词或不定冠词的度量名词短语。频率分布表明,可能的类比证据比直接 AANN 实例更常见;槽位变异性测试表明,高度可变的形容词和名词填充词相比受限填充词支持更广泛的泛化。移除这些相关结构可用于检验它们对未见 AANN 可接受性的作用。除数词槽位外,接触高度可变 AANN 槽位的模型表现出更高的能产性。
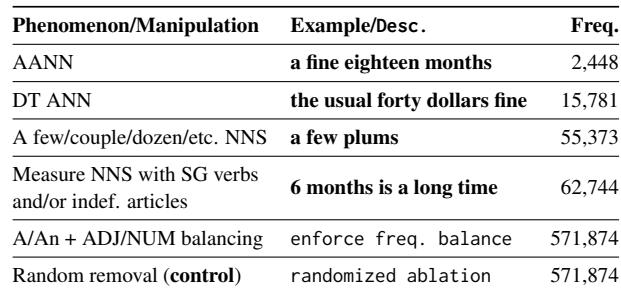
这些实验使用相同词汇项,将 AANN 结构与反事实变体和损坏变体进行比较,以检验模型是否偏好合规顺序和结构。实验还检验相关结构(例如复数名词短语和度量名词短语)是否为学习 AANN 提供类比证据,而槽位变异性操作则评估模型对该模式的泛化广度。移除这些相关结构进一步检验它们对未见 AANN 可接受性的贡献。