Command Palette
Search for a command to run...
面向上下文学习的迭代检索方法
面向上下文学习的迭代检索方法
Yunmo Chen Tongfei Chen Harsh Jhamtani Patrick Xia Richard Shin Jason Eisner Benjamin Van Durme
摘要
我们提出迭代检索,一种新颖的框架,通过策略优化赋予检索器进行迭代决策的能力。寻找最优检索项组合是一个组合优化问题,通常被认为是 NP 难问题。该方法为这类问题提供了学习得到的近似解,能够在给定的大语言模型(LLM)家族下满足特定任务需求。我们提出了一种基于强化学习的训练流程,融合了来自 LLM 的反馈。我们构建了一个用于组合上下文学习(ICL)示例的迭代检索器,并将其应用于需要将合成程序作为输出的各类语义解析任务。通过仅增加 4M 额外参数用于状态编码,我们将一个现成的稠密检索器转化为有状态的迭代检索器,在 SMCALFLOW、TREEDST 和 MTOP 等语义解析数据集上的 ICL 示例选择任务中超越了先前方法。此外,训练得到的迭代检索器能够泛化到训练时所用 LLM 之外的不同推理模型。
一句话总结
微软提出迭代检索,这是一种强化学习框架,仅增加 4M 个参数,即可将现成的稠密检索器转换为有状态迭代检索器。该方法近似求解了选择最优上下文学习示例这一 NP 难组合优化问题,并在语义解析任务上超越先前方法,同时能够泛化到不同的推理 LLM。
核心贡献
-
论文提出迭代检索,将上下文示例选择表述为策略优化,并学习逐步构建提示的检索动作,而不是一次性选择所有示例。
-
该方法在现成稠密检索器上增加 4M 个用于状态编码的参数,并使用来自推理 LLM 的反馈训练 RL 策略,使示例选择能够考虑所选示例之间的交互,以及它们与下游 LLM 之间的关系。
-
在 SMCALFLOW、TREEDST 和 MTOP 等语义解析数据集上的实验表明,训练后的迭代检索器在 ICL 示例选择方面优于强基线,并能够泛化到训练过程中所用推理 LLM 之外的其他推理 LLM。
引言
大型语言模型依赖上下文学习,其中所选示例引导少样本生成,并对于语义解析等任务尤其重要。以往的检索器通常基于语义相似度一次性选择示例,忽略示例之间的交互、示例顺序、目标 LLM 以及下游任务需求,这可能导致提示质量次优。作者利用迭代检索构建提示方案,将示例选择形式化为马尔可夫决策过程,并使用来自 LLM 反馈的强化学习训练有状态策略,以改进生成效果。
方法
用于上下文学习的迭代检索器
作者采用一种上下文学习表述:检索器选择一组示例,使语言模型更可能生成正确答案。给定示例数据集 D={(xi,yi)}i,理想检索行为将求解
arg(xi,yi)∈DmaxPLM(y∣x;((xi,yi))1≤i≤K),其中 K 个示例被放入提示中。该目标具有组合性,因此以往系统通常使用静态评分函数检索 top-K 集合。所提方法转而将检索视为迭代搜索过程:检索器维护一个汇总查询和已选示例的状态,每一步选择一个示例,并在每次选择后更新状态。
该过程可写为
(xi,yi)←Rstep(si), si+1←τ(si,(xi,yi)).经过 K 步后,检索结果是序列 Riter(x)=((xi,yi))1≤i≤K。作者将其形式化为马尔可夫决策过程,其中状态是部分构建的示例序列,动作选择下一个示例,转移操作追加所选示例,奖励来自语言模型对不断演进的上下文提示的响应。
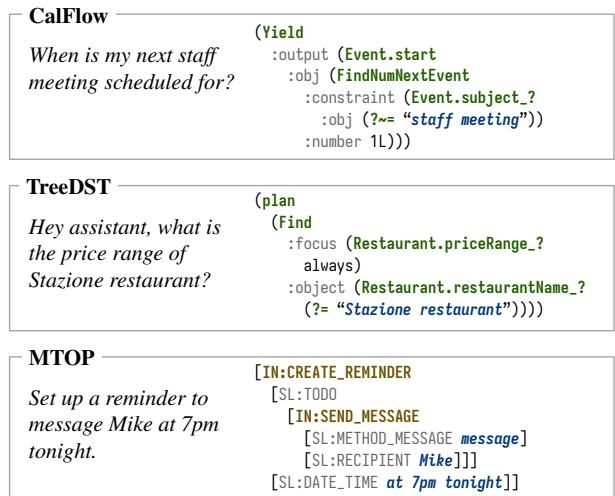
该方法被实例化到少样本语义解析任务中,其中自然语言查询必须通过示例条件提示转换为结构化语义表示。参考下方的示例查询和目标对,可以看到该设置中使用的输入输出结构类型:
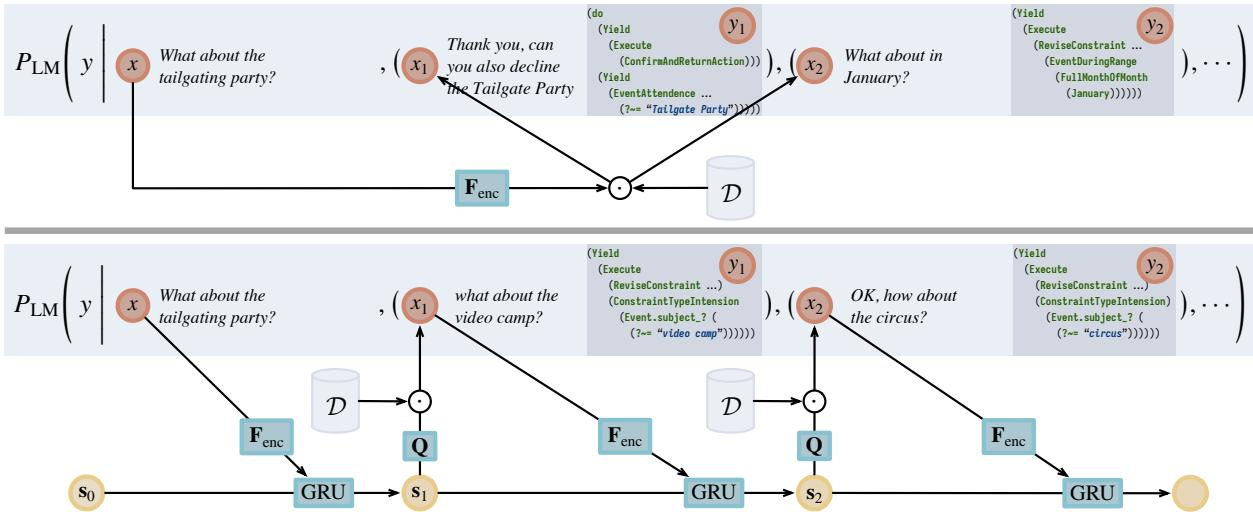
神经迭代检索器围绕紧凑的循环状态向量 s∈Rd 构建。初始状态是可学习的,文本编码器 Fenc 将自然语言文本映射为嵌入。在每个检索步骤,检索器使用策略分布对每个候选示例评分
π((xi,yi)∣si)∝exp(βQ(si)⋅Fenc(xi)),其中 Q 将当前状态映射为查询向量,β 控制分布的温度。如果采用贪心检索,则下一个示例通过最大内积搜索获得:
(xi,yi)=arg(x′,y′)∈DmaxQ(si)⋅Fenc(x′).该表述允许有状态检索过程在每一步使用近似最近邻索引,例如 FAISS。选定示例后,状态使用门控循环单元更新:
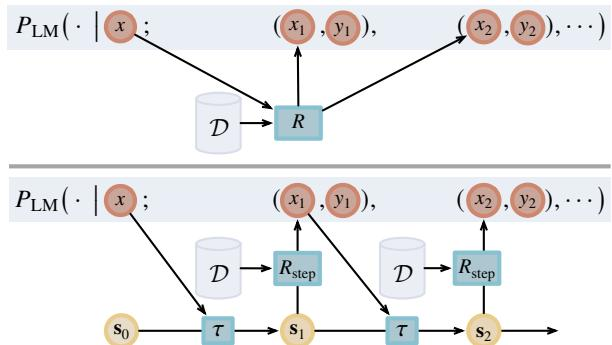
si+1←GRU(si,Fenc(xi)).这种状态转移是该架构的核心,因为它让检索器能够动态导航嵌入空间。系统不是向候选集合发出一个静态查询,而是根据已经选择的示例不断修正检索意图。如下框架图所示,上方路径对应传统的单步稠密检索器,下方路径展示迭代检索器在每次检索后更新状态:
训练过程将语言模型本身用作环境模拟器。在每个步骤,当前所选示例序列被转换为上下文提示,输入语言模型,并用于观察补全概率或生成动态。由于精确匹配等最终任务指标可能稀疏且粗略,作者基于语言模型对参考输出的似然设计更细粒度的奖励信号。该奖励衡量新检索示例的增量贡献:
r(si,xi)=PLM(y∗∣x;si,(xi,yi))−PLM(y∗∣x;si).这鼓励检索器选择在给定当前提示上下文下提高目标解析概率的示例。
检索策略使用近端策略优化进行优化。对于在第 i 步采样的动作,当前策略与旧策略之间的概率比为
ρi=πθold((xi,yi)∣si)πθ((xi,yi)∣si).裁剪策略目标为
Lclip(θ)=E^i[min(ρiA^i,clipϵ(ρi)A^i)].为计算优势估计 A^i,框架在循环状态上添加一个轻量级状态价值函数。使用广义优势估计,并采用 TD 残差
δi=ri+γV(si+1)−V(si),随后得到
A^i=δi+(γλ)δi+1+⋯+(γλ)T−i−1δT−1.总体训练信号结合裁剪策略改进项、价值回归项和熵奖励项,以保持探索能力。
一个重要稳定细节是状态转移模型的初始化。作者将 GRU 更新门偏置初始化为 bz=−∞,使更新门在训练开始时表现为恒等映射。这意味着循环状态最初几乎不变,从而减少检索轨迹中的早期不稳定。
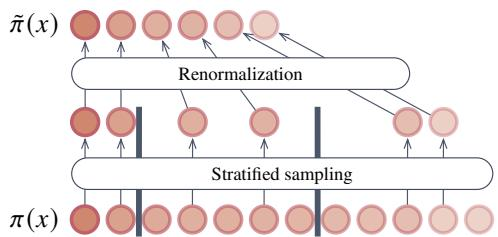
从覆盖极大候选集合的完整检索分布中采样成本高昂。因此,作者引入分层采样过程,以可控候选池近似动作分布。首先,使用策略分数检索分数最高的 k 个示例。直接保留该 top 排名中大小为 k/Ns 的子集。将剩余候选划分为 Ns−1 层,并从每层采样 k/Ns 个候选。然后使用 softmax 对所得候选重新归一化,形成修改后的策略 π~。这在高分数示例的利用与更广分数区域的探索之间取得平衡。参考下图了解该分层采样过程示意:
训练期间,作者通过在多个训练输入上运行当前策略来收集经验,记录每条轨迹的动作、奖励、策略概率和状态值。这些轨迹存储在经验回放缓冲池中,进行打乱,并切分为小批量用于策略优化,从而相比反复与语言模型环境交互提升样本效率。
实验
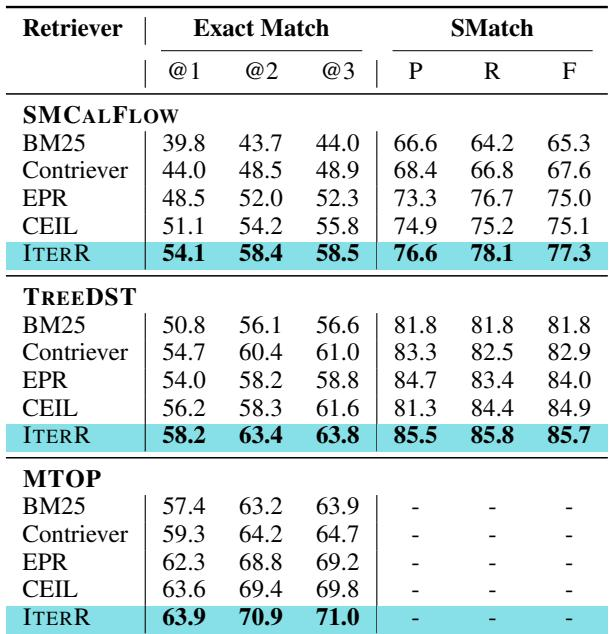
实验在 SMCALFLOW、TREEDST 和 MTOP 上评估用于上下文语义解析的迭代检索器,并与 BM25、Contriever、EPR 和 CEIL 在多个 LLM 以及精确匹配、结构 SMatch 等指标上进行比较。所提方法持续带来更强的下游检索和解析性能,并在数据集、模型大小和模型家族上均取得广泛提升,同时能够以更少示例支持有效生成。消融实验进一步表明,EPR 初始化和分层采样很重要,而用 Transformer 解码器替换 GRU 状态编码器会引入训练不稳定并降低性能。
ITERR 在语义解析上优于 BM25、Contriever、EPR 和 CEIL,提高了下游上下文学习性能,并获得更高的精确匹配和组合性指标。这一提升与其训练目标一致,并表明更好的组合检索质量,尤其与 CEIL 相比。ITERR 在精确匹配和语义相似度指标上优于所比较的基线。CEIL 在精确匹配上呈现类似趋势,但组合性分数更弱,而 ITERR 在两个方面均有提升。
完整迭代检索器优于 Contriever 基线,表明训练过程和检索器组件在评估数据集上是有效的。主要提升来自 EPR 初始化,而 GRU 状态转移和分层采样各自带来比更弱替代方案更强的检索性能。用 Transformer 解码器替换 GRU 会降低性能,可能因为策略变得不稳定,或学到过度固定的检索轨迹。即使没有 EPR 初始化,迭代检索仍优于 Contriever,但使用 EPR 初始化时提升显著更大。尽管表达能力更强,使用 Transformer 解码器进行状态转移仍会相比 GRU 降低性能。移除分层采样会损害检索性能,表明原始策略采样过度关注利用,而不是平衡探索。
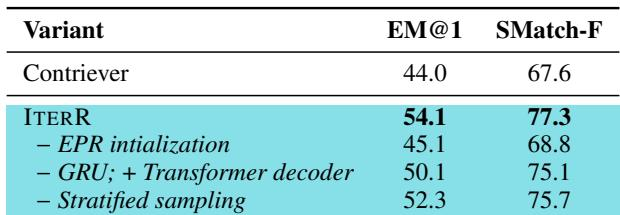
实验评估面向语义解析的检索增强上下文学习,并与 BM25、Contriever、EPR 和 CEIL 进行比较,同时对 EPR 初始化、状态转移和采样进行组件消融。结果表明,ITERR 实现更好的组合检索质量和下游性能,尤其体现在精确匹配和组合性上;CEIL 在匹配质量上仍具竞争力,但组合性较弱。消融实验进一步表明,完整迭代检索器通过训练过程优于 Contriever,其中 EPR 初始化贡献主要提升,而 GRU 状态转移和分层采样支持比基于 Transformer 的转移或移除采样更稳定、更平衡的检索。