Command Palette
Search for a command to run...
一语抵千图:度量与理解文本到图像生成中的感知变异性
一语抵千图:度量与理解文本到图像生成中的感知变异性
Raphael Tang Xinyu Zhang Lixinyu Xu Yao Lu Wenyan Li Pontus Stenetorp Jimmy Lin Ferhan Ture
摘要
扩散模型是文本到图像生成领域的最先进技术,但其感知变异性尚未得到充分研究。本文研究提示词如何在黑盒扩散模型中影响图像的变异性。我们提出了 W1KP,一种基于现有图像对感知距离进行自举的人类校准变异性度量。由于现有数据集未覆盖近期的扩散模型,我们构建了三个测试集用于评估。我们最优的感知距离在准确率上超越九种基线方法多达 18 个百分点,校准结果与分级人工评判的一致性达到 78%。利用 W1KP,我们研究了提示词的可复用性,结果表明 Imagen 的提示词可在 10–50 个随机种子间复用,之后新生成的图像与已有图像过于相似;而 Stable Diffusion XL 和 DALL-E 3 可复用 50–200 次。最后,我们分析了真实提示词的 56 项语言学特征,发现提示词长度、CLIP 嵌入范数、具体性和词义对变异性影响最大。据我们所知,我们是首个从视觉-语言学视角分析扩散模型变异性的工作。项目主页见 http://w1kp.com。
一句话总结
Comcast AI Technologies、滑铁卢大学、伦敦大学学院和哥本哈根大学的研究人员提出了 W1KP。它是一种用于衡量文本到图像扩散模型中感知可变性的、以人类判断校准的度量。其准确率比九个基线方法最高提升 18 分,并揭示了提示词长度、CLIP 嵌入范数、具体性和词语义项如何影响图像可变性。
核心贡献
-
该论文提出 W1KP,这是一种用于衡量生成图像集合感知可变性的、以人类判断校准的框架。该方法对现有图像对感知距离进行自助重采样,并针对分级人类判断进行校准。最佳校准距离在准确率上最高超过九个基线 18 分,并且与人类判断一致的比例达到 78%。
-
该工作将 W1KP 应用于评估黑盒扩散模型中的提示词可复用性,并为近期系统整理了三个评估集。测量结果显示,Imagen 提示词可以在 10 到 50 个随机种子之间复用,超过该范围后,新生成图像会与已生成图像过于相似;Stable Diffusion XL 和 DALL-E 3 则可以复用 50 到 200 次。
-
该研究分析了真实提示词的 56 个语言学特征,以考察扩散模型可变性的语言来源。提示词长度、CLIP 嵌入范数、具体性、词语义项、关键词、句法复杂度和语义丰富度都会影响可变性。
引言
该研究属于文本到图像生成领域,尤其关注扩散模型,其中同一个提示词可能根据随机种子产生许多视觉不同的图像。理解提示词语言如何驱动这种变化,对于需要受控、多样或可复用图像生成的从业者非常重要。
既有方法主要衡量成对感知相似度,并未针对对人类友好的相似度层级进行校准。当一个提示词可以生成近乎无限的图像集合时,这些分数难以解释。
作者通过提出 W1KP 来填补这一空白。W1KP 是一种以人类判断校准的框架,用于基于既有距离度量估计感知可变性。作者在人类判断上验证该方法,使用它测量不同模型之间的提示词可复用性,并表明具体性、嵌入范数和词语义项等语言学特征会影响图像可变性。
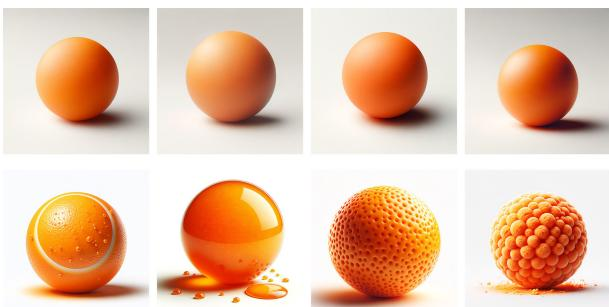
数据集
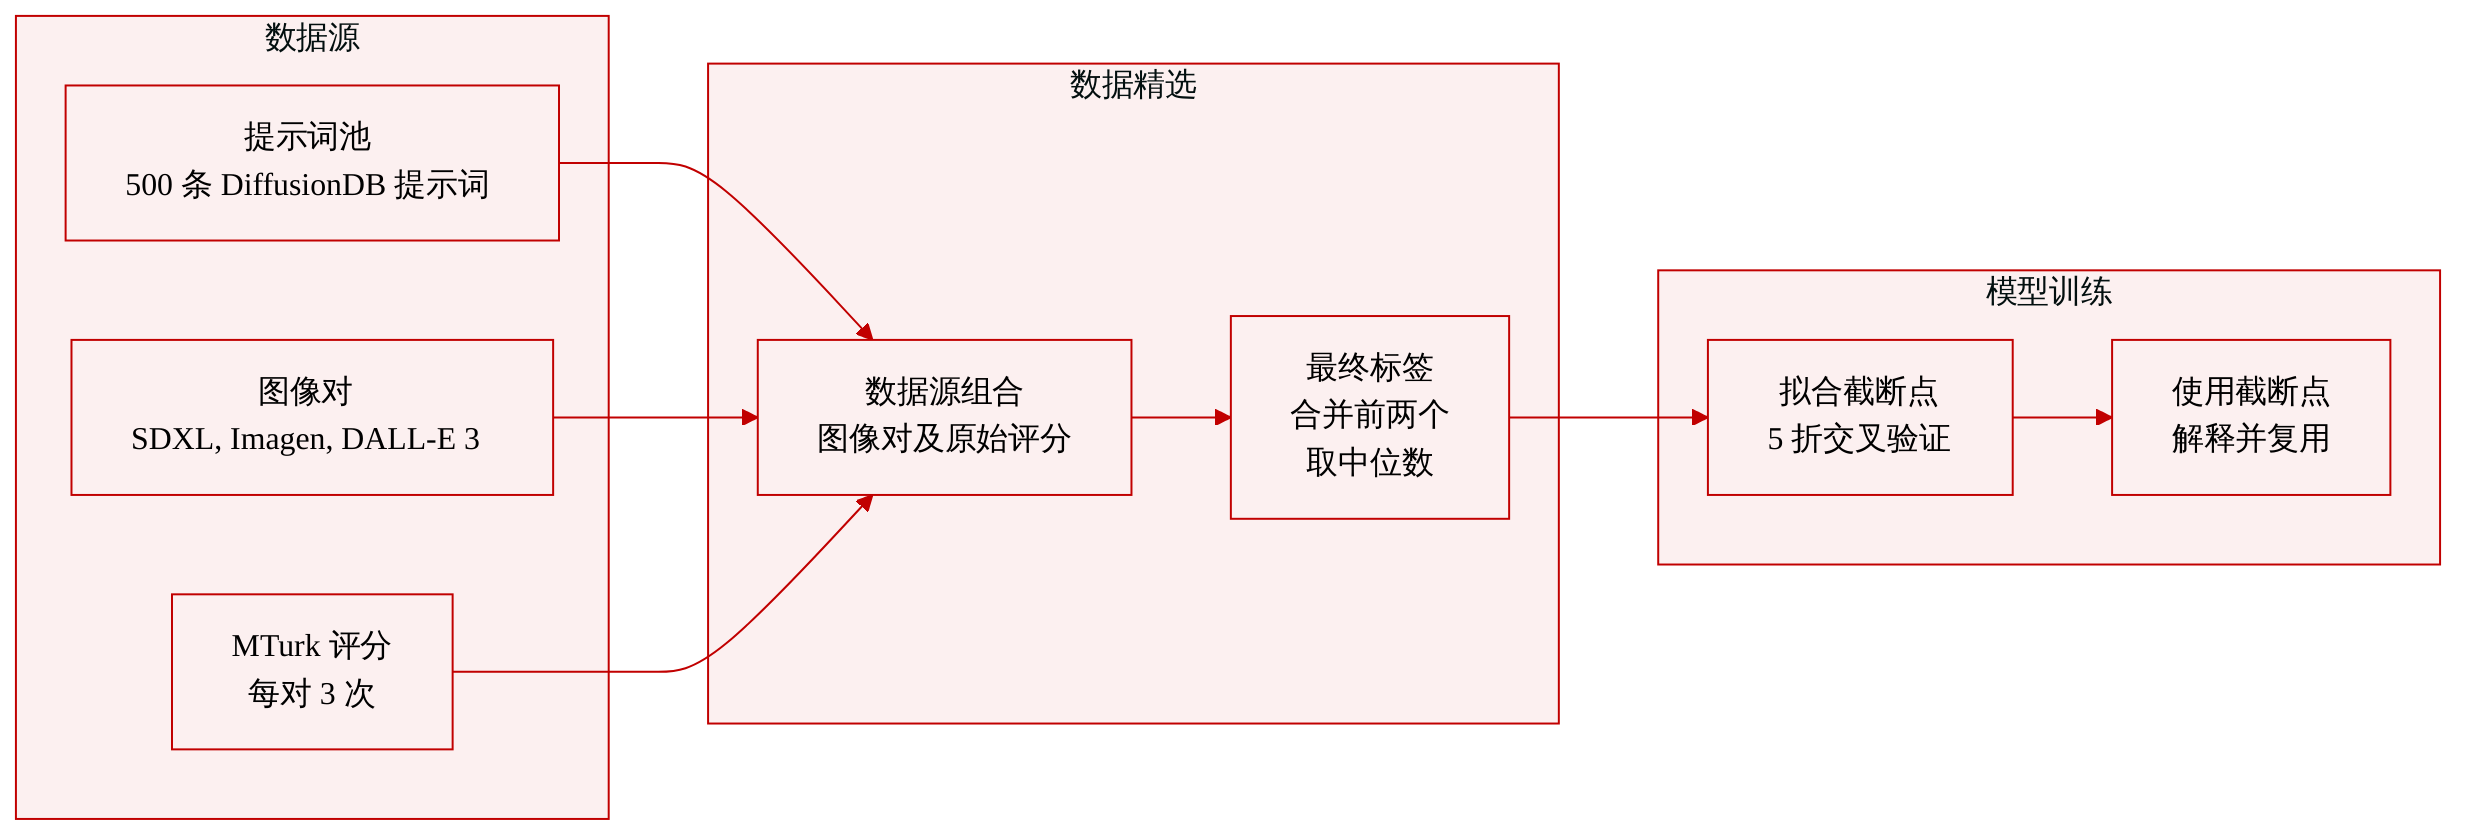
- 作者使用在 MTurk 上收集的人工标注校准数据集,对生成图像对的视觉相似度进行分级。
- 这些图像对来自从 DiffusionDB 中采样的 500 个随机提示词,并分别针对 SDXL、Imagen 和 DALL-E 3 收集,得到每个生成模型约 500 个已标注图像对,总共约 1,500 条中位数判断。
- 对于每一对图像,三名独立工作者在 1 到 5 的整数量表上对相似度进行评分,其中 1 表示“完全不相似”,5 表示“相同”。
- 作者将最高两个类别“相同”和“非常相似”合并,因为最高评分主要用于注意力检查,最终形成四个标签:无相似、低相似、中等相似和高相似。
- 每一对图像通过对三名工作者评分取中位数,获得一个真实标签。
- 最终的中位数标签大致按 10%、30%、40% 和 20% 分布在相似度等级 1 到 4 中。
- 每条记录可以视为一个提示词对标注,包含提示词、两张生成图像、生成模型、三名工作者的原始评分,以及四分类中位数相似度标签。
- 该数据集用于拟合并验证 W1KP 相似度阈值,采用五折交叉验证得到低、中和高相似度截断值。
- 作者随后使用这些校准后的截断值解释 W1KP 分数,包括使用高相似度截断值进行下游提示词可复用性分析。
方法
作者评估文本到图像扩散模型生成的合成图像的视觉多样性。该模型被视为黑盒,记为 G({wi};s,θ),其中提示词 {wi}、随机种子 s 和学习参数 θ 共同定义生成图像。为研究可变性,流程在保持文本条件固定的情况下,通过改变随机种子从同一提示词生成多张图像。随后,对得到的图像集合通过特征嵌入、成对感知距离、归一化和校准相似度标签进行分析。
如下图所示:
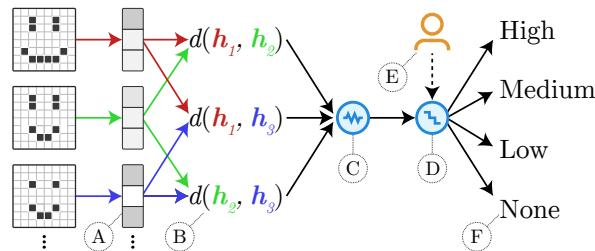
框架首先使用特征提取器 f 将每幅图像映射到嵌入空间。随后,使用感知距离函数 d 计算嵌入图像之间的成对距离。由于原始感知距离可能无界,或集中在很窄的范围内,该方法通过累积分布变换对其标准化。归一化距离定义为
d∗(Ia,Ib):=F(d(f(Ia),f(Ib))),其中 F 从生成图像对的大规模经验样本中估计得到。该变换产生位于单位区间内的数值,使分数在不同模型和提示词之间更具可解释性。
利用这些归一化距离,作者通过 U 统计量构建可变性度量。令 I={Ii}i=1n 表示从单个提示词独立采样生成的一组图像。一组通用的集合级分数定义如下
Ud,h(I):=(αn)11≤i1<⋯<iα≤n∑h(f(Ii1),…,f(Iiα);d),其中 h 是基于距离函数构造的 α 元核函数。文中使用了两个重要实例。成对平均得分汇总所有图像对的相似度:
ηmean(I)=(2n)1i<j∑d∗(Ii,Ij).k 期望最大值得分则衡量大小为 k 的子集中最接近图像对的期望相似度:
ηk(I)=(kn)11≤i1<⋯<ik≤n∑r=smind∗(Iir,Iis).为了便于阅读,最终得分被取反,使得数值越高表示相似度越高。作者将这一面向相似度的得分记为
η~:=1−η.校准模块随后将归一化得分映射为人类可解释类别。图像对相似度的人类判断被收集为标签,例如高相似、中相似、低相似或无相似。该方法学习截断点 βlow、βmid 和 βhigh,用于划分得分范围并最大化与这些标签的一致性:
argβlow,βmid,βhighmaxN1i=1∑NI(η~({Ixi,Iyi})∈Szi).这些区间定义为 Snone=[0,βlow)、Slow=[βlow,βmid)、Smid=[βmid,βhigh) 和 Shigh=[βhigh,1]。
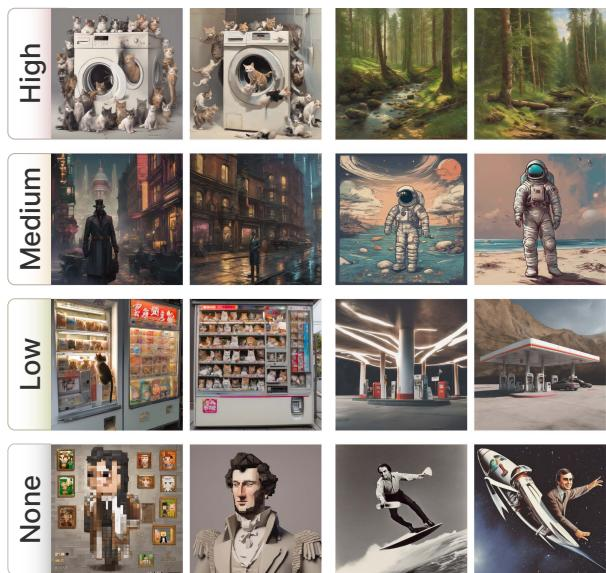
校准后的得分范围对应感知相似度等级,以下示例展示了基于得分将同一提示词生成的图像对分配到高、中、低或无相似度类别:
实验
实验使用人工标注的相似度判断来验证并校准 W1KP。W1KP 是一种基于 DreamSim 启发骨干模型的感知可变性度量。校准得到与人类评分一致性较高的可解释相似度截断值,并且相比替代方法具有更低的模型间偏差。将 W1KP 应用于图像生成后发现,不同文本到图像模型之间的提示词可复用性不同。提示词长度、CLIP 嵌入范数、具体性和多义性等语言学特征能够一致预测视觉可变性,包括在受控的单词提示词设置中也是如此。
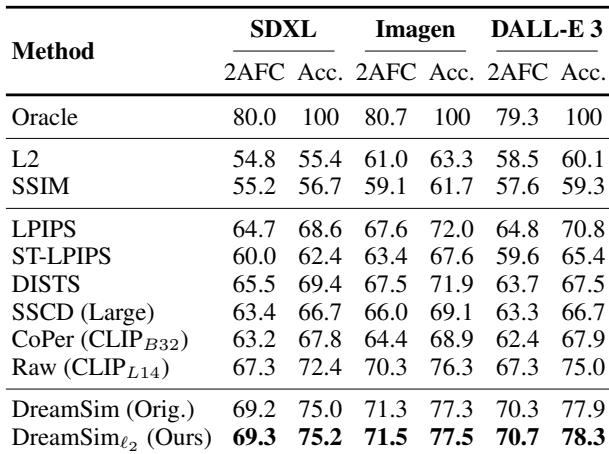
评估将 SDXL、Imagen 和 DALL-E 3 生成图像的感知距离骨干模型与人类判断进行比较。与原始像素距离和结构相似度相比,神经感知指标与人类偏好的一致性更强。在所评估的非 oracle 骨干模型中,LPIPS 和 DISTS 最强,其相对排名会随图像生成模型略有变化。在所测试的图像模型上,神经感知骨干模型优于简单欧氏距离和 SSIM。LPIPS 和 DISTS 与人类选择的一致性最高,其中 LPIPS 在 Imagen 和 DALL-E 3 上表现最佳,DISTS 在 SDXL 上略好。oracle 参考实现最高一致性和最高准确率,为骨干模型评估设定了性能上界。
显著的语言学特征聚类为可解释因子,表明提示词措辞和风格关键词形成结构化维度,而不是孤立信号。基于关键词的风格线索,例如分辨率、写实度和艺术网站标签,彼此紧密聚簇;更广泛的词汇特征也与提示词可解释性相关。相关发现表明,具体且单义的提示词与较低的感知可变性相关,而抽象或多义提示词的可变性更高。风格关键词在一个可解释因子上具有共同载荷,说明提示词中的视觉风格线索彼此相关。载荷较低且不显著的特征被移除,以强调语言学特征与提示词行为之间的可靠关联。具体词和单义词相关的可变性低于抽象词和多义词。
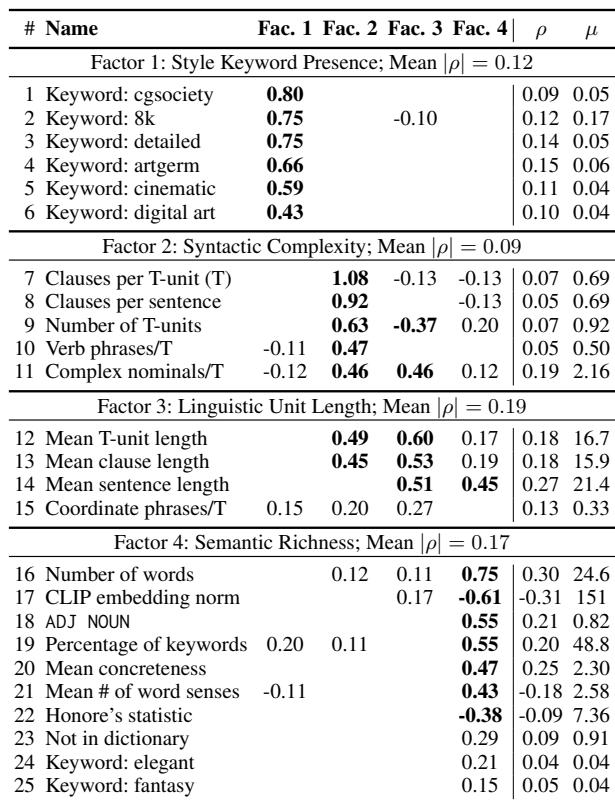
实验评估 SDXL、Imagen 和 DALL-E 3 生成图像的感知距离骨干模型与人类偏好之间的一致性,结果显示神经指标比原始像素距离或结构相似度更贴近人类判断。在非 oracle 骨干模型中,LPIPS 和 DISTS 表现最强,其中 Imagen 和 DALL-E 3 更偏向 LPIPS,SDXL 更偏向 DISTS,oracle 参考定义上界。对提示词语言学特征的进一步分析发现,风格相关线索聚为可解释维度,具体且单义的提示词往往比抽象或多义提示词具有更低的视觉可变性。