Command Palette
Search for a command to run...
正式性优先:揭示大语言模型对冲突知识的学习偏好
正式性优先:揭示大语言模型对冲突知识的学习偏好
Jiahuan Li Yiqing Cao Shujian Huang Jiajun Chen
摘要
大语言模型经过海量预训练数据的训练后,在许多知识密集型任务上展现出卓越的性能。然而,预训练数据中往往包含误导性甚至相互冲突的信息,探究大语言模型在训练过程中如何处理这些噪声数据具有重要意义。本研究系统分析了大语言模型对包含冲突知识的数据的学习偏好。研究发现,预训练后的大语言模型建立了类似于人类的学习偏好,即倾向于正式文本和拼写错误较少的文本,导致在面对冲突时,具有此类特征的数据中的知识能被更快地学习并获得更有利的处理。这一发现具有跨模型和跨语言的泛化性,且在规模更大的模型中表现得更为显著。深入分析表明,大语言模型倾向于信任那些具有与多数数据一致性特征的数据,并且通过操控数据与多数数据的一致性程度,可以灌输新的偏好或消除旧的偏好。
一句话总结
南京大学研究人员发现,LLM 在面对存在冲突知识的训练数据时会形成类似人类的学习偏好,更偏好正式且拼写正确的文本,因为这类文本的特征与多数训练数据保持一致;同时表明,这些偏好可以通过操控与多数数据的一致性程度被植入或消除。
核心贡献
-
在合成传记数据上构建冲突知识学习的评估框架:通过构造模板填充的陈述对,并基于预训练 LLM 给出的相对概率定义成对偏好分数。
-
评估显示,预训练 LLM 从正式文本和拼写错误较少的文本中学习知识更快,为存在冲突的陈述分配更高概率,并且这种偏好在不同模型和语言中均出现,在更大的模型中效应更强。
-
分析指出,与多数训练数据的一致性驱动了这些偏好,并表明改变这种一致性可以植入新的学习偏好,也可以消除已有偏好。
引言
大语言模型的大部分知识来自大规模网络爬取预训练语料,但这些语料可能包含误导性或相互矛盾的事实。这很重要,因为它影响可靠知识如何被学习、保留和召回。人类在解决此类冲突时,通常会考虑来源质量和与其他信息的一致性。以往研究主要考察知识如何存储在模型参数中,或改写等格式如何改善知识获取,但对存在冲突事实时文本特征如何影响学习,仍缺乏深入认识。
作者利用合成传记数据,其中包含受控的冲突知识以及不同文本风格和拼写条件。他们发现,预训练 LLM 表现出学习偏好:更偏好以正式新闻或科学风格呈现、以及拼写错误较少文本中的事实,并为其分配更高概率。其主要贡献是提出一致性驱动的特征偏好假设,认为 LLM 从指示与其他数据一致性的特征中学习,并表明这些偏好可以被引入、抵消或逆转。
数据集
-
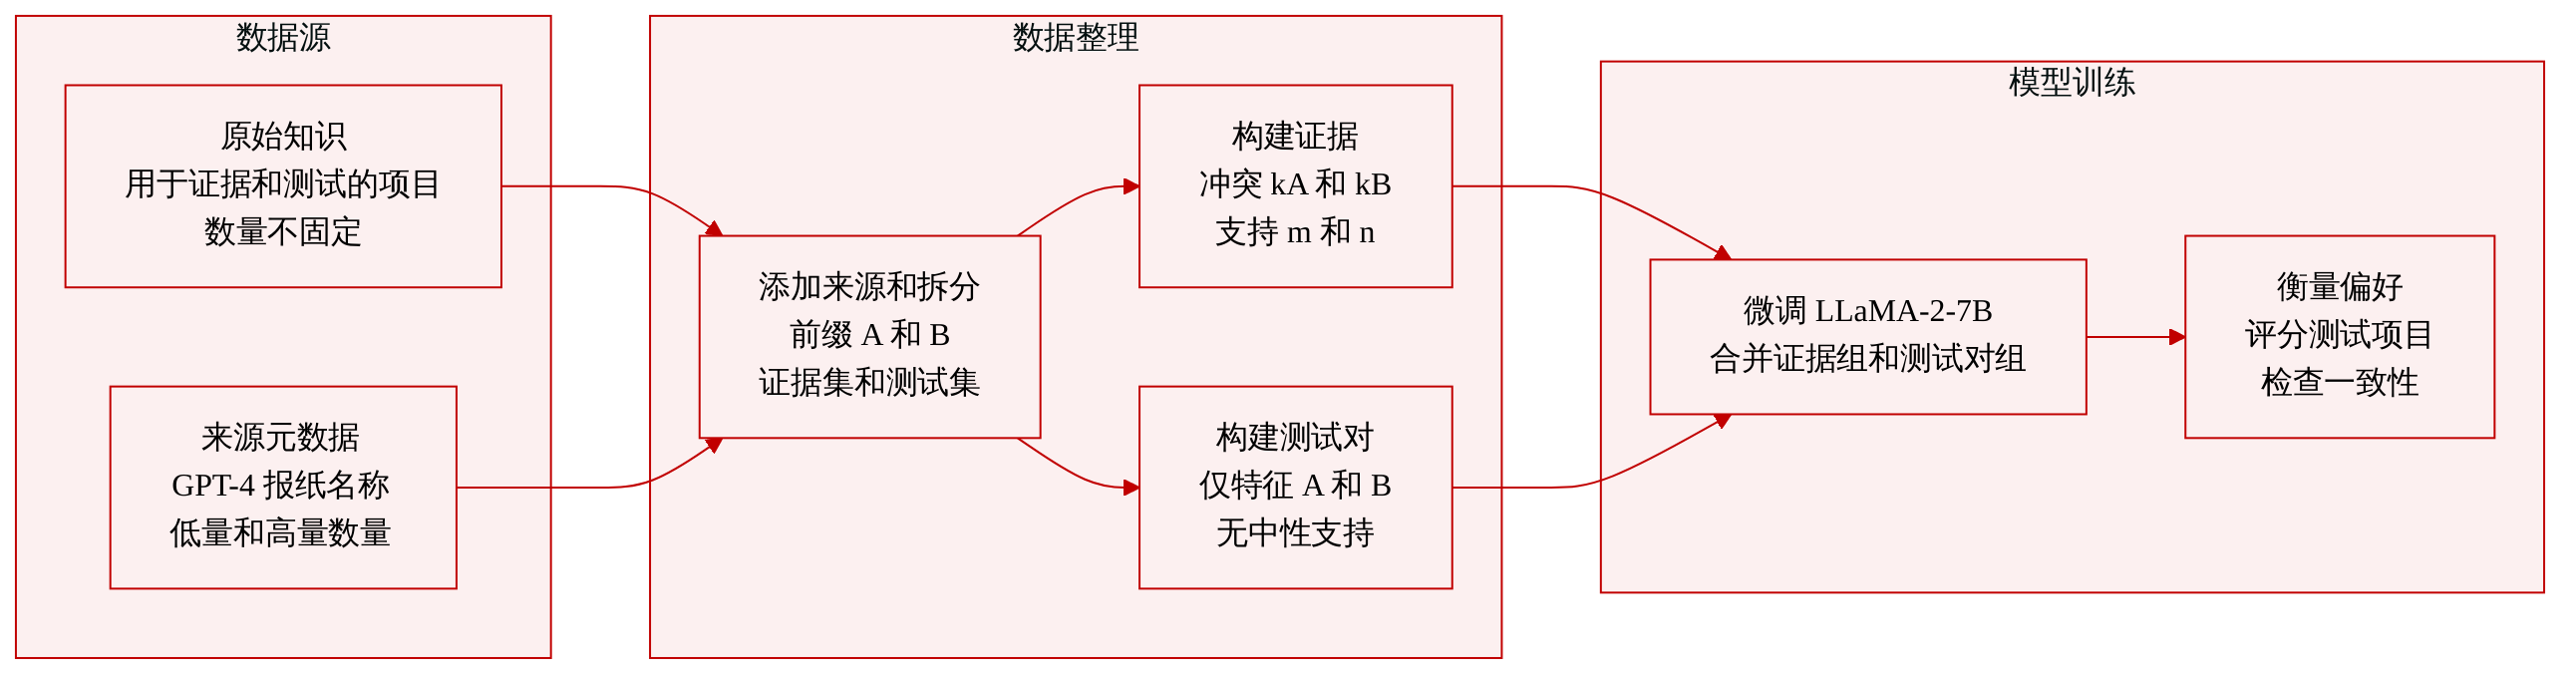
作者通过将伪造的来源信息附加到用于训练和测试 LLM 偏好行为的知识点上,构建合成偏好数据集。原始知识集被划分为证据知识集和测试知识集。证据集用于构造教授一致性模式的训练样本,而测试集则保留用于在推理时衡量偏好分数。
-
数据中注入了两类合成特征,作为来源元数据:
- 来源名称特征:每个样本都添加由 GPT-4 生成的合成报纸名称作为前缀。为特征 A 和特征 B 分别创建两个名称集,采用模板 “According to , T.”。
- 来源时间特征:所有样本使用同一来源名称 “Global News”,但包含卷号。特征 A 使用 1000 以下的随机卷号,特征 B 使用 1000 以上的随机卷号,采用模板 “According to Global News (Vol. ), T.”。这样模型便从数字关系中推断一致性,而不是从固定表面名称中推断。
-
证据子集使用存在冲突的知识对。对于每个证据条目 kA,作者生成一个冲突条目 kB,并创建一组 m+n+2 篇传记。该组包括一篇包含特征 A 和 kA 的示例、一篇包含特征 B 和 kB 的示例、m 篇支持 kA 的中性模板示例,以及 n 篇支持 kB 的中性模板示例。m 和 n 的值可调,使作者能够控制特征 A 与特征 B 之间的一致性比例。
-
测试子集对每个知识条目的结构更小。对于每个测试条目 kA,作者生成一个冲突条目 kB,只创建两条记录:一条包含特征 A,另一条包含特征 B。这些示例不包含中性模板支持记录。
-
在训练时,作者将所有证据子集传记组和所有测试子集配对组合并为 LLaMA-2-7B 的微调数据。论文未提供固定的数据集规模;规模取决于原始知识条目数量以及所选的 m 和 n 值。除这些合成前缀和基于模板的构造规则外,未描述外部语料、过滤规则、截断策略或详细元数据模式。
方法
作者将方法表述为一个数据驱动的探测框架,用于识别影响大语言模型知识学习的文本特征。作者假设,在训练期间,模型可以隐式地将与风格相关的线索,例如体裁、来源格式、拼写正确性或合成来源标识符,与其中知识可靠性关联起来。这一假设引出一项一致性驱动的偏好假设:如果两个特征分别附加到相互竞争的陈述上,模型应当更偏好其特征与其他数据更一致的那一陈述。
为了验证这一想法,作者设计了不太可能出现在原始预训练语料中的受控合成特征。系统引入两类特征族。第一类是来源名称特征,即在一条中性知识句子 T 前添加合成来源标记。其中一种形式使用生成的报纸名称:
T~=According to ⟨newspaper⟩, +T第二类是来源时间特征。它使用同一报纸名称,但变化一个 publication volume token,使模型从数字关系中推断一致性,而不是从固定表面字符串中推断。与特征 A 相关联的文本获得小于 1000 的卷号,与特征 B 相关联的文本获得大于 1000 的卷号:
T~=According to Global News (Vol. ⟨vol⟩), +T参考下方的因果图。
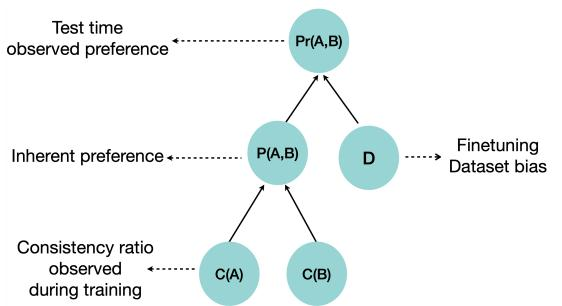
训练流程的核心是一致性比例控制管线。给定两个特征 A 和 B,作者将知识集划分为证据集和测试集。证据知识集 Ke 用于构造训练传记,向模型提供关于哪个特征与其他数据更一致的线索。测试知识集 Kt 保留用于推理,在训练期间不用于提供支持性证据。
对于 Ke 中的每个证据知识条目 kA,作者生成一个冲突条目 kB,然后构造一组传记,其中每个立场包含一篇特征条件化陈述,以及若干支持某一方或另一方的中性陈述:
Ie={T~A(kA),T~B(kB)}∪{Ti(kA)}i=1m∪{Tj(kB)}j=1n其中,T~A 和 T~B 分别是承载特征 A 和特征 B 的模板。项 {Ti(kA)}i=1m 和 {Tj(kB)}j=1n 是不承载实验特征的中性支持集。通过改变 m 和 n,作者操控证据的一致性比例,实际上改变了与 A 相关联的知识相对于与 B 相关联的知识,在其他训练示例中的一致出现频率。
对于每个测试条目,训练数据被简化为最小冲突对:
It={T~A(kA),T~B(kB)}完整微调语料库随后是所有证据传记与所有测试冲突对的并集:
D=kA∈Ke⋃Ie(kA)∪kA∈Kt⋃It(kA)作者在该构造语料上微调 LLaMA-2-7B。训练后,在测试知识集上评估,并计算观测偏好分数 Pr(A,B),用于指示模型倾向于采纳与特征 A 配对的知识,还是与特征 B 配对的竞争知识。这提供了偏好形成过程的可测量读数。
并行地,该方法还考虑无冲突设定,其中偏好通过收敛速度和训练准确率间接推断。当存在冲突时,同样的实验逻辑也适用于文本风格和拼写正确性等特征族。拼写正确的文本记为 TGoodSpelling,并将损坏变体与其比较,以检验正字法质量是否影响学习偏好。所有变体中的核心设计原则相同:控制附加到不同特征对上的一致性信号,在该受控条件下训练,然后量化推理时出现的偏好。
实验
实验评估语言模型是否会从风格、拼写、信息来源以及与其他数据的一致性等文本特征中形成微调偏好。学习速度和冲突知识测试表明,模型更偏好正式风格和拼写正确的文本,并且这种偏差随模型规模增大而增强,在英文和中文模型中均出现。后续的一致性、表征和反事实实验进一步表明,模型会识别与多数对齐知识相关联的特征,并且人工改变这种一致性可以消除或逆转其已学习的偏好。
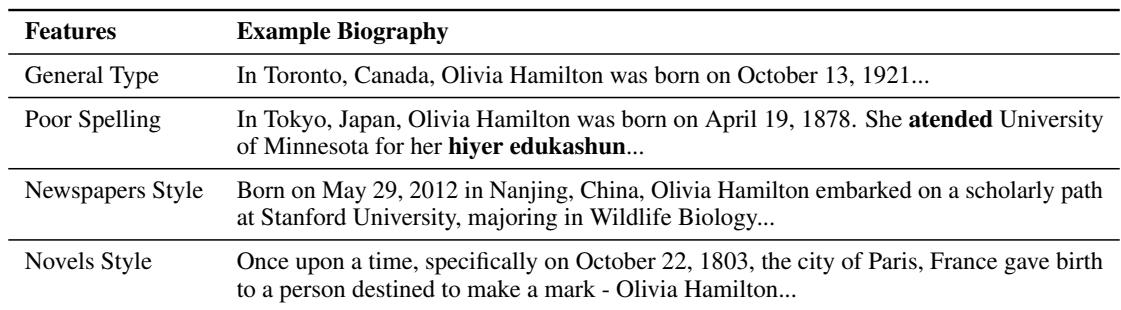
示例展示了使用不同文本特征写成的合成传记段落,包括一般形式、拼写较差形式、报纸风格形式和小说风格形式,所有描述均针对同一人物,但陈述相互矛盾。这些变体说明,在分析中可以将文本风格和拼写作为信息可信度的信号。上下文表明,报纸风格传记与比小说风格传记更强的已学习偏好相关联。传记示例在不同文本特征中编码了相同的人名和不同属性。拼写较差和叙事风格被视为可能影响模型偏好的可区分特征。在偏好分析中,报纸风格示例被视为比小说风格示例更可信。
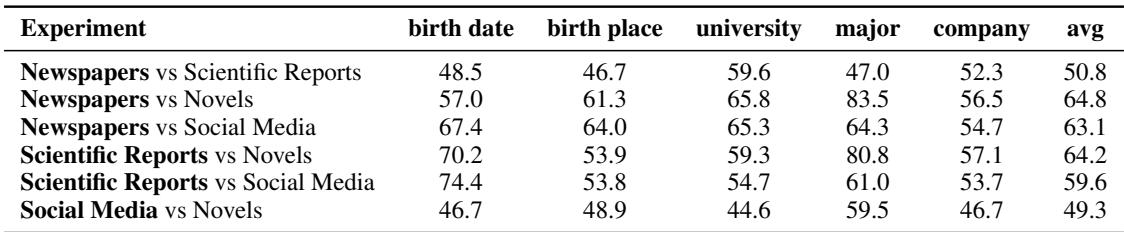
微调后的 LLaMA-2-7B 比较显示出对正式或标准文本特征的一致偏好,相对于较不正式的替代形式。报纸和科学报告通常比小说和社交媒体更受偏好,拼写良好比拼写较差更受偏好。相对分数因事实属性而异,但总体趋势表明,正式且拼写正确的来源会激发更强的知识激活。正式文本风格比小说和社交媒体获得更高偏好。在测试到的传记属性中,拼写良好比拼写较差更受偏好。
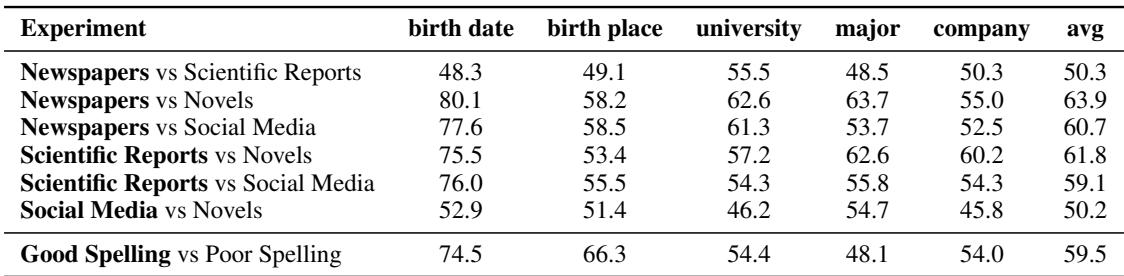
微调后的 LLaMA-2-7B 模型通常对正式写作风格表现出比非正式风格更强的成对偏好。在各类属性类别中,报纸和科学报告风格通常比小说和社交媒体风格获得更高分。两种正式风格之间的比较接近,社交媒体与小说之间的比较也接近,这表明最清晰的偏好差距是正式文本与非正式文本之间的差距。正式风格比小说和社交媒体获得更高的成对偏好,报纸和科学报告风格彼此之间近乎平衡。
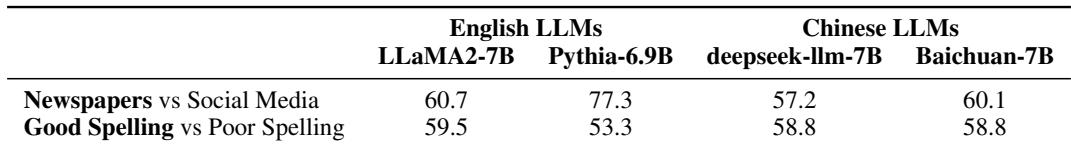
在英文和中文大语言模型中,报纸风格始终比社交媒体风格更受偏好,拼写良好通常比拼写较差更受偏好。这种偏好并非对每个模型都同样强,在受测模型中 Pythia 表现出最强的报纸风格偏好。这一模式表明存在广泛共享的学习偏好,而强度差异可能反映模型特有的训练数据和训练方法。在英文和中文模型中,报纸风格比社交媒体风格更受偏好。在受测模型中,拼写良好比拼写较差更受偏好。与其他模型相比,Pythia 表现出最强的报纸风格偏好。
实验使用合成传记段落,其中同一人物以不同文本风格和拼写条件编码相互矛盾的事实,以检查这些特征如何充当可信度信号。在与微调后的 LLaMA-2-7B 以及多个英文和中文模型的比较中,正式风格如报纸和科学报告通常比非正式风格如小说和社交媒体更受偏好,拼写正确的文本比拼写较差的文本更受偏好。正式文本与非正式文本之间的偏好最强,而具体比较和模型行为存在变化,表明这是一种广泛共享但依赖模型的学习偏好。