Command Palette
Search for a command to run...
面向大语言模型的预训练数据检测:一种基于散度的校准方法
面向大语言模型的预训练数据检测:一种基于散度的校准方法
Weichao Zhang Ruqing Zhang Jiafeng Guo Maarten de Rijke Yixing Fan Xueqi Cheng
摘要
随着大语言模型(LLM)训练语料库规模的不断增长,模型开发者越来越不愿公开其训练数据的细节。这种透明度的缺失给科学评估和伦理部署带来了挑战。近期,预训练数据检测方法——即通过黑盒访问推断给定文本是否属于某个 LLM 的训练数据——已被初步探索。Min-K% Prob 方法取得了当前最优的效果,其假设是非训练样本通常包含若干具有低 token 概率的离群词。然而,该方法的有效性可能受到限制,因为它倾向于将包含大量高概率常见词的未训练文本错误分类。为解决这一问题,我们受偏离随机性(divergence-from-randomness)概念的启发,提出了一种基于散度的校准方法,用于校准 token 概率以实现预训练数据检测。我们计算 token 概率分布与 token 频率分布之间的交叉熵(即散度)以得到检测分数。此外,我们构建了一个中文基准 Patent-MIA,用于评估 LLM 检测中文文本的性能。在英文基准和 PatentMIA 上的实验结果表明,所提方法显著优于现有方法。我们的代码和 PatentMIA 基准已开源至 https://github.com/zhang-wei-chao/DC-PDD 。
一句话总结
来自 ICT、CAS、UCAS、Zhongguancun Laboratory 和 University of Amsterdam 的研究人员提出了一种基于散度的校准方法,该方法计算 token 概率分布与 token 频率分布之间的交叉熵,以纠正 Min-K% Prob 对包含许多常见高概率 token 的非训练文本的误分类,并在英文和中文预训练数据检测基准上均取得显著提升。
核心贡献
-
提出 DC-PDD,一种面向黑盒预训练数据检测的基于散度的校准方法,该方法计算 token 概率分布与 token 频率分布之间的交叉熵,以产生更可靠的成员身份分数。
-
提出 Patent-MIA,一种中文基准,用于评估文本是否被包含在大语言模型预训练数据中,将预训练数据检测评估扩展到常用英文基准之外。
-
在英文基准和 Patent-MIA 上的实验结果表明,DC-PDD 显著优于现有基线,同时只需要 token 概率访问,不需要额外参考模型或完整词表概率分布。
引言
大语言模型依赖大规模预训练语料库,但许多开发者并不披露所使用的数据。这种透明度缺口对版权、隐私、伦理合规和数据污染检查都很重要,因为很难判断模型是记住了测试内容,还是在特定文本上训练过。以往的黑盒预训练数据检测方法通常使用 token 概率,并假设较低概率表示非训练数据。这些方法会受到常见词偏差影响:高频 token 可能获得更高概率,导致非训练文本被误分类为训练文本。一些相关方法还需要参考模型或完整词表访问,这在闭源商用 LLM 上可能不可用。作者利用“偏离随机性”的思想提出 DC-PDD,这是一种校准方法,将模型的 token 概率分布与从公开参考语料库估计得到的 token 频率分布进行比较。与一般语料库频率差异较大的 token 被认为对成员身份推断更具信息量。作者还提出 PatentMIA,一种用于预训练数据检测的中文基准,并表明 DC-PDD 优于以往的黑盒方法。
数据集
-
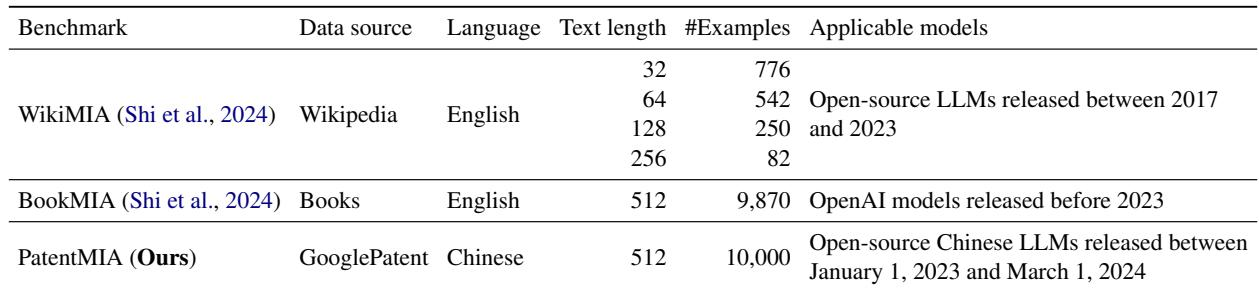
论文使用 LLM 预训练数据检测基准,其目标是识别文本示例是否可能属于 LLM 的预训练语料库。
-
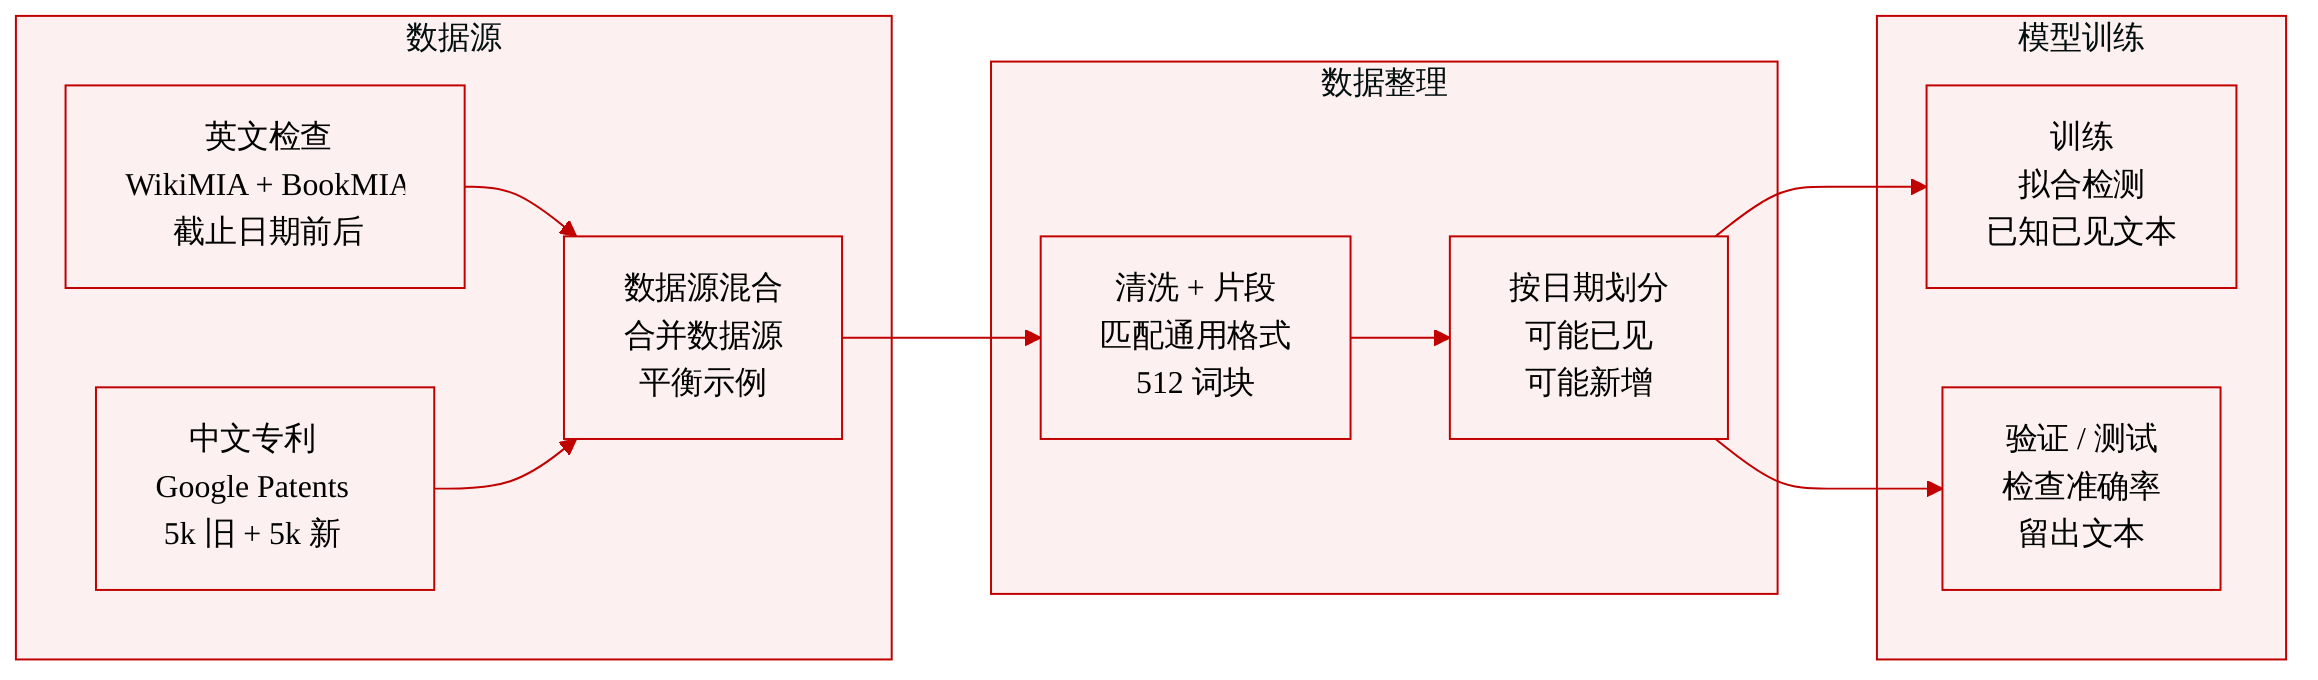
作者使用两个已有的英文基准 WikiMIA 和 BookMIA,它们通过目标 LLM 的知识截止期限将训练示例与非训练示例分开。训练示例来自截止时间之前,而非训练示例来自截止时间之后。
-
作者还提出名为 PatentMIA 的新中文基准,以在格式和空格特征与英文不同的语言上评估检测方法。
-
PatentMIA 基于 Google Patents 中文专利文本构建。作者随机抓取 5,000 个公开日期在 2023 年 1 月 1 日之前的中文专利页面,以及 5,000 个优先权日期在 2024 年 3 月 1 日之后的页面。
-
基于日期的划分被用作成员身份的代理:较早公开的页面被认为更可能在预训练期间对 LLM 可用,而较晚优先权日期的页面被认为不存在。
-
抓取的专利页面经过清洗和处理,步骤与 ChineseWebText 所用步骤类似,使基准格式匹配常见 LLM 预训练数据格式。
-
对于每个专利页面,作者使用 jieba 对中文文本分词后,随机抽取一个 512 词片段。
-
生成的 PatentMIA 基准包含 10,000 个平衡示例,每个日期类别各 5,000 个示例。
-
作者使用 WikiMIA、BookMIA 和 PatentMIA 作为评估基准,以衡量方法检测文本是否被包含在 LLM 预训练数据中的有效性。
方法
通过分布散度进行预训练数据检测
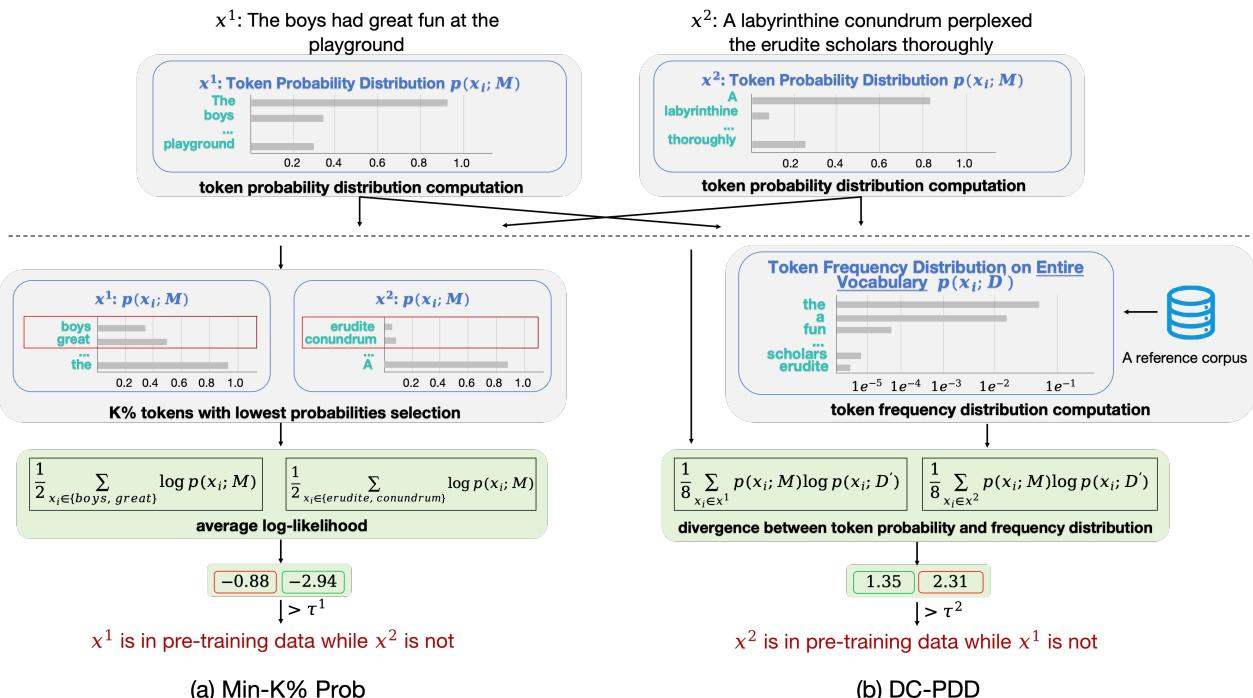
作者提出一种免训练预训练数据检测方法,将目标大语言模型视为可查询的概率预言机。该方法不训练分类器,也不提取隐藏状态,而是比较语言模型对候选文本中每个 token 的偏好强度与该 token 在参考语料库中出现的频率。核心假设是:如果一个 token 在目标模型下具有较高概率,但在外部参考语料库中并不常见,那么模型可能在预训练期间遇到过该 token 序列。最终检测分数由这种不匹配派生得到,整体流程可以理解为四阶段比较过程。
给定输入文本 x=x1x2…xn,其中每个 xi 是来自 tokenizer 的 token,该方法首先计算目标语言模型 M 诱导的 token 级概率分布。由于下一 token 预测模型在缺少前文上下文时不会给第一个 token 分配概率,作者在序列前添加一个句首 token x0,以形成
x′=x0x1x2…xn.然后,扩展序列 x′ 被输入目标模型。模型产生与 x 中实际 token 对应的预测概率序列:
{p(xi∣x<i;M):0<i≤n}.这里,每个 token 概率都以先前的 token x<i 为条件,即模型评估在给定前文上下文时 token xi 的可能性。为简单起见,该条件概率后来写作 p(xi;M)。
由于目标模型的真实预训练语料库被认为不可用,该方法不能直接测量每个 token 在模型训练数据中出现的频率。为了近似该分布,作者使用大规模公开可用参考语料库 D′ 估计 token 频率。原始基于频率的估计为
p(xi;D′)=N′count(xi),其中 count(xi) 是 token xi 在 D′ 中出现的次数,N′ 是参考语料库中的 token 总数。由于罕见 token 或参考语料库之外的 token 可能从未出现在 D′ 中,该方法应用 Laplace 平滑以避免零概率:
p(xi;D′)=N′+∣V∣count(xi)+1,其中 ∣V∣ 表示目标模型的词表大小。该平滑后的频率分布用作比较模型内部 token 概率的基线。
然后逐 token 计算检测信号。对于每个 token xi,该方法构造一个散度风格的分数
αi=−p(xi;M)⋅logp(xi;D′).直觉上,当目标模型对参考语料库中相对罕见的 token 赋予高概率时,会产生较大的 αi。这种不匹配可能表明模型记住了与该 token 序列相关的模式,而不只是对普通语言统计规律进行建模。
为了防止少量极端 token 分数主导最终结果,作者在每个单 token 分数上引入上限 a:
αi={αi,a,if αi<a,if αi≥a.该截断步骤稳定了最终聚合结果,并降低了检测器对少数异常高概率、低频 token 的敏感度。
该方法还解决了与重复相关的伪影。当某个词或 token 在同一文本中出现多次时,语言模型通常会给后续出现分配更高概率,因为该 token 已经出现在上下文中。这可能会抬高后续 token 的分数,但并不必然提供更强预训练暴露证据。为了降低该效应,最终分数仅针对文本中每个不同 token 的首次出现计算。令 FOS(x) 表示在 x 中首次出现的 token 集合。最终序列级分数为
β=∣FOS(x)∣1xj∈FOS(x)∑αj.该平均过程对首次出现 token 的数量进行归一化,并生成模型相对于参考语料库对候选文本偏好的紧凑校准。
最终预测通过将 β 与预定义阈值 τ 进行比较得到的二元决策:
Decision(x,M)={0,1,if β<τ,if β≥τ.高于阈值的分数表示候选文本被预测为已包含在模型的预训练语料库中,而低于阈值的分数表示被预测为未包含。因此,整体方法通过一个清晰的比较循环运行:查询目标模型的 token 概率,从参考语料库估计外部 token 频率,推导每个 token 的散度分数,聚合稳健的首次出现证据,并对结果分数进行阈值判定以完成检测。
实验
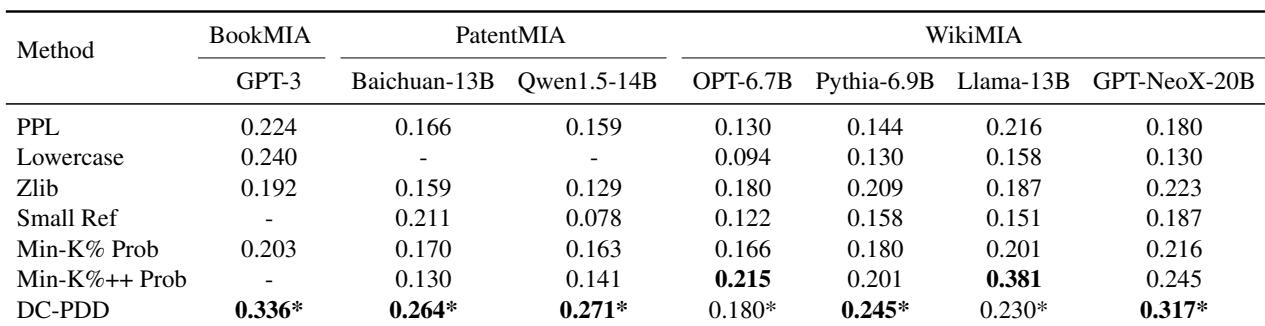
实验在英文基准 WikiMIA 和 BookMIA 以及新构建的中文 PatentMIA 基准上评估预训练数据检测,覆盖开放模型和 GPT-3,并与标准评分基线进行比较。DC-PDD 通常取得最强检测性能,并在不同模型和语言上表现出更一致的鲁棒性,尽管在规模有限的 WikiMIA 设置上优势较小。消融和敏感性分析表明,概率校准和首次出现加权可改善检测,而更大的模型、更长的文本、多样的参考语料库以及经过适当调优的概率上限可进一步提升可靠性。
这些基准区分预训练数据检测的训练示例和非训练示例,其中 WikiMIA 和 BookMIA 覆盖英文 Wikipedia 和书籍文本,PatentMIA 加入中文专利文本。PatentMIA 使用专利优先权日期来识别不太可能存在于模型预训练语料库中的文本,从而将检测评估扩展到英文之外。中文文本实验表明,较长示例更容易与非训练示例区分。PatentMIA 将预训练数据检测基准从仅限英文的设置扩展到中文专利数据。较长的中文示例更容易与非训练示例区分。WikiMIA 使用 Wikipedia 文本,BookMIA 使用书籍文本,PatentMIA 使用 Google Patents 文本。
DC-PDD 在大多数基准和目标模型组合上取得最佳检测 AUC,相对 Min-K% Prob 基线具有统计显著改进。它在中文预训练数据上尤其有用,因为基于小写化的检测并不适合,而且若干基线受到模型访问限制。在非常小的基准上,相对增益可能更小,这表明基准规模和 token 概率行为会影响比较。DC-PDD 在大多数模型和基准设置中排名第一,相对 Min-K% Prob 具有统计显著 AUC 提升,在无法使用基于小写化检测的中文数据上表现强劲,小基准上的有限增益表明其对样本规模敏感。
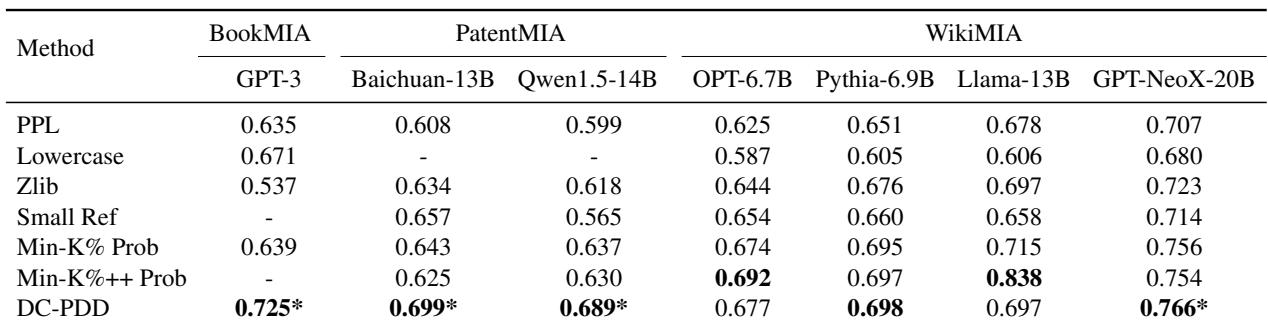
该表格比较低假阳性率下的预训练文本检测,各基线在不同基准和目标模型上表现不均。所报告结果表明,DC-PDD 总体最强,并相对 Min-K% Prob 显著改进。一些基线受到模型访问、文本语言或基准规模限制,这解释了偶发的例外情况。检测性能因基准和目标模型而异,并未遵循单一基线排序。DC-PDD 被报告为总体最佳方法,且显著优于 Min-K% Prob。基于小写化和基于参考的基线在中文文本或闭源模型上显示适用性限制。
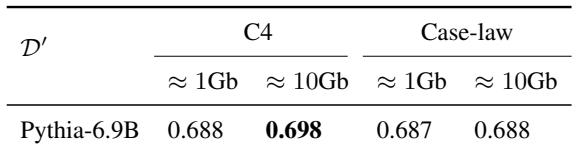
在涵盖通用 C4 和法律 Case-law 两种规模的参考语料库选项中,DC-PDD 的 AUC 性能几乎保持稳定,表明其对语料库选择敏感度有限。较大规模的更广泛 C4 设置给出最强结果,这与更准确的 token 频率估计一致。参考语料库领域和规模仅产生很小的 AUC 差异。在测试设置中,更大的 C4 给出最佳性能。
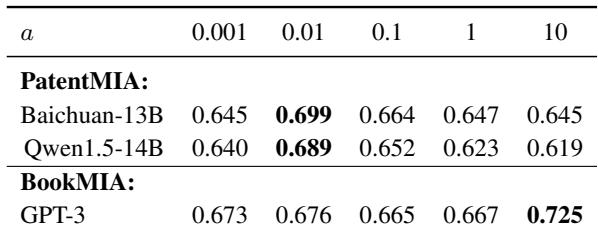
该表格报告 DC-PDD 在两个 PatentMIA 目标模型和一个 BookMIA 目标模型上针对超参数 a 的五个设置所得到的 AUC 分数。随着 a 变化,检测性能有明显变化,选择不当会削弱训练文本与非训练文本之间的分离。0.01 在所有评估模型上均给出强结果,推荐用于实际预训练数据检测。Baichuan-13B 和 Qwen1.5-14B 的 PatentMIA AUC 分数在 a 为 0.01 时达到峰值。GPT-3 在 BookMIA 上的性能在 a 为 10 时最高,说明最佳设置可能取决于目标模型和基准。总体来看,0.01 这一低设置在所有评估模型上提供最为均衡的 AUC 性能。
实验在 WikiMIA、BookMIA 和 PatentMIA 上评估预训练数据检测,这些基准覆盖英文 Wikipedia、书籍和中文专利文本,并区分训练示例与非训练示例。主要结果显示,DC-PDD 总体最有效,尤其在中文数据上,因为小写化或基于参考的基线不太适用,尽管非常小的基准会使增益不那么明显,并且较长的中文示例更容易被检测。进一步研究表明,DC-PDD 在不同参考语料库上保持稳定,并在较小的超参数设置下表现最佳,支持其在模型和语料库选择上的鲁棒性。