Command Palette
Search for a command to run...
When Is Multilinguality a Curse? Language Modeling for 250 Highand Low-Resource Languages
When Is Multilinguality a Curse? Language Modeling for 250 Highand Low-Resource Languages
Tyler A. Chang Catherine Arnett Zhuowen Tu Benjamin K. Bergen
摘要
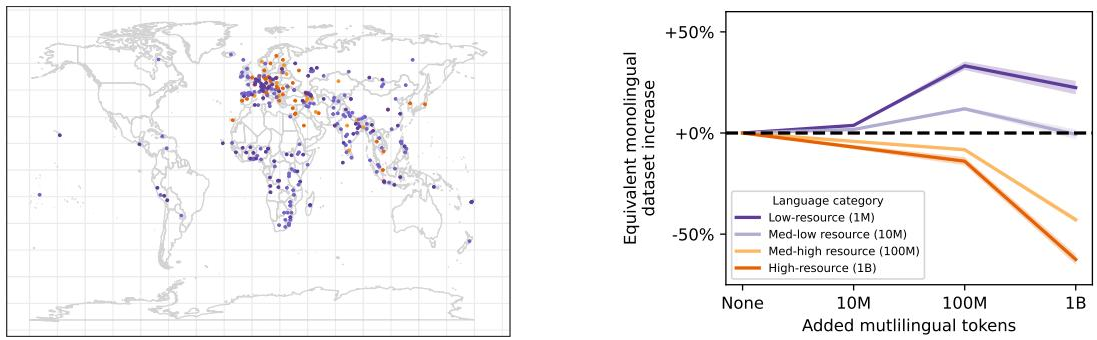
Multilingual language models are widely used to extend NLP systems to low-resource languages. However, concrete evidence for the effects of multilinguality on language modeling performance in individual languages remains scarce. Here, we pre-train over 10,000 monolingual and multilingual language models for over 250 languages, including multiple language families that are under-studied in NLP. We assess how language modeling performance in each language varies as a function of (1) monolingual dataset size, (2) added multilingual dataset size, (3) linguistic similarity of the added languages, and (4) model size (up to 45M parameters). We find that in moderation, adding multilingual data improves low-resource language modeling performance, similar to increasing low-resource dataset sizes by up to 33%. Improvements depend on the syntactic similarity of the added multilingual data, with marginal additional effects of vocabulary overlap. However, high-resource languages consistently perform worse in multilingual pre-training scenarios. As dataset sizes increase, adding multilingual data begins to hurt performance for both low-resource and high resource languages, likely due to limited model capacity (the "curse of multilinguality"). These results suggest that massively multilingual pre-training may not be optimal for any languages involved, but that more targeted models can significantly improve performance.
一句话总结
加州大学圣地亚哥分校在 250 种语言上预训练了超过 10,000 个语言模型,发现适度的多语言数据可将低资源语言建模效果最多提升 33%,具体效果取决于句法相似度;而大规模多语言预训练由于多语言诅咒,会损害低资源和高资源语言的性能,这表明针对性模型可能优于大规模多语言模型。
核心贡献
-
本文贡献了一项大规模受控研究,针对 252 种语言预训练了超过 10,000 个单语和多语言语言模型,并评估性能随目标语言数据规模、新增多语言数据规模、语言相似度和模型规模(最大 45M 参数)的变化情况。
-
该研究表明,适度的多语言数据可以改进低资源语言建模,收益相当于最多将目标语言数据集扩大 33%;研究还发现句法相似度是这些收益的主要驱动因素,词表重叠只有边际影响。
-
本文表明,多语言预训练会持续降低高资源语言的性能,在某些情况下相当于目标数据集减少超过 85%;该退化与多语言诅咒有关,这表明在语言建模中,针对性多语言模型可能优于广泛多语言模型。
引言
多语言语言模型是现代 NLP 的核心,尤其适用于低资源语言、跨语言迁移和多语言生成。它们通常只在固定的大量语言集合上进行一次预训练,但固定配方可能偏向高资源语言,也无法揭示预训练选择如何单独影响每种语言。已有工作关于多语言训练是帮助还是损害语言的证据并不一致,而且许多研究依赖已经训练好的模型或下游任务,因此难以分离语言选择、数据量、相似度和模型规模的影响。
作者通过针对 252 种语言预训练超过 1,900 个单语模型,并预训练超过 8,400 个多语言模型来应对这一问题。他们系统性地变化单语数据集规模、多语言数据集规模、新增语言的语言相似度,以及最大 45M 参数的模型规模。其主要贡献是给出多语言预训练何时帮助或损害原始语言建模的量化图谱。他们发现,适度的相似多语言数据可以提升低资源语言的性能,但多语言数据通常会损害高资源语言的性能,尤其是在模型容量成为瓶颈时。
数据集
-
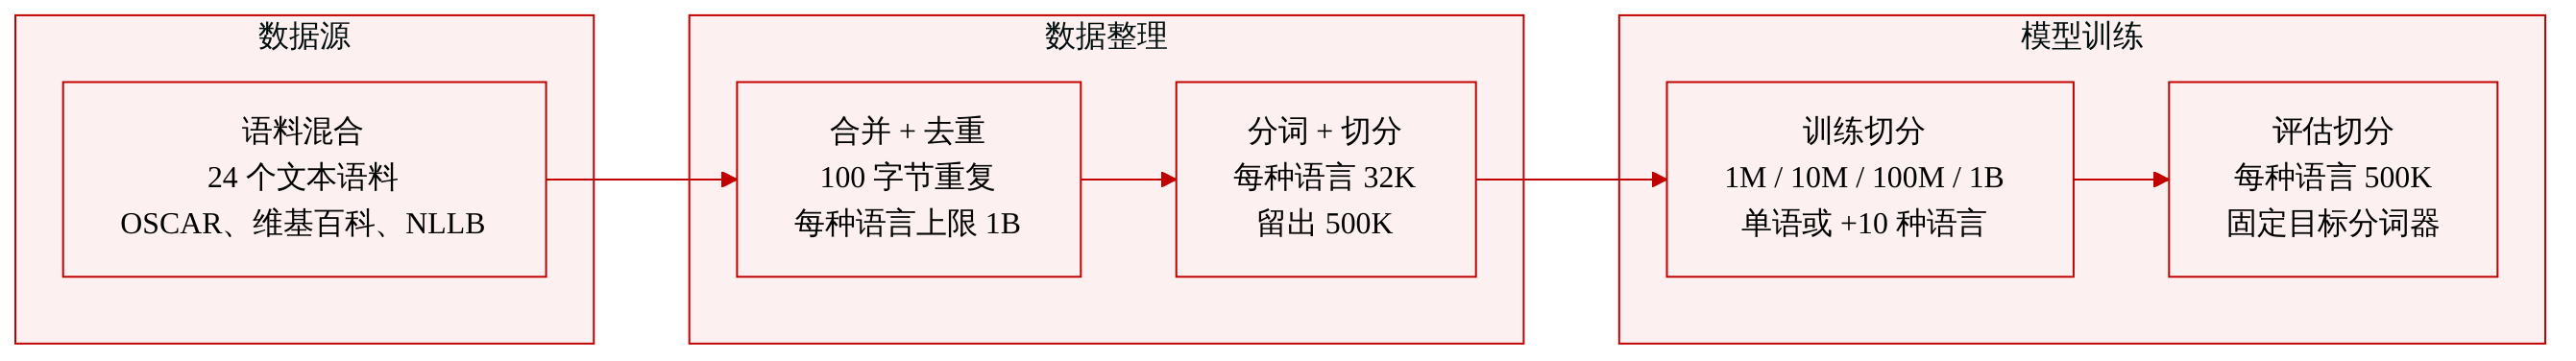
作者从 24 个来源构建了大规模多语言文本语料,包括 OSCAR、Wikipedia 和 NLLB。他们按语言合并语料库,并对长度为 100 个 UTF-8 字节的重复序列进行去重。
-
最终语料在 1572 种语言中包含 41.4B tokens,每种语言最多限制为 1B tokens。对于语言建模实验,他们保留了至少拥有 1.5M tokens 的 252 种语言。这些语言覆盖五大洲、29 个语系和 30 种文字。
-
他们为每种语言构建了元数据,包括 token 数量和来自 Glottolog 的地理坐标。附录章节列出了完整的语言列表、token 数量和资源类别。
-
数据集子集按每个语言的 token 预算定义:1M、10M、100M 和 1B tokens。它们分别对应低资源、中低资源、中高资源和高资源设置。每个语言集合还会排除 500K tokens 用于评估。
-
在 252 种被分析的语言中,252 种至少达到低资源规模,167 种达到中低资源规模,48 种达到中高资源规模,28 种达到高资源规模。
-
对于每种语言,作者训练了最大词表为 32K 的 SentencePiece 分词器。分词器训练使用每种语言随机抽取的 10K 行文本,并统一采用该截断阈值以控制跨语言的分词质量。
-
在单语实验中,作者在指定的数据规模下,在每种语言的子集上预训练模型,并使用固定的语言专属分词器。
-
在多语言实验中,每个模型有一个目标语言,并保持该语言的单语分词器固定。目标语言数据与来自另外 10 种语言的附加多语言数据随机混合。
-
新增的多语言数据总量为 10M、100M 或 1B tokens,并且来自 10 种新增语言的 token 数量相等。新增语言选自至少拥有 100M tokens 的 48 种中高资源语言。
-
对于多语言模型,10 种新增语言共享一个单独的 32K 多语言分词器,该分词器使用每种新增语言随机抽取的 10K 行文本训练。目标语言数据和新增语言数据分别分词,然后在重叠词表项中合并 token IDs,同时保留目标语言分词器。
方法
作者构建了一个测量框架,先建立单语缩放基线,再使用这些基线解释多语言预训练带来的收益。对于每个目标语言,他们在三种容量下预训练自回归 Transformer 语言模型,对应 tiny、mini 和 small 模型规模。每种语言都使用固定 SentencePiece 分词器,词表约为 32K tokens。在数据可用时,训练会在多个单语数据规模上进行,评估数据则从相应的训练数据中留出。这些单语模型为后续与多语言模型的比较提供了校准点。
方法的核心组件是将原始评估对数似然转换为可解释的单语数据等效量估计。作者观察到,相对对数似然与单语数据集规模之间遵循幂律关系。他们拟合如下形式的函数:
ℓ=−ax−b+c,其中 ℓ 表示相对评估对数似然,x 表示以 log tokens 表示的单语数据规模。对于拥有许多数据点的语言,曲线可以直接根据多个训练数据规模下的性能来拟合。对于低资源语言,可用数据点过于稀疏,无法可靠拟合所有参数,因此其中一个系数根据拟合更好的语言的中位数值固定,其余参数则根据可用测量结果估计。
下图显示了所得到的拟合曲线和各语言专属曲线。
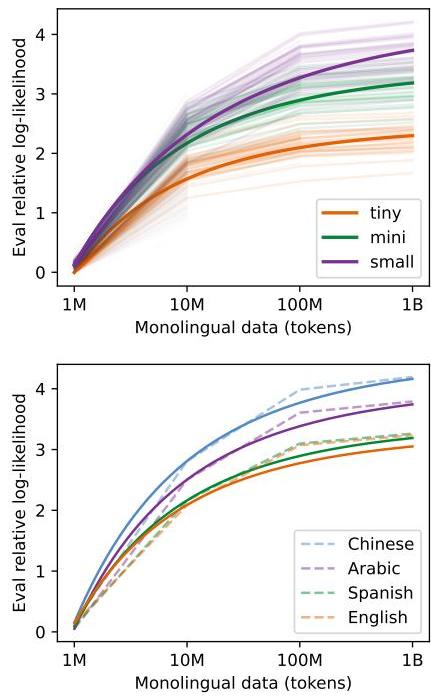
这些曲线使作者能够反推已测得的多语言模型对数似然,并估计达到同等性能水平所需的单语 token 数量。即使绝对 token 估计并不完美,该映射相对于对数似然仍保持单调,因此模型的相对排序得以保留。
多语言预训练设计围绕一个目标语言和一个受控的新增语言集合构建。对于每个目标语言,模型在预训练和评估过程中都保留该语言的单语分词器。这一点至关重要,因为只有在同一语言内且使用相同分词器时,困惑度和对数似然才具有可比性。为了避免混合多种语言时词表过大,新增语言共享一个具有 32K 词表的单独多语言分词器。目标语言的分词方式被保留,而新增语言中重叠词表项的 token IDs 会被合并到共享词表中。这使目标语言评估空间在不同多语言条件下保持稳定。
多语言数据以受控数量引入,并可以在多个维度上变化。对于给定目标语言,作者变化单语目标语言数据量、新增多语言数据量、新增语言的语言相似度和模型规模。新增的多语言 token 在训练过程中与单语目标语言 token 随机交错。新增语言根据与目标语言的相似度选择,相似度使用归一化句法相似度、地理接近度和词汇相似度衡量。三个归一化相似度分数会取平均,得到综合语言相似度分数,从而可以比较使用最相似或最不相似的附加语言训练的模型。
该架构和训练流程在保持目标语言评估接口稳定的同时,在单语与多语言方案之间建立了成对比较。通过控制分词方式、数据数量、语言相似度和模型规模,该方法能够隔离跨语言数据对目标语言性能的影响,并将这些影响转换为单语数据等效量的估计。
实验
实验为 252 种语言建立单语基线,并将相对似然转换为估计的单语 token 数量,以比较多语言模型。结果表明,添加多语言数据可以使低资源语言受益,尤其是在新增语言在句法上相似且多语言数据量适中的情况下;当数据量或模型容量不足时,收益会变小甚至为负。相比之下,高资源语言在多语言预训练中始终受到损害,这种退化只有在更大模型规模下才有所缓解。总体而言,多语言性主要适用于模型足够大的低资源场景,而有针对性的单语训练仍然更适合高资源语言。