Command Palette
Search for a command to run...
通过大语言模型与符号定理证明验证和精化自然语言解释
通过大语言模型与符号定理证明验证和精化自然语言解释
Xin Quan Marco Valentino Louise A. Dennis André Freitas
摘要
自然语言解释是评估基于解释的多步自然语言推理(NLI)模型的一种代理指标。然而,评估 NLI 解释的有效性具有挑战性,因为这通常涉及通过众包收集相应的数据集,该过程耗时且容易出现逻辑错误。为解决现有局限,本文研究通过整合大语言模型(LLM)与定理证明器(TP)来验证和精化自然语言解释。具体而言,我们提出了一个名为 Explanation-Refiner 的神经-符号框架,该框架将 TP 与 LLM 集成,用于生成和形式化解释性句子,并为 NLI 提供潜在的推理策略建议。进而,TP 被用于为解释的逻辑有效性提供形式化保证,并生成反馈以用于后续改进。我们展示了 Explanation-Refiner 如何被联合用于评估最先进 LLM 的解释推理、自动形式化和纠错机制,以及如何自动提升不同领域中不同复杂度解释的质量。
一句话总结
曼彻斯特大学、Idiap 研究所及合作机构的研究人员提出 Explanation-Refiner,这是一个神经-符号框架,将大语言模型与定理证明器相结合,对 NLI 的自然语言解释进行验证和精炼,为逻辑有效性提供形式化保证,并通过迭代反馈提升不同领域的解释质量。
核心贡献
-
Explanation-Refiner 是一个神经-符号框架,将大语言模型与定理证明器相结合,为自然语言推理生成、形式化并迭代精炼自然语言解释,同时检查其逻辑有效性。
-
自动形式化与错误纠正机制使用新戴维森事件语义学,在翻译为逻辑形式时保留句子级语义内容,并使用定理证明器反馈来识别并纠正错误推理步骤。
-
在文本蕴含和多项选择题问答任务上的实验表明,不同解释复杂度下人工标注解释的逻辑有效性得到提升,支持对解释性推理进行自动化增强。
引言
自然语言推理模型越来越多地生成解释,以使其推理更透明,而这些解释可以作为模型是否捕捉到所需逻辑步骤的证据。然而,先前的评估受到限制,因为语言生成指标需要昂贵且易出错的众包解释语料,而且这些指标经常遗漏逻辑有效性、忠实性和稳健性等细粒度属性。人工标注解释也往往不完整或包含逻辑错误,这会导致评估偏差。
作者提出 Explanation-Refiner,一个结合大语言模型与定理证明器的神经-符号框架,用于验证和精炼自然语言解释。他们使用 LLM 生成并自动形式化解释句子,使用新戴维森事件语义学与一阶逻辑减少语义损失,并使用 Isabelle/HOL 检查演绎有效性并提供反馈。在实验中,该方法提升了解释的逻辑有效性,并减少自动形式化导致的语法错误,揭示当前 LLM 在可验证推理方面的潜力与局限。
数据集
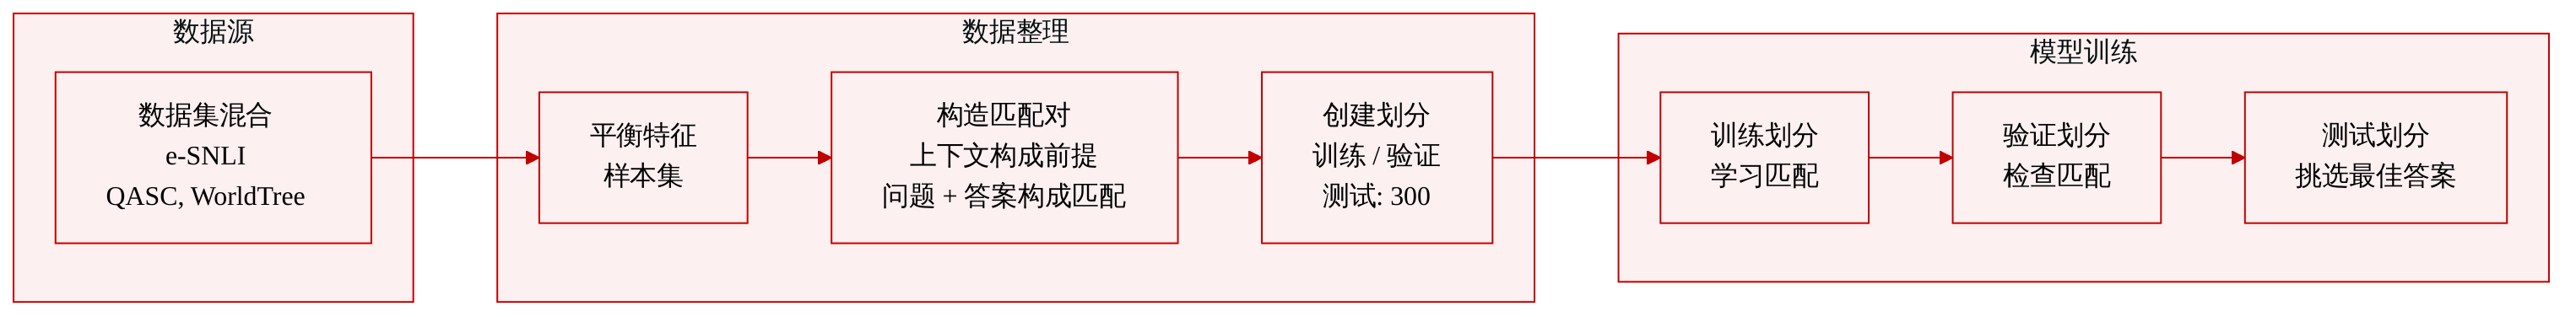
-
作者使用三个 NLI 数据集进行评测:e-SNLI、QASC 和 WorldTree。
-
评测集总共包含 300 个样本,使用 Valentino 等人(2021)提出的采样策略选取,该策略旨在最大化数据集在句法和语义特征上的代表性和互斥性。
-
论文将多项选择题问答转化为 NLI 设定。每个任务实例包含一个问题 q 和一组候选答案 C = {c1, c2, ..., cn},其中一个候选答案是正确答案。
-
为了将多项选择题转换为 NLI 示例,问题与正确候选答案被组合为一个假设 h_i。
-
如果问题包含上下文,作者使用该上下文构造 NLI 公式化中的前提 p_i。
方法
作者提出 Explanation-Refiner,一个神经-符号框架,用于验证 NLI 任务的解释句子是否逻辑有效,并在无效时迭代修复错误。该方法将自然语言解释视为候选逻辑证据,然后使用定理证明器作为外部验证器。给定前提 pi、假设 hi 和解释 Ei,系统提示 LLM 执行自动形式化,将每个解释事实 f∈Ei 转换为公理 ai。公理构成集合 A={a1,a2,…,an}。随后系统要求定理证明器证明如下形式的目标
pi∧B→hi,其中 B⊆A 包含蕴含所需的公理。参见框架图。
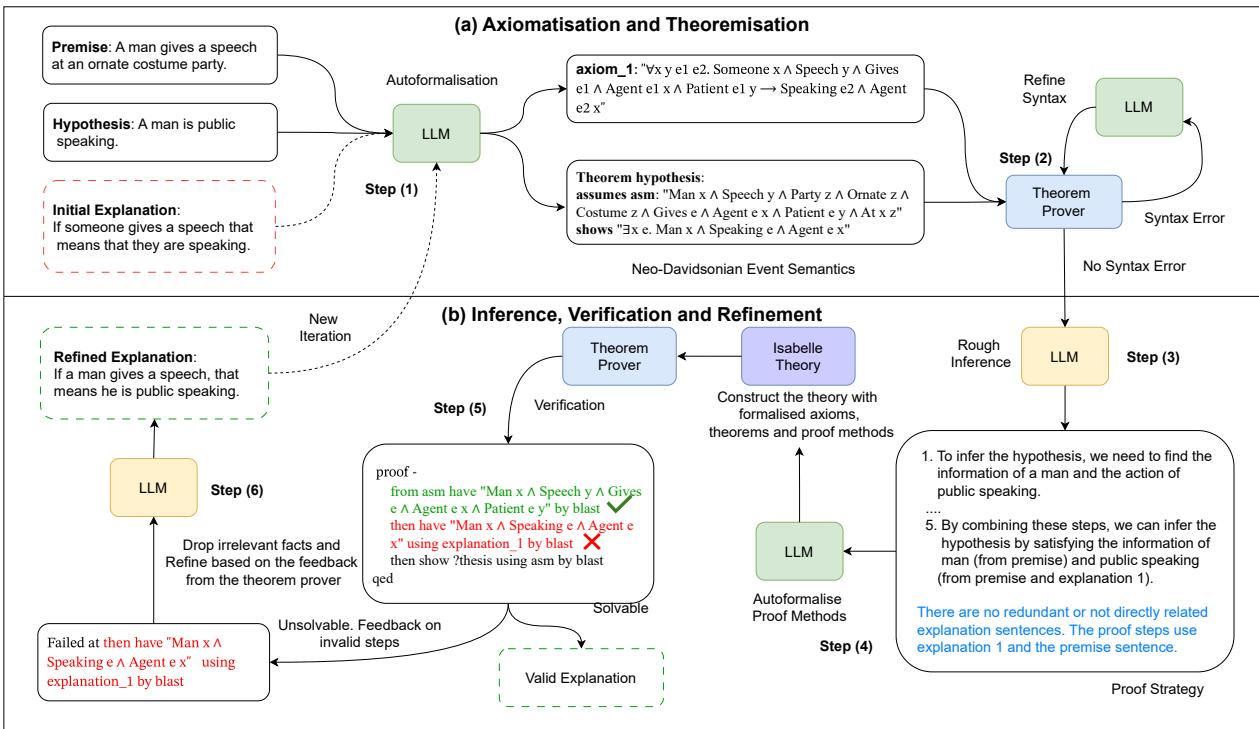
该流水线围绕三个主要模块组织:自动形式化、证明构造,以及验证与精炼。在第一阶段,LLM 将前提、假设和解释翻译为 Isabelle/HOL 理论。解释句子变为公理,前提变为假定已知命题,假设变为待证明定理。这将自然语言推理任务转换为可以机械检查逻辑有效性的形式演绎设定。
为保留复杂自然语言句子的语义信息,作者采用新戴维森事件语义学以及一阶逻辑。与将句子压缩为扁平谓词结构不同,动词被实例化为事件变量,其参与者通过 agent 和 patient 等语义角色连接。例如,描述狼吃羊作为捕食者猎捕猎物示例的句子,可以形式化为一个陈述,其中 eating 和 hunting 是事件,wolf 和 predator 描述 agent,sheep 和 prey 描述 patient,而 example 关系连接这两个事件:
∀xye1(wolf(x)∧sheep(y)∧eating(e1)∧agent(e1,x)∧patient(e1,y)→∃e2(predator(x)∧prey(y)∧hunting(e2)∧agent(e2,x)∧patient(e2,y)∧example(e1,e2))).对于不涉及事件的静态或描述性陈述,系统使用普通的 FOL 形式,例如
∀x(gravity(x)→force(x))以及
∀xy(greater(x,y)→larger(x,y)).由于 LLM 可能产生句法无效的符号输出,在定理证明器尝试语义推理之前,框架包含一个句法精炼机制。定理证明器作为检查器,并在生成的 Isabelle/HOL 理论无法解析或类型检查时返回错误消息。这些错误被归类为类型统一错误,其产生原因是逻辑子句中声明的参数类型与实际参数类型不匹配;以及其他句法错误,例如缺少括号、未定义的实体名称或无效的逻辑符号。随后,LLM 会收到包含生成的理论、证明器错误以及针对该错误类型修复示例的提示。这种迭代句法纠错会改进形式编码,直到理论在结构上良构。
理论在句法上有效后,系统进入证明构造阶段。LLM 首先生成一个粗略的自然语言推理,作为初步证明策略。该推理识别哪些解释句子足以且必要用于推导假设,哪些句子冗余或无关。基于这一初步推理,LLM 构造可提交给 Isabelle/HOL 的形式证明步骤。典型的证明步骤遵循如下模式
show X using Y by Z,其中 X 是目标命题,Y 表示所使用的假设,Z 是自动化证明策略。在实践中,通常使用 blast,因为它是 Isabelle 中用于一阶逻辑定理证明的通用证明策略。
最后阶段执行验证与精炼。构造好的理论(包括公理、定理陈述和证明步骤)被交给定理证明器。如果证明器成功,解释被视为逻辑有效。如果证明失败或超时,系统从求解器中提取第一条相关错误,定位失败的证明步骤,并识别该步骤中应用的公理 B⊆A。随后移除冗余或无关的事实,尤其是那些未被成功证明步骤引用,或在初步推理中被标记为不必要的事实。LLM 会收到一个精炼反馈包,其中包含错误消息、失败的证明步骤、关联的证明策略,以及与公理对应的解释句子。该反馈指导 LLM 修订原始解释 Ei,纠正逻辑遗漏、无效推理或错误形式化的事实。随后循环重复。每次迭代都会缩小逻辑错误集合,并逐步精炼解释句子,直到所得理论可验证,且解释可被视为逻辑健全。
实验
实验在三个 NLI 风格数据集上评测五个 LLM,这些数据集的解释使用外部定理证明器进行形式化验证并迭代精炼。结果显示,证明器引导的反馈持续提升逻辑有效性并减少句法错误,且自动形式化质量对模型性能影响显著。更强的模型,特别是 GPT-4,从精炼中获益最多,尽管解释复杂度、偶发的事实性不准确以及罕见的平凡解释仍然是挑战。