Command Palette
Search for a command to run...
Backward Lens:将语言模型梯度投影至词表空间
Backward Lens:将语言模型梯度投影至词表空间
Shahar Katz Yonatan Belinkov Mor Geva Lior Wolf
摘要
理解基于 Transformer 的语言模型(LM)如何学习和检索信息,是深度学习社区的关键目标之一。近期的可解释性方法将前向传播中获得的权重和隐藏状态投影至模型的词表空间,从而揭示信息在语言模型内部的流动机制。本文将这一方法框架扩展至语言模型的反向传播与梯度。我们首先证明梯度矩阵可被表示为其前向传播与反向传播输入的低秩线性组合,随后提出将这些梯度投影至词表项的方法,并探索新信息如何被存储在语言模型神经元中的机制。我们的代码可在以下地址获取:https://github.com/shacharKZ/BackwardLens。
一句话总结
Technion 和 Tel Aviv University 的研究人员提出 Backward Lens,将词表空间投影扩展到语言模型梯度:通过证明梯度矩阵可以表示为前向传播与反向传播输入的低秩线性组合,揭示新信息如何存储在 Transformer 神经元中。
核心贡献
-
通过证明梯度矩阵是模型前向传播和反向传播输入的低秩线性组合,将 Logit Lens 式可解释性扩展到反向传播。
-
将梯度分量投影到词表空间,揭示 Transformer MLP 神经元中的一种“印记与偏移”机制,其中层输入和向量-雅可比乘积存储新信息。
-
实验支持该分析,并引入一种只需要单次前向传播且性能可与最先进知识编辑方法相当的知识编辑方法。
引言
基于 Transformer 的语言模型通过反向传播训练,利用梯度信息更新权重矩阵,因此梯度是模型学习、存储和应用知识的核心。解释这些梯度非常重要,因为它可以澄清新事实如何写入模型参数,并支持更透明的知识编辑。已有可解释性工作已将权重和前向传播激活投影到词表空间,例如通过 Logit Lens 方法,但很大程度上没有探索反向传播梯度,尽管现代层包含数千个神经元,且梯度分布在多个神经元上。作者利用梯度矩阵的结构,这些矩阵由前向传播输入和向量-雅可比乘积生成,并且通常具有低秩性质,从而将梯度子空间投影到 token 空间并分析它们携带的信息。基于此,他们揭示了 MLP 层中的 “imprint and shift”(印记与偏移)机制,解释语言模型如何获取和更新知识,并提出一种基于单次前向传播的简单知识编辑方法。
方法
该框架围绕自回归 Transformer 语言模型的反向传播展开,不把梯度仅仅视为优化信号,而是将其视为能够揭示信息如何写入模型的低秩几何对象。在标准 Transformer 块中,MLP 组件是主要被研究的可编辑模块。给定隐藏状态 Xl,该块的更新可以概括为:
Xl+1=Xl+Attn(Xl)+MLP(Attn(Xl)+Xl),其中 MLP 由两个全连接矩阵 FF1 和 FF2 组成,两者之间有一个非线性激活。这种结构使这两个矩阵成为解释和编辑的主要目标,因为前向传播会将中间输入写入 MLP 参数,而反向传播会根据由 prompt 和期望目标计算出的梯度修改这些参数。
第一步分析是刻画梯度矩阵的形状。对于线性参数或矩阵值参数,反向传播产生的梯度是前向传播隐藏状态与反向传播梯度外积之和,通常称为向量-雅可比乘积。对于包含 n 个 tokens 的序列,参数矩阵 W 的梯度可以写为:
∂W∂L=i=1∑nxi⊤⋅δi,其中 xi 是前向传播中观察到的输入向量,δi 是对应的反向传播向量。由于该梯度是 n 个秩一矩阵之和,其秩至多为 n,当某些向量线性相关时还可能更小。在 Transformer 中,这意味着由单个 prompt 引发的梯度在结构上比较简单,可以通过少量前向和反向向量而不是完整的高维权重矩阵进行分析。
这种低秩视角带来一个关键的可解释性选择:每个梯度矩阵可以用两种对偶方式查看,要么视为前向输入 xi 的张成,要么视为反向向量 δi 的张成。对于单个外积,这两种视角在数学上等价,但一旦将向量投影到词表空间,它们在分析上就会变得不同。参见下图:
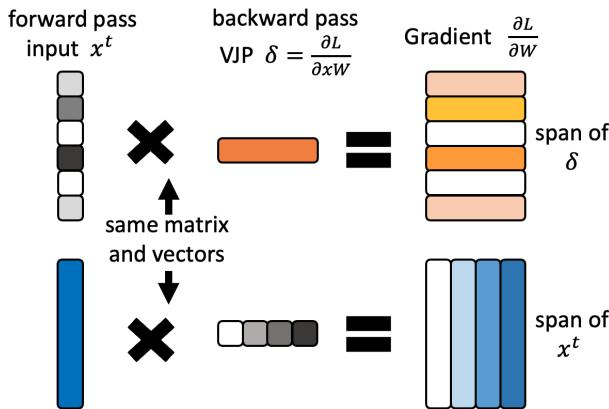
对于 FF1,使用前向输入 xi 作为张成集。梯度中的第 j 个神经元可以解释为隐藏状态的线性组合:
∂FF1∂L[j]=i=1∑nxi⊤⋅δi[j].这里,δi[j] 控制每个前向输入 xi 对该神经元的贡献幅度。对于 FF2,张成选择相反:梯度被分析为反向向量 δi 的组合:
∂FF2∂L[j]=i=1∑nδi⋅xi[j].在该公式中,前向输入充当缩放反向向量的标量系数。这种选择很重要,因为两个矩阵接收具有不同语义角色的向量:FF1 倾向于捕获当前 prompt 的表示,而 FF2 倾向于编码将输出推向目标 token 的反向信号。
为了理解反向信号本身,框架检查顶层的 VJP。最终模型参数是解码矩阵 D,它将隐藏状态映射到词表分数。如果 y^n 是最后一个 prompt token 的输出 logits,并且 p^=Softmax(y^n) 是预测分布,则传递给前一层的初始反向向量为:
∂xn∂L=δnD⊤.该向量可以分解为 token 嵌入的加权和:
δnD⊤=k=1∑∣vocabulary∣δn[k]D⊤[k].目标 token t 的系数近似为 p^[t]−1,通常为负,而各非目标 token 的系数是正概率 p^[k]。因此,初始反向向量包含期望目标的负嵌入,以及当前可能替代 token 的正嵌入。当该向量被向后传播时,它携带着使模型从旧预测推向新目标的语义压力。
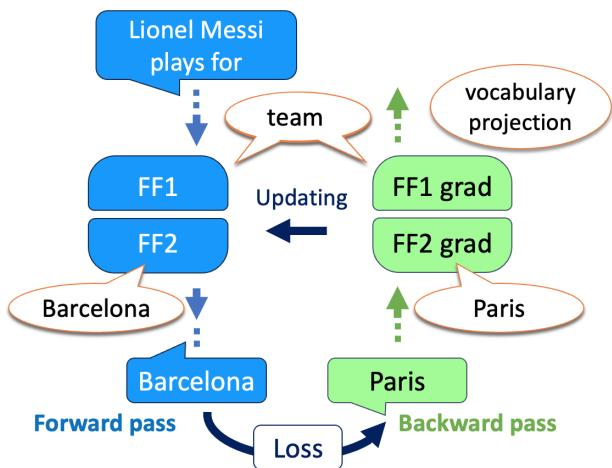
作者发现的核心机制是 “imprint and shift”。在单次反向传播期间,梯度更新并不是以相同方式作用于 FF1 和 FF2。相反,每个矩阵承担不同的功能角色。对于 FF1,更新将前向输入 xi 的缩放副本引入权重神经元。这是印记阶段:该层学会将当前输入模式与更新关联起来,从而改变某些隐藏激活触发下游神经元的强度。对于 FF2,更新将缩放的反向向量 δi 引入权重神经元,通常带有负号,因为梯度下降沿梯度相反方向移动。这是偏移阶段:该层改变其输出表示,使最终隐藏状态的投影朝目标 token 移动。如下图所示:
在该机制中,FF1 调整从 prompt 中选择哪些内部特征,而 FF2 调整这些被选择的特征如何写入输出词表空间。结果是两步更新:模型首先将输入上下文印记到第一个 MLP 矩阵,然后偏移第二个 MLP 矩阵,使最终解码路径偏向编辑目标。这解释了为什么编辑 Transformer 语言模型知识不只是标量权重调整,而是 prompt 表示与目标特定反向信号之间的结构化交互。
该框架还将这一洞见转化为一种轻量编辑流程。由于靠近顶层的反向向量与目标 token 嵌入强烈相关,因此可以通过直接使用目标嵌入来近似完整反向传播。编辑过程如下。首先,选择一个包含 FF2 的 MLP 层。然后,对要编辑的 prompt 运行单次前向传播,收集到达该层的最后一个隐藏输入 xn。接下来,从解码矩阵中检索目标 token 嵌入,即 D⊤[t]。最后,使用 prompt 输入与目标嵌入之间的外积更新 FF2:
FF2←FF2+η⋅xn⊤⋅D⊤[t],其中 η 是类似学习率的标量,用于控制更新强度。该方法避免了在多个 Transformer 层中计算梯度,因为目标嵌入替代了通常由损失梯度产生的反向向量。其底层依据是:FF2 是最直接与“偏移”阶段相关联的矩阵,因此添加一个由 prompt 条件化的目标向量,就足以使该层偏向期望输出。
总体而言,该方法为模型编辑提供了几何解释。作者将梯度视为前向向量和反向向量之和,分离两个 MLP 矩阵的不同角色,并使用词表空间投影来解释梯度正在向模型写入什么信息。由此形成的流程将反向传播的结构与一个可解释机制连接起来:FF1 印记输入,FF2 偏移输出,二者共同决定单个 prompt 如何改变 Transformer 语言模型的内部知识。
实验
实验在采样的 CounterFact 编辑样本上使用 GPT2 和 Llama2-7B,检验模型梯度的结构、可解释性和应用。实验支持预测的梯度秩行为,通过 logit lens 分析表明梯度主要编码编辑目标,并揭示更新贡献集中在早期层的 subject tokens,以及中间层的最后一个 prompt token。在 CounterFact 上的进一步应用测试表明,基于前向传播的更新可以以低得多的复杂度达到很强的单次编辑基线水平,但在泛化和特异性上较弱。
所评估的单次编辑方法在反事实 prompt 上改变 GPT2 XL 的行为,编辑有效性接近强基线方法,同时在大致可比的水平上保持生成流畅度。在改述 prompt 上,它不如最强基线鲁棒,并且在应保持不变的相近 prompt 上表现出更低的特异性。与未编辑模型相比,编辑后的模型在直接编辑的 prompt 上显著提高了成功率。基于前向传播的编辑方法以牺牲一些泛化和特异性优势为代价,换来显著更低的运行时编辑过程。
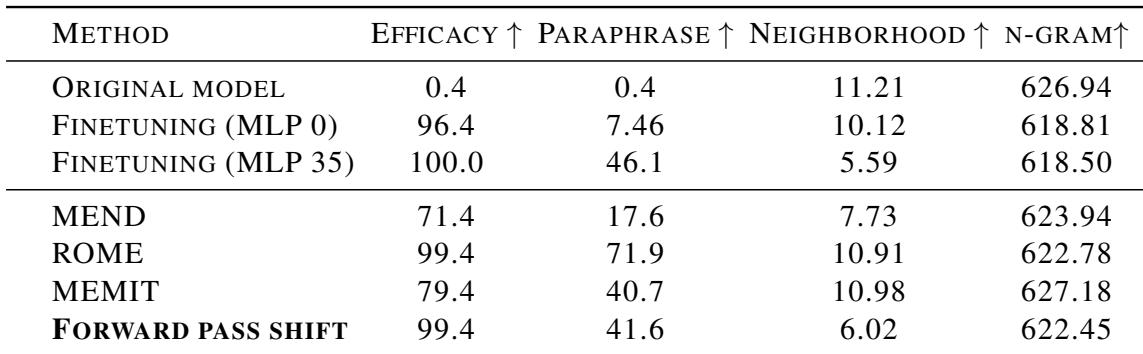
实验在反事实 prompt 上评估单次编辑方法,并与强基线进行比较,比较指标包括编辑有效性、流畅度、对改述的鲁棒性,以及在相近 prompt 上的特异性。结果表明,所评估方法取得了有竞争力的有效性和流畅度,并大幅提高了编辑 prompt 上的成功率,尽管相比最强基线其鲁棒性和特异性较低。研究结果还表明,基于前向传播的编辑方法以一些泛化和特异性优势换取显著更快的运行时性能。