Command Palette
Search for a command to run...
Do LLMs Plan Like Human Writers? Comparing Journalist Coverage of Press Releases with LLMs
Do LLMs Plan Like Human Writers? Comparing Journalist Coverage of Press Releases with LLMs
Alexander Spangher Nanyun Peng Sebastian Gehrmann Mark Dredze
摘要
Journalists engage in multiple steps in the news writing process that depend on human creativity, like exploring different "angles" (i.e. the specific perspectives a reporter takes). These can potentially be aided by large language models (LLMs). By affecting planning decisions, such interventions can have an outsize impact on creative output. We advocate a careful approach to evaluating these interventions to ensure alignment with human values. In a case study of journalistic coverage of press releases, we assemble a large dataset of 250k press releases and 650k articles covering them. We develop methods to identify news articles that challenge and contextualize press releases. Finally, we evaluate suggestions made by LLMs for these articles and compare these with decisions made by human journalists. Our findings are three-fold: (1) Human-written news articles that challenge and contextualize press releases more take more creative angles and use more informational sources. (2) LLMs align better with humans when recommending angles, compared with informational sources. (3) Both the angles and sources LLMs suggest are significantly less creative than humans.
一句话总结
来自 USC ISI、UCLA 和 Bloomberg 的研究人员开展了一项案例研究,比较 LLM 在新闻稿报道中的策划决策与人类记者的报道决策。研究发现,LLM 在推荐报道角度方面比推荐信息性信源更符合人类选择,但 LLM 建议的报道角度和信源与人类作者选择的相比仍然明显缺乏创意。
核心贡献
-
构建包含 650,000 篇新闻文章的语料库,覆盖 10 年间 250,000 份新闻稿,用于研究记者的报道规划决策。
-
引入对比式摘要方法,用于识别对新闻稿提出质疑的有效报道;在 6,000 个文章与新闻稿配对样本上,这类报道与更具创意的报道角度(r = .29)以及更多的信息性信源(r = .5)存在相关性。
-
LLM 推荐与人类报道角度选择的一致性高于与信源选择的一致性,F1 分数分别达到 63.6 和 27.9;人工评估则发现,LLM 建议的报道角度和信源都比人类方案更缺乏创意。
引言
作者研究 LLM 对新闻策划的辅助作用,其中深度报道需要在简单摘要之外识别有意义的叙事角度并选择适当信源。已有研究已表明 LLM 能够建议报道角度,但这些建议是否符合人类新闻价值仍不清楚,尤其是在创意性和信源选择方面。为弥补这一空白,作者构建了包含新闻稿及关联新闻文章的大规模语料库,通过对比式摘要定义有效报道,并建立基准,用于比较 LLM 生成的规划决策与真实人类新闻选择。
数据集
-
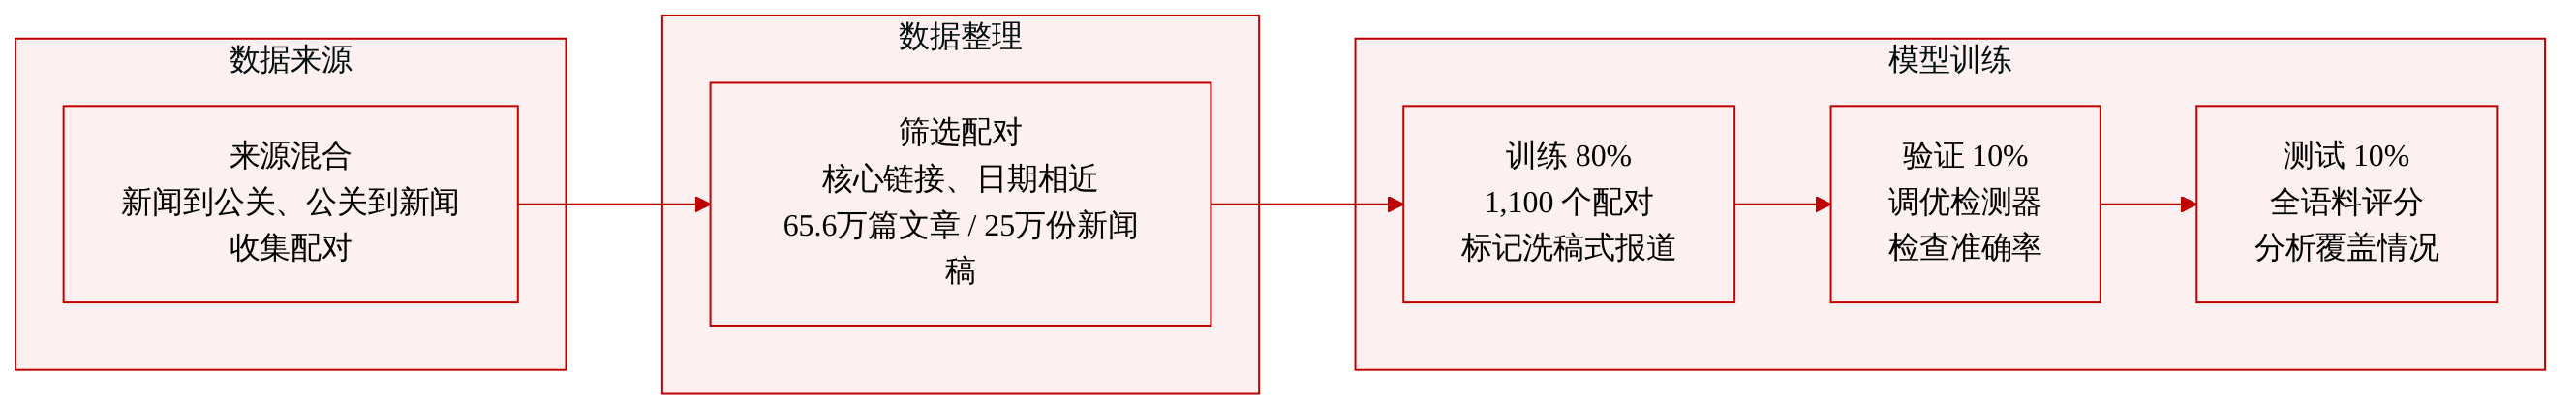
作者构建了 PressRelease,即新闻文章与新闻稿配对语料库。最终数据集包含 656,523 篇新闻文章和 250,224 份新闻稿,旨在支持分析记者如何报道新闻稿。
-
数据从两个互补方向收集,以降低采集偏差:
-
从新闻机构到新闻稿:
- 作者查询 Common Crawl,获取自 2021 年以来 9 家主要财经报纸的所有抓取批次中的全部 URL,得到 1.14 亿个 URL。
- 使用 Welsh (2022) 的监督模型,识别出 940,000 个属于新闻文章而非登录页面等其他页面类型的 URL。
- 作者在这些文章中找到指向已知新闻稿网站的超链接。
- 由此得到 247,372 篇文章,覆盖 117,531 份新闻稿。
- 对每个匹配的新闻稿,作者从 Wayback Machine 检索在相关新闻文章发表前发布的最新存档版本。
- 该方向存在偏差,因为它仅使用 9 家主要财经媒体,超链接过滤可能引入噪声,并可能更倾向于获得更多报道的新闻稿。
-
从新闻稿到新闻文章:
- 作者从所有 500 家标普 500 公司关联公关办公室的子域名收集新闻稿来源,并加入 OpenAI、SpaceX 和 Theranos 等其他受关注机构,以及若干值得关注的新闻稿。
- 通过反链服务查询指向这些新闻稿来源的网页。
- 再次使用 Welsh (2022) 模型识别对应新闻文章的反链。
- 从 Wayback Machine 检索得到 587,464 篇新闻文章和 176,777 份新闻稿。
- 该方向扩大了新闻机构覆盖范围,但可能过度代表大型公司发布的新闻稿,并可能遗漏未直接发布在公司网站上的新闻稿。
- 结合两个方向旨在减少单向流行度偏差。
-
-
作者应用过滤启发式规则,以保留新闻稿可能构成报道核心的配对:
- 当新闻稿链接出现在文章底部 50% 部分时,排除相应文章与新闻稿配对。
- 排除发布日期相差超过一个月的配对。
- 这些规则用于排除新闻稿不太可能是主要主题的文章。
-
生成的语料库包含同一新闻稿的多篇文章报道:
- 70,062 份新闻稿(占数据集的 28%)被多篇新闻报道。
- 这些被多篇报道的新闻事件对应 509,820 条文章级记录。
- 作者指出,当前工作未使用该结构,但该结构支持未来分析报道决策。
-
作者首先使用数据集在人工标注子集上训练并评估对比摘要检测器:
- 对 1,100 个文章与新闻稿配对进行标注。
- 一名标注员标注所有文档,第二名标注员标注 50 个文档以衡量一致性,一致率大于 0.8。
- 将标注子集按 80/10/10 划分为训练、验证和测试部分。
- 在输入构建过程中,作者测试加入共指消解,使文档表示在上下文中更完整。
- 训练检测器后,将其应用于完整 PressRelease 语料库,为文章与新闻稿配对获得文档级 NLI 分数,并用于分析新闻稿报道。
方法
作者将方法设计为多阶段流程:首先发现文章与新闻稿配对,然后将“有效报道”的模糊概念转化为量化评分问题,最后使用所得配对评估 LLM 对新闻策划的支持能力。流程包含三个耦合组件:双向语料库构建、对比式报道评分和对比摘要的监督检测。
语料库构建阶段以双向链接工作流形式设计,而非单一抓取操作。在一个方向上,作者收集新闻文章 HTML,识别实际新闻文章页面而非网站周边页面,然后在这些页面中搜索指向已知新闻稿域名的超链接。对每个被链接的新闻稿,作者检索在文章出现前发布的最新存档版本。该路径捕捉文章如何引用或链接新闻稿,但可能过度代表抓取范围内的新闻机构、流行新闻稿以及正文明确链接的新闻稿。
为抵消这些偏差,作者还沿相反方向遍历链接。作者识别新闻稿网站属性和相关组织页面,然后通过反链服务查询指向这些新闻稿来源的页面。返回页面被过滤以保留新闻文章反链,相应新闻稿页面再次从历史存档中检索。第二条路径扩大了新闻机构覆盖范围,尽管可能过度代表大型公司的新闻稿,并可能遗漏未直接发布在公司自有域名上的新闻稿。随后,过滤模块通过排除出现在文章后半部分的链接以及排除时间间隔较大的配对来移除弱配对。其直觉是,新闻稿应当是文章的核心主题,而不是脚注或旧引用。
形成候选配对后,作者通过对比式摘要概念定义有效报道。该模块的输入是一个新闻稿,表示为句子序列 P=p1,…,pn,以及一篇新闻文章,表示为另一个句子序列 N=n1,…,nm。有效的对比摘要必须满足两个条件。首先,文章必须足够频繁地引用新闻稿:
j=1∑nP(references∣N,pj)>λ1其次,文章必须足够频繁地质疑新闻稿:
j=1∑nP(contradicts∣N,pj)>λ2这里,“引用”被视为自然语言推理设定中蕴含和矛盾的并集,而“矛盾”直接对应矛盾关系。该公式将新闻实践操作化,即新闻稿不应只是被重复,而应被置于语境中并受到质疑。
为在文档规模估计这些关系,作者使用句子级自然语言推理模块。对每个新闻稿句子和每个文章句子配对,作者计算蕴含、矛盾或无矛盾等关系的 NLI 概率 p(y∣pi,nj)。然后,作者将这些局部信号聚合为新闻稿句子分数,方法是保留每个 pi 中最强的内部 top-k 关系:
si=kinner1j∈Topkinner(i)∑p(y∣pi,nj)si 分数表示给定新闻稿句子是否被充分覆盖或受到质疑。随后,作者通过对句子取平均的方式聚合外层 top-k 句子分数,以获得文档级覆盖信号。参数 kinner 控制有多少个文章句子支持一个新闻稿句子后,该句子才被视为被覆盖;参数 kouter 控制有多少个新闻稿句子被覆盖后,文章才被视为实质上是关于该新闻稿的。这种聚合刻意保持低成本且可扩展,因为它依赖句子两两评分,而非完整文档生成。
作者随后训练监督检测器以识别对比摘要。作者为文章与新闻稿配对添加两个标签:文章是否实质上是关于新闻稿的,以及文章是否质疑新闻稿。检测器将聚合后的 NLI 分数作为主要表示。一个重要的预处理选择是共指消解,因为代词和命名实体可能破坏新闻稿与文章之间的证据关联。作者比较了多种简单分类器,包括逻辑回归和多层感知机变体。作者还评估了分箱直方图式分类器,该分类器对 NLI 分数分布进行分箱,而不只依赖点式特征。带有共指消解的分箱直方图分类器给出最强检测性能,原因可能是它降低了对离群 NLI 分数的敏感性,同时保留了蕴含和矛盾分布的整体形状。
检测器训练完成后,被应用于更大的文章与新闻稿语料库,以分配文档级覆盖和质疑分数。这些分数随后被用于选择记者似乎进行了强对比式报道的配对。该选择构成 LLM 规划模块的基础。
对于规划评估,作者比较两类准备文档:人类记者撰写的方案,以及 LLM 生成的方案。比较聚焦于文章撰写前的两项具体新闻决策:选择报道角度和选择信源。报道角度指定报道的焦点或解释视角,而信源清单指定支持该角度所需的人物或文件。参见框架示意图,以了解人类方案与 LLM 方案之间的高层对比。如下图所示:
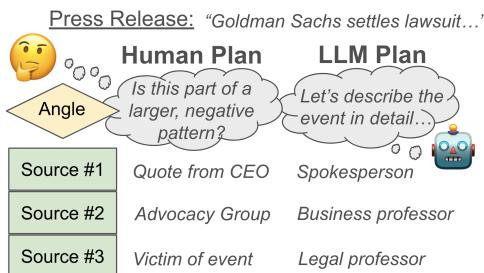
在图示比较中,人类方案将新闻稿视为更广泛负面模式的证据,并建议引用 CEO 引述、倡导组织以及直接受事件影响的人物作为信源。相比之下,LLM 方案将任务更狭窄地框定为描述事件,并建议新闻发言人或相关领域教授作为信源。这一比较使规划模块具有可操作性:作者不只询问 LLM 能否总结新闻稿,而是询问 LLM 生成的报道角度和信源选择是否类似人类新闻稿报道中所见的调查性策划决策。
实验
实验首先验证了一种基于 NLI 的新闻稿报道对比式摘要分析,表明有效新闻工作结合了语境化、质疑性陈述、创意性报道角度,以及多样且耗费资源的信源。随后,在零样本、少样本和微调设定下评估闭源与开源 LLM,并将 LLM 生成的报道角度和信源方案与人类记者方案进行比较,同时评估方案创意性。LLM 在再现人类策划方面仍然较弱,尤其是在信源和创意性方面,尽管微调揭示了一些可学习模式,并改善了报道角度建议。总体来看,这些发现将 LLM 定位为不完美的独立策划工具,并提示需要检索支撑和创意增强并辅以人工监督的方法。
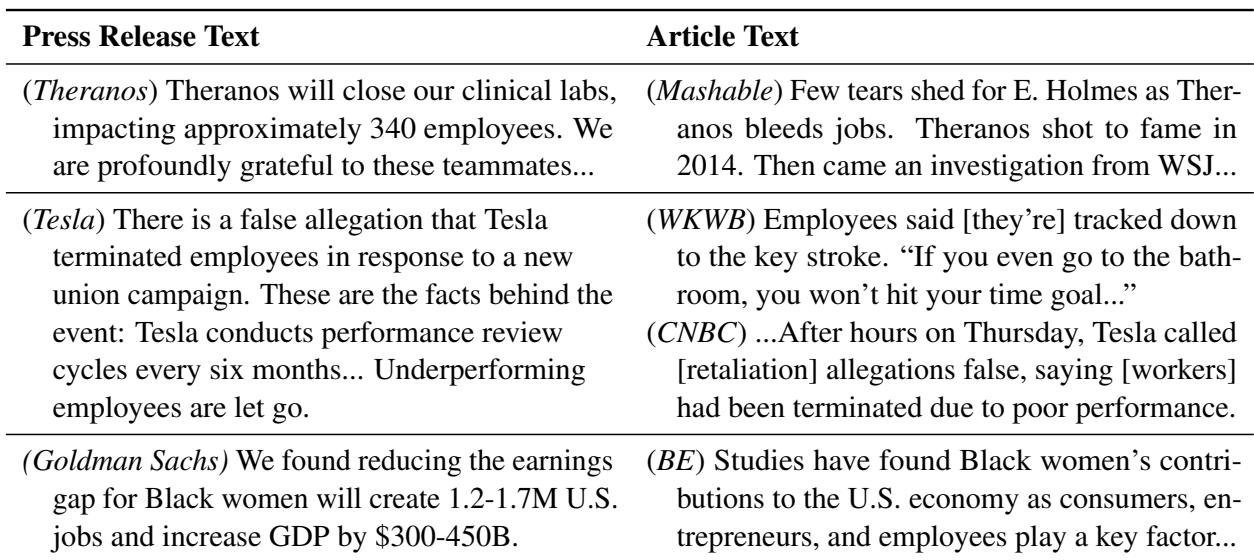
语料库将大量新闻稿与新闻文章配对,这些文章通过不同的报道角度和引用的信源改写或评价新闻稿。许多文章不局限于中立复述,而是加入批评性或语境化材料,且相当比例的新闻稿会被不同新闻机构重复报道。这些例子展示了新闻报道如何通过报道角度、证据和信源选择,将相同原始材料转化为不同叙事。新闻文章通常会通过添加中立、批评性或更具创意的报道角度来重塑新闻稿,而不是单纯重复新闻稿内容。报道质量与信源使用相关,包括人物信源、工会、员工、研究以及其他被报道的信息。相当比例的新闻稿被多篇文章报道,这为比较不同报道决策创造了机会。
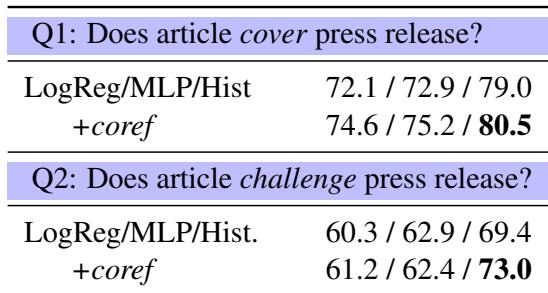
文档级 NLI 分类器检测新闻文章是否覆盖新闻稿的信号,强于检测是否质疑新闻稿的信号。带有共指消解的直方图分类器在两项检测任务中表现最好,而共指消解通常会提升性能,尤其是直方图模型。对于所评估的分类器而言,覆盖检测比质疑检测更容易。共指消解有助于产生更明确的预测,并使直方图分类器获得最大提升。
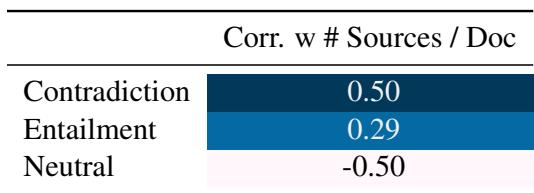
相关性结果表明,使用更多不同信源的文章更可能被标记为与新闻稿存在矛盾或蕴含关系。矛盾关系显示出最强的正相关,而蕴含关系也呈现正向但较弱的相关性。相比之下,中立报道与使用较少不同信源相关。对新闻稿构成矛盾的文章往往使用更多不同信源。与新闻稿存在蕴含关系的文章也倾向于使用更多信源,但相关性弱于矛盾关系。中立文章往往使用较少不同信源。
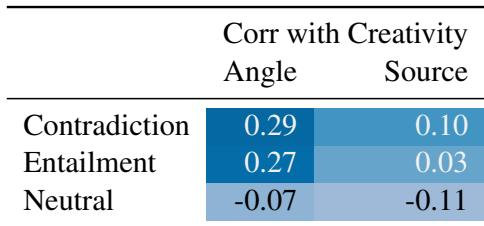
具有更具创意报道角度的文章,与新闻稿之间的 NLI 矛盾和蕴含关系均呈正相关。矛盾关系的正向关联略强于蕴含关系,中立关系则呈现弱负相关。矛盾和蕴含关系都与创意性报道角度正相关。中立报道与创意性呈现弱反向关联。
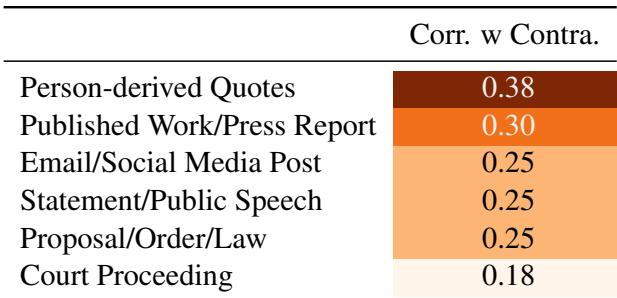
信源类型与新闻文章和新闻稿之间的矛盾程度相关。来自人物的引述具有最强正相关,表明更多质疑性报道往往包含从人物处获得的信息。已发表作品和新闻报道也呈正相关,而法院程序是所列信源类型中最弱的。来自人物的引述与更高矛盾程度相关性最强。已发表作品和新闻报道是其次正相关性最强的信源类型。电子邮件和社交媒体帖子、声明和公开演讲、提案、命令或法律均低于引述和已发表作品。
实验评估了一个将新闻稿与新闻文章配对的语料库,以考察报道如何被构建,以及文章是在扩展、质疑还是保持中立对待原始材料。分类器结果表明,检测新闻文章是否覆盖新闻稿比检测是否质疑新闻稿更容易,共指消解能够改善预测,尤其是对直方图模型。相关性分析进一步表明,使用更多不同信源和更具创意报道角度的文章更可能与新闻稿构成矛盾或蕴含关系,而中立报道与较少信源相关;来自人物的引述尤其与质疑性报道相关联。