Command Palette
Search for a command to run...
我应该回答哪些问题?探究性问题的显著性预测
我应该回答哪些问题?探究性问题的显著性预测
Yating Wu Ritika Mangla Alexandros G. Dimakis Greg Durrett Junyi Jessy Li
摘要
探究性问题——人们在阅读过程中出于好奇心而提出的开放式问题——是话语处理(Van Kuppevelt, 1995; Onea, 2016; Kehler and Rohde, 2017)和文本理解(Prince, 2004)的有机组成部分。近年来,自然语言处理领域的研究利用大语言模型的问题生成能力来增强广泛的应用。然而,探究性问题的空间极为广阔:给定语境可以唤起大量潜在问题。那么,应当优先回答哪些潜在问题呢?遗憾的是,语言学理论尚未给出答案。本文提出了 QSALIENCE,一个针对探究性问题的显著性预测模型。QSALIENCE 基于我们构建的数据集进行指令微调,该数据集包含 1,766 个(语境,问题)对,其显著性分数由语言学家标注。当回答某个问题能够显著提升对文本的理解时,该问题的显著性分数较高(Van Rooy, 2003)。我们从实证角度证明,高显著性问题更有可能在同一篇文章中被回答,从而将潜在问题(Onea, 2016)与讨论中的问题(Questions Under Discussion, QUD)(Roberts, 2012)联系起来。我们进一步通过实验验证了上述发现:回答显著性问题是新闻摘要质量的一个有效指标。
一句话总结
得克萨斯大学奥斯汀分校和 BespokeLabs.ai 的研究人员提出 QSALIENCE,这是一种面向探究性问题的指令微调显著性预测器,训练于一个由语言学家标注的 1,766 (context,question) 对数据集。结果表明,显著性很高的问题更可能在同一篇文章中得到解答,并可作为新闻摘要质量的一个指标。
核心贡献
- QSALIENCE 被提出作为面向探究性问题的指令微调显著性预测器,训练于由语言学家标注的 1,766 (context,question) 对,这些对按 1 至 5 点李克特量表评分。
- 更高的显著性分数被证明可预测探究性问题稍后是否会在同一篇文章中得到解答,这为潜在问题与正在讨论中的问题之间提供了经验联系。
- 下游实验将显著性与摘要扩展和新闻摘要联系起来:回答更多显著性问题的摘要被认为质量更高,并且微调后的显著性预测模型在显著性预测上优于 GPT-4。
引言
预训练语言模型现在能够从文本生成开放式、好奇心驱动的问题,支持阅读理解、扩展、新闻视角分析、追问和摘要等任务。挑战在于同一上下文可生成许多可能问题,但只有部分问题对理解篇章有用;先前的语言学和计算研究尚未充分建模读者预期哪些问题会被解答,以及它们有多显著。作者引入了带有显著性和可回答性评分的语言学家标注探究性问题语料库,表明显著性与答案效用以及已知的正在讨论中的问题相一致。随后训练了 QSALIENCE,一种从文章上下文预测问题显著性的指令微调模型,该模型优于 GPT-4 提示,并支持更小的模型。还证明扩展摘要以回答更显著的问题可提升读者排名。
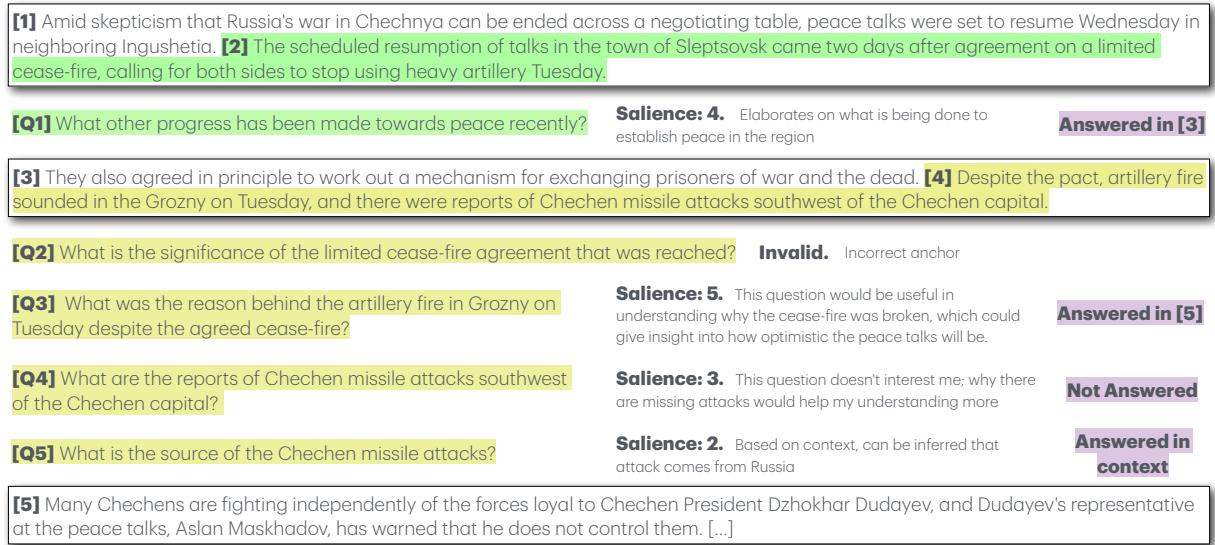
数据集
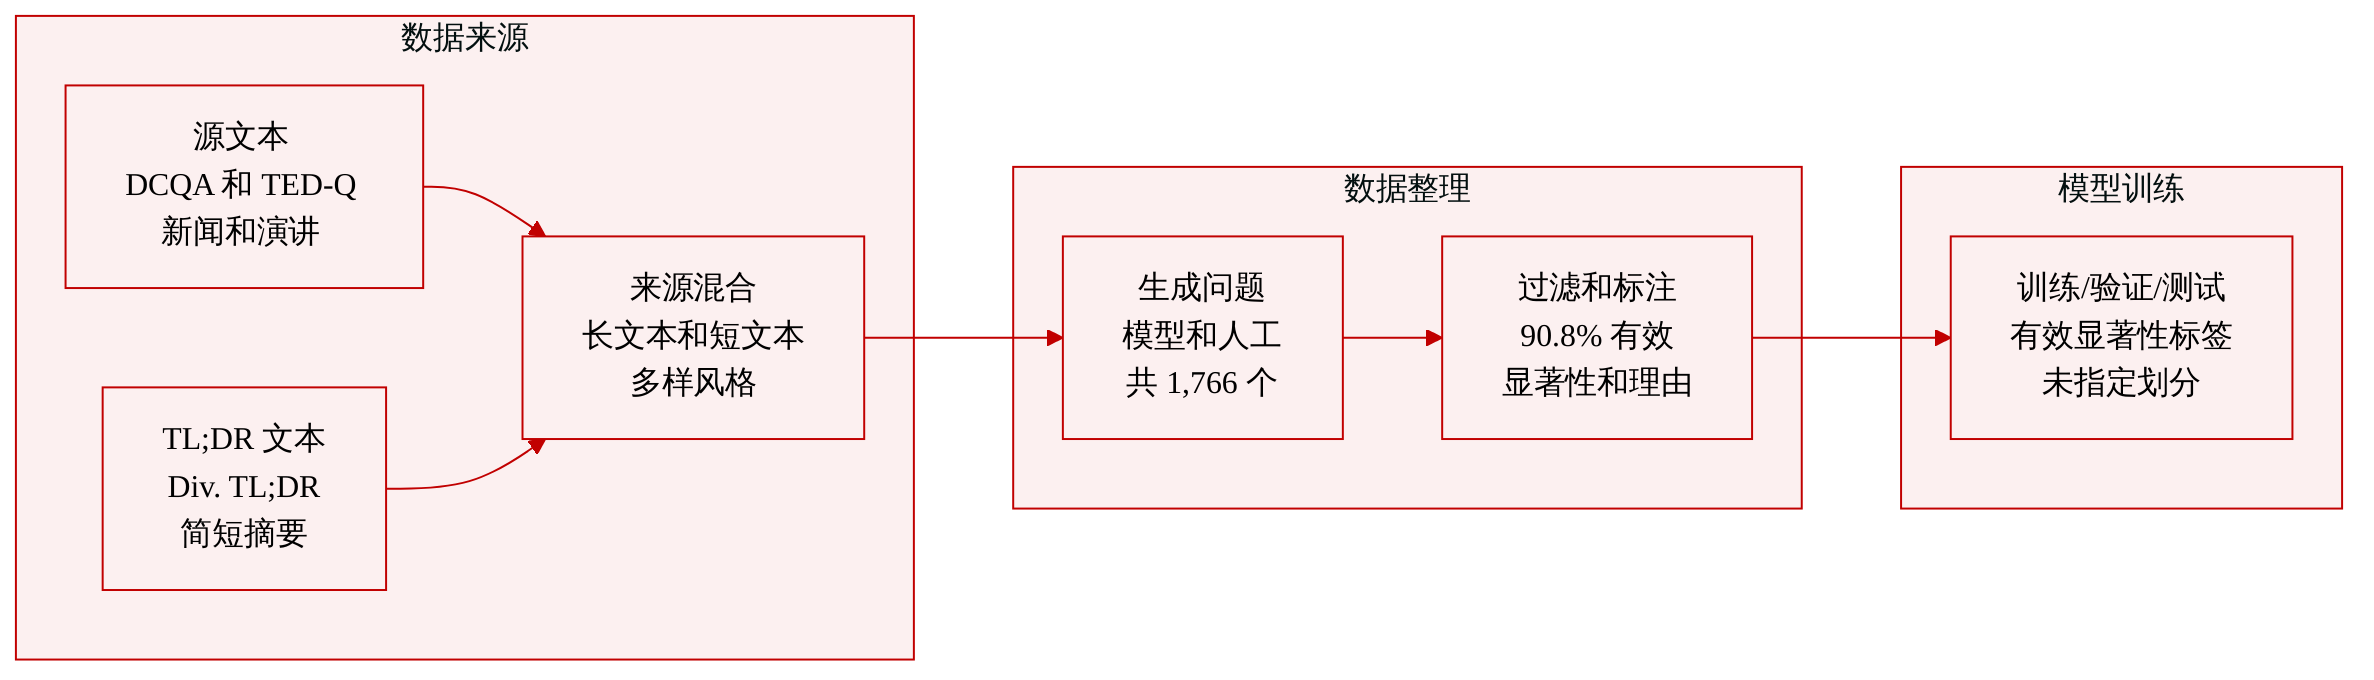
-
作者引入 QSALIENCE-data,这是包含 1,766 个探究性问题的语料库,每个判断均带有显著性标注和自然语言理由。
-
该语料库由多个现有文本来源组成,以支持不同分析:
- DCQA:带有 LLM 生成问题和已有标注正在讨论中的问题的新闻文章,用于比较一般探究性问题和正在讨论中的问题。
- TED-Q:带有人工生成问题的 TED 演讲摘录,用于显著性和可回答性分析。
- DiverseSumm:较新的新闻文章,用于下游摘要任务。作者将完整文章子集记作 Div.Article,将生成的简短摘要子集记作 Div.TL;DR。
-
报告的来源子集详情包括:
- 1,705 个机器生成问题,使用四个模型创建:来自 Llama-2-7B-chat 的 250 个、来自 Mistral-7B-instruct 的 249 个、来自 GPT-3.5-turbo 的 100 个,以及来自 GPT-4-turbo 的 1,106 个。
- 来自既有语料库的 61 个人工生成问题:来自两篇 DCQA 文章的 36 个,来自一篇 TED-Q 文章的 25 个。
- DiverseSumm 文章被选择为大约 1,500 词长,以便进行公平的下游评估。
- Div.TL;DR 包含由 GPT-4-turbo 生成的约 50 词摘要,通常有三句话,并且这些摘要中的问题显著性也被标注。
-
问题构建采用锚句和上下文窗口方法:
- 提示向 LLM 提供一个前文上下文,记作 Cp,以及一个锚句,记作 Sk。
- 模型被要求生成五个关于锚句中读者可能好奇部分的问题。
- 对于完整文章,问题生成探测从第 4 句开始,持续到第 16 句,探测之间相隔两句。
- 对于简短的 TL;DR,逐句生成问题。
-
显著性标注和过滤:
- 三名经过培训的本科生标注者为每个问题提供显著性标签和自然语言理由。
- 超过 90.8% 的 LLM 生成问题被标记为有效。
- 无效问题通常缺少正确的锚句,或包含非事实预设。
- 显著性标签通过平均标注者分数并四舍五入到最近整数进行聚合。
- 标注者间一致性报告为实质性一致,Krippendorff’s alpha 值分别为 DCQA 的 0.719、TED-Q 的 0.632、Div.Article 的 0.751 和 Div.TL;DR 的 0.649。
-
数据集模式包括问题文本、来源文章或摘要、前文上下文、锚句、显著性标签、理由、问题有效性,以及在适用时生成问题的 LLM。
-
为分析构建了一个独立的可回答性标注子集:
- 对 225 个有效 DCQA 问题和 86 个有效 TED-Q 问题,标注其是否在后续篇章中得到解答。
- 可回答性量表为:0 表示已在前文上下文中解答,1 表示未解答,2 表示部分解答,3 表示完全解答。
- 可回答性的标注者间一致性为 0.799。
-
论文使用该数据集分析显著的潜在问题是否稍后也在篇章中得到解答,比较正在讨论中的问题与随机潜在问题,并构建和评估显著性预测设置。
-
标注者的理由用于 few-shot Chain-of-Thought 提示,有效标注问题为显著性预测提供监督信号。
-
提供的文本未明确指定训练划分或混合比例;描述聚焦于标注池、来源子集和预测用例。
-
在下游摘要用例中,作者抽样 34 篇约 1,500 词的 DiverseSumm 文章,并生成约 50 词的 GPT-4-turbo TL;DR。
-
同时创建三种扩展摘要条件,长度控制在 230 至 250 词:
- GPT-4 扩展摘要。
- Flan-T5-large 扩展摘要,并使用 GPT-4-turbo 进行润色,以在保留原摘要的同时修正明显错误。
- GPT-4 损坏摘要,合成时省略常见的重要主题,随后为连贯性和长度进行润色。
-
每条 TL;DR 中的每个句子都与五个 LLM 生成的探究性问题相关联,并标注显著性。
-
随后,微调后的显著性模型被应用于下游集合中的所有有效问题,以生成预测的显著性值。
方法
核心方法聚焦于通过将该任务视为篇章级评分问题来预测有效问题的显著性。对于每个有效问题,模型接收结构化输入,由父上下文 Cp、目标句子跨度 Sk 和问题 Q∗ 组成。预测目标是给定该上下文时与该问题关联的显著性分数。该公式允许模型恢复隐式篇章信息,例如问题是否针对周围文本中的关键、信息丰富或突出部分,而非边缘或未充分展开的细节。
作者通过向若干开源大语言模型应用 QLoRA,构建了被称为 QSALIENCE 的指令微调显著性预测器,这些模型包括 Mistral-7B-Instruct、Llama-2-7b-chat、TinyLlama-1.1B-chat 和 Flan-T5-base。QLoRA 支持对大语言模型进行高效低秩适配,使其可以在无需全参数训练的情况下针对显著性预测任务进行微调。优化使用 AdamW 执行,并将任务表述为监督式序列到序列或指令跟随学习,其中每个训练实例都被表示为输入输出对:
(Cp,Sk,Q∗)→salience score对大多数模型而言,指令提示的框架与人类标注指导类似。对 Flan-T5-base 而言,可用上下文窗口仅有 512 tokens,因此也在没有显式指令的情况下测试该模型。在该设置中,上下文按从 Cp 和 Sk 开始的逆句顺序被截断,直到填满最大长度,在符合序列预算的同时保留最局部相关的内容。
为建立较强的比较基准,方法还包括使用 GPT-4-turbo 的 zero-shot 和 few-shot 提示流程。在 zero-shot vanilla 设置中,模型接收到要求其分配显著性分数的指令,紧密反映提供给人类标注者的标准。在 few-shot vanilla 设置中,提示包含 15 个上下文内示例,每个显著性标签各 3 个。每个示例将上下文输入映射到一个显著性分数。这些示例的排序被刻意安排,使得训练标签更常见的示例出现在提示末尾附近。该设计利用大语言模型的新近性偏差,鼓励产生更符合任务标签分布的预测。
还引入 k 最近邻 few-shot 变体,使示例选择更依赖实例。对每个测试实例,父上下文 Cp 和句子跨度 Sk 使用 RoBERTa-large 分别编码。两个组件的 CLS 嵌入被平均,形成单一表示。随后使用欧氏距离检索最近邻示例,为每个显著性标签选择最近的一个示例。这些检索到的示例按与 vanilla few-shot 设置类似的策略在提示中排序,保留任务分布和实例特定相关性。
提示策略进一步扩展为 chain-of-thought 提示。在 few-shot chain-of-thought 配置中,提示包含 5 个示例,这些示例包含从人类显著性标注中提取的自然语言理由。这鼓励模型在产生最终显著性判断之前生成中间推理,检验显式理由是否改善与人类标注的一致性。
在下游摘要质量分析中,显著性预测器被整合到生成式摘要流程中。源文章首先被压缩为简短 TL;DR 摘要,例如使用 GPT-4-turbo 生成的 50 词摘要。这些摘要随后用作生成更长扩展摘要的基础,通常介于 230 和 250 词之间。构建三种扩展摘要变体。第一种由 GPT-4-turbo 根据源文档和 TL;DR 直接生成。第二种由 Flan-T5-large 生成,然后由 GPT-4-turbo 润色,以纠正明显问题,例如重复句子或未遵循长度约束。第三种是合成损坏摘要,通过要求 GPT-4-turbo 生成长摘要并省略从 TL;DR 中识别的重要主题来产生;损坏输出也经过润色,以改善连贯性和长度合规性,同时保留有意减少的主题覆盖。
对于每条 TL;DR,每个句子都与生成的探究性问题相关联,每个有效问题都被评分显著性。同时使用人类标注和模型预测:问题获得显著性标签,微调后的显著性模型在有效问题上运行以获得预测显著性值。该设计允许系统比较更强的扩展摘要是否倾向于回答预测显著性更高的问题,而损坏摘要基线为省略核心主题的摘要提供受控负信号。
实验
实验评估标注问题显著性是否对应可回答性、模型能否预测显著性,以及基于显著性的分数是否反映摘要质量。标注的潜在问题越显著,也越可能在稍后被解答,表明读者好奇心与篇章发展之间存在一致。对于显著性预测,微调模型比提示的大语言模型更好地学习该概念,并与人类判断达到中等一致,不过任务仍具挑战性。在摘要用例中,汇总扩展摘要中回答的问题的显著性可复现人类质量排名,支持更好摘要会处理更显著问题的观点。
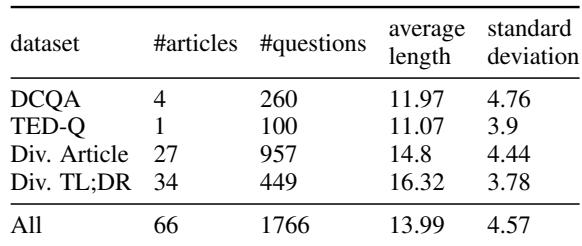
该表总结了从新闻文章、TED 演讲和 DiverseSumm 材料中提取的多来源问题集合。DiverseSumm 文章和 TL;DR 子集提供了最大份额的文章和问题,而 TED-Q 子集小得多。平均问题长度总体适中,各数据集大致相当,其中 TL;DR 子集的平均问题长度通常最长,各数据集间存在中等变化。数据集混合了来自多个语料库的人工标注问题和机器生成问题。DiverseSumm 为下游显著性分析贡献了最大量的数据。各子集的问题长度趋势一致,只有 TL;DR 子集略长。
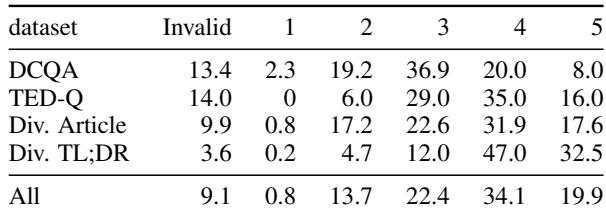
人类标注显示,大多数生成问题被判断为有效,表明语言模型能够产生有前景的探究性问题。标注的显著性标签分布于整个量表,而非集中于低分,且分布因来源数据集而异。这种变化支持将显著性用作下游问题评估和扩展任务的有用信号。大多数问题被标为有效,无效问题在各数据集中均属例外。具有最低显著性的有效问题很少,表明有效问题通常并非与周围上下文无关。显著性分布因数据集而异,多样化 TLDR 问题显示出向更高显著性分数更强的集中。显著性标签的分布表明并非所有有效问题都同等有用,使显著性预测器具有潜在价值。
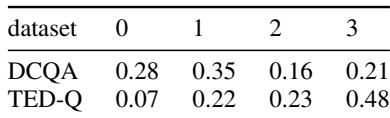
标注的可回答性分布因数据来源而异,TED-Q 问题在完全解答类别中占比最大。DCQA 问题更集中于较低可回答性类别,尤其是已解答和未被后续上下文解答。TED-Q 问题比 DCQA 问题更常被判断为在后续上下文中完全解答。DCQA 问题在较低可回答性类别中有更大占比,包括已解答和未被后续上下文解答。
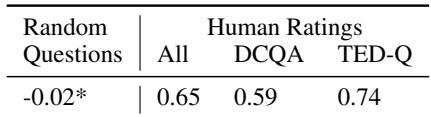
人类评分表明,更显著的潜在问题在后续篇章中往往更可回答,显著超过随机基线。这种正相关出现在两个标注子集中,TED-Q 显示出比 DCQA 更强的关系。该模式表明读者显著性与作者可回答性相关。在标注的人类判断中,显著性与可回答性呈正相关。该关系在 TED-Q 子集中比在 DCQA 子集中更强。随机基线未显示可比的关联。
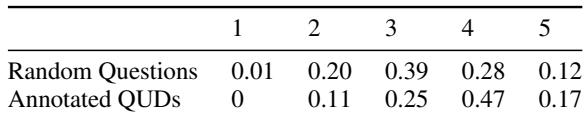
与随机采样的潜在问题相比,人工标注的正在讨论中的问题更分布到更高显著性分数,低显著性案例更少,高显著性案例更多。该模式表明,稍后可能在篇章中得到解答的问题也更可能是显著的潜在问题。正在讨论中的问题在显著性分布高端显示出比随机潜在问题更强的集中。正在讨论中的问题在显著性分布低端出现远少于随机比较集。观察到的偏移支持显著性与稍后可回答性相关联的观点。
实验构建多来源问题集合,并使用人类标注来检验问题有效性、显著性和可回答性。标注显示大多数机器生成问题有效,而显著性和可回答性分布因语料库而异,并提供有用信号,而非均匀低分模式。人类评分进一步支持显著性与稍后可回答性正相关的结论,与随机潜在问题相比,人工 QUD 倾向于占据显著性分布高端。