Command Palette
Search for a command to run...
基于分段最大项权重的阈值驱动剪枝用于近似聚类稀疏检索
基于分段最大项权重的阈值驱动剪枝用于近似聚类稀疏检索
Yifan Qiao Parker Carlson Shanxiu He Yingrui Yang Tao Yang
摘要
本文重新审视了基于聚类的稀疏检索中通过排名分数阈值化实现的动态剪枝方法,该方法在推理阶段于簇和文档级别部分跳过索引计算。本文提出了一种名为 ASC 的双参数剪枝控制方案,该方案对排名安全竞争性提供了概率性保证。ASC 利用簇级最大权重分段来提升排名分数界估计的精度,并结合阈值驱动剪枝策略,旨在加速对相关性竞争力要求较高的检索应用。在 MS MARCO 和 BEIR 上的实验表明,ASC 在保持单线程 CPU 低延迟的同时,提升了剪枝的准确性与安全性,从而获得更好的检索相关性。
一句话总结
加州大学圣巴巴拉分校提出 ASC,这是一种面向基于聚类的稀疏检索的双参数动态剪枝方案,它利用分段最大词权重来收紧排名分数界估计,并实现概率性排名安全保证,如 MS MARCO 和 BEIR 基准所验证,在单线程 CPU 上保持低延迟的同时提升相关性竞争力。
核心贡献
- ASC 是一种面向基于聚类的稀疏检索的双参数剪枝控制方案,在推理过程中于簇级和文档级跳过索引部分,以追求高相关性竞争力。
- 它通过簇级最大权重分段改进排名分数界估计,并采用阈值驱动剪枝,对排名安全竞争力提供概率性保证。
- MS MARCO 和 BEIR 上的实验表明,ASC 提升剪枝准确性和相关性竞争力,同时在单线程 CPU 上提供低延迟。
引言
快速且有效的文档检索对大规模搜索和检索增强生成至关重要,其中 CPU 上的稀疏检索为稠密近似检索提供了有吸引力的低成本替代方案。学习稀疏模型可以非常有竞争力,尤其对于跨领域搜索,但在线推理仍需更快的排名分数阈值剪枝。现有剪枝方法(如 MaxScore、WAND 和 BMW)是排名安全的,然而基于簇的界通常较为宽松,阈值过高估计可能在没有正式相关性保障的情况下跳过相关文档。作者提出 ASC,这是一种双参数阈值控制方案,利用簇级最大权重分段收紧簇界,并提供概率性排名安全保证,从而在保持高相关性的同时实现更快的稀疏检索。
方法
ASC 架构与检索流程
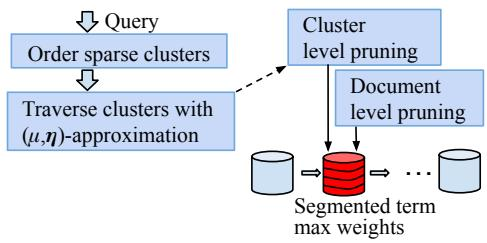
作者提出一种基于簇的近似检索框架,通过在簇级作出更好的剪枝决策来降低在线搜索成本。该方法建立在簇化倒排索引之上:文档集合被划分为 m 个簇 Ci,倒排列表按这些簇组织。查询处理期间,系统首先估计每个簇的上界,并按估计界从高到低排序稀疏簇,然后顺序遍历这些簇。在访问每个簇时,框架在进入文档级评估之前应用簇级剪枝。若某簇通过剪枝,其内部仍可使用标准文档级跳过。这一在线工作流由两个参数 μ 和 η 控制,满足 0<μ≤η≤1,分别控制激进跳过和概率安全性。
所提方案的整体在线推理流程如框架图所示。
基线簇界估计的核心是簇级 Anytime Ranking 使用的簇上界。给定查询 Q,簇 Ci 中任意文档的最大可能排名分数估计为
BoundSum(Ci)=t∈Q∑d∈Cimaxwt,d,其中 wt,d 是词项 t 在文档 d 中的权重。在标准基于簇的检索中,当该上界与当前 top-k 阈值 θ 不具竞争力时,可以跳过该簇。常见松弛是阈值过高估计,即剪枝使用放大的阈值 θ/μ,其中 0<μ≤1。这使得系统在界估计宽松时可以丢弃更多低分文档。然而,当界已经准确时,统一应用过高估计可能不安全,因为相关文档可能被错误剪枝。
原始簇界的主要弱点是,当簇包含多样化文档向量时可能过于宽松。词项最大值在整个簇的所有文档上聚合,因此估计可能反映异质文档的上包络,而非任何单个文档可达到的分数。减小簇大小可提高紧致度,但这会引入显著在线开销:更多簇需要更多界计算、更多最大权重查找,以及更多必要查询词项推导。参见下图,该图比较了随着簇数变化时不同基于聚类的检索方案的界紧致度。
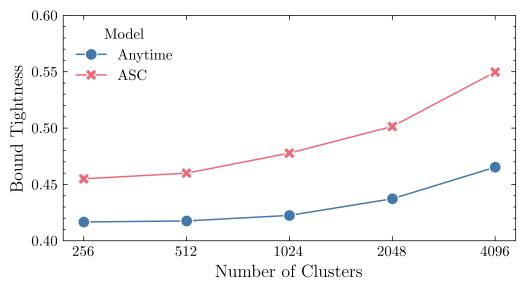
图中绘制的紧致度是簇内实际最大排名分数与估计簇界之间的比值。接近 1 表示界更锐利,接近 0 表示界更宽松且剪枝决策更保守。所提方法通过向每个簇添加段级信息来改进界紧致度,而不会实质增加簇数量。
分段簇最大权重与两级剪枝
所提方法在离线索引构建期间将每个簇划分为 n 个较小组。设每个簇 Ci 被划分为段
{Si,1,…,Si,n},使用随机均匀划分。对于每个段,索引存储该段内每个查询词项的最大权重贡献。对于查询 Q,段 Si,j 的段界为
Bi,j=t∈Q∑d∈Si,jmaxwt,d.由这些段界,框架导出两个簇级摘要:
MaxSBound(Ci)=j=1maxnBi,j,和
AvgSBound(Ci)=n1j=1∑nBi,j.最大段界提供比全簇 BoundSum 更紧的上界,因为它将词项最大值聚合限制在更小的文档子集内。平均段界提供关于簇内段分数整体分布的额外信息。直观上,如果一个段的界很高但多数段的界低得多,则簇更具异质性,最大界可能可靠性较低。如果平均段界接近最大段界,则簇内部一致性更高,界估计可能更紧。
查询处理期间,当两个基于段的条件均满足时,该簇被剪枝:
MaxSBound(Ci)≤μθ和
AvgSBound(Ci)≤ηθ.第一条件使用 μ 允许激进跳过,类似于阈值过高估计。第二条件使用 η,在整体簇看起来有希望时防止过度激进剪枝。若某簇未被剪枝,则继续文档级遍历,当文档 d 的实时界满足下式时可跳过该文档
Bound(d)≤ηθ.因此,μ 主要控制簇跳过激进程度,η 控制用于保留潜在有价值簇和文档的安全阈值。当 η=1 时,框架设计为概率安全,依赖文档到段的均匀划分。
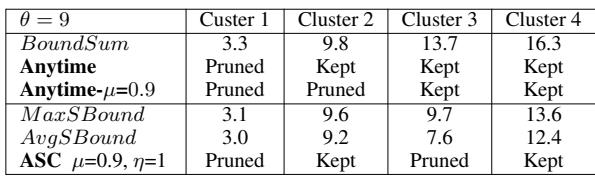
可通过下面的簇剪枝示例理解索引结构和剪枝行为。
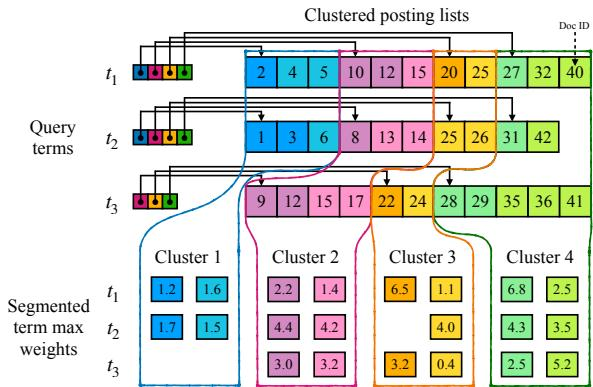
该图展示了若干查询词项的簇化倒排列表,以及段级最大词权重。每个簇包含多个段,来自这些段的相关查询词项最大值被组合以估计段界。该示例比较不同控制设置下的剪枝决策。在固定当前 top-k 阈值下,方法可以决定是否应剪枝某簇,并且同一文档级阈值也可移除保留簇内的低分文档。
存储的段最大值需要额外索引空间,但该设计通过仅以稀疏形式存储非零最大权重使该开销可控。实践中,段最大值可使用紧凑量化权重表示,因为其作用是引导剪枝而非复现精确排名分数。
紧致度感知剪枝控制
分段表述不仅有助于产生更紧的界,也有助于检测簇何时不应被剪枝。该方法观察到 MaxSBound(Ci) 与 AvgSBound(Ci) 之间的差距可作为界可靠性的实用指标。当最大段界远大于平均段界时,簇可能仅包含少量高分局部区域,最大界可能高估簇中大多数文档。在这种情况下,由 μ 引导的激进剪枝更可接受。反之,当平均段界和最大段界接近时,簇可能内部一致,剪枝可能移除分数均匀接近保留界的文档。
这一行为反映在形式化剪枝性质中:当估计界已经紧时,不应发生簇级剪枝。具体而言,当最大段界仍高于激进阈值,或最大段界与平均段界之间的差异较小时,避免剪枝:
MaxSBound(Ci)−AvgSBound(Ci)≤(μ1−η1)θ.该条件确保具有高界质量估计的簇不太可能仅因为较小的 μ 值使上界阈值更严格而被丢弃。参见下图,该图展示界紧致度与比值 AvgSBound/MaxSBound 之间的关系。
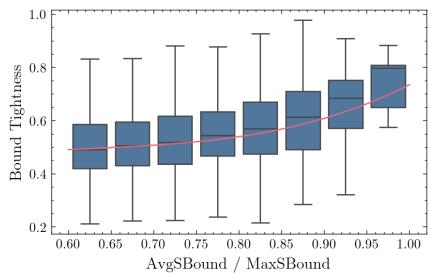
当比值接近 1 时,估计界变得更紧且更稳定,簇被剪枝的可能性越来越低。因此,分段作为一种诊断信号:它告诉系统何时适合激进跳过,以及何时应更保守地信任估计。由于底层文档到段的分配是随机均匀划分,簇内每个文档落入任何段的概率相同。这支持将平均段界作为簇整体分数分布的统计可靠指标,使方法在允许高效簇跳过的同时近似排名安全行为。
实验
在 MS MARCO、TREC 和 BEIR 上使用稀疏检索模型进行的实验,在受控相关性损失预算下评估 ASC 的簇分段剪枝,与精确 MaxScore、Anytime Ranking 和 IOQP 进行比较。结果显示,ASC 在大幅降低延迟的同时保持有效性,尤其在较小检索深度和使用概率性簇界时。附加测试证实其在不同稀疏模型、跨领域基准、分段策略,以及与提前终止或静态索引剪枝结合时的收益。
该示例展示了四种检索簇在不同界和阈值设置下的在线簇级剪枝决策。在相同阈值下,Anytime 保留三个簇,Anytime mu 等于 0.9 保留两个簇,而 ASC mu 等于 0.9 且 eta 等于 1 保留簇 2 和簇 4,同时剪枝簇 1 和簇 3。文中建议为概率安全设置 eta 等于 1,并使 mu 从 1 变到 0.5,以在效率和有效性之间权衡,而在可以接受相关性损失时,较低的 eta 可降低延迟。对于同一组簇,Anytime、Anytime mu 等于 0.9 和 ASC 的剪枝结果不同,表明其对剪枝方法敏感。ASC 可以保留不同于 Anytime 基线的簇子集,表明概率性簇剪枝可以在在线搜索期间重新导向检索工作。
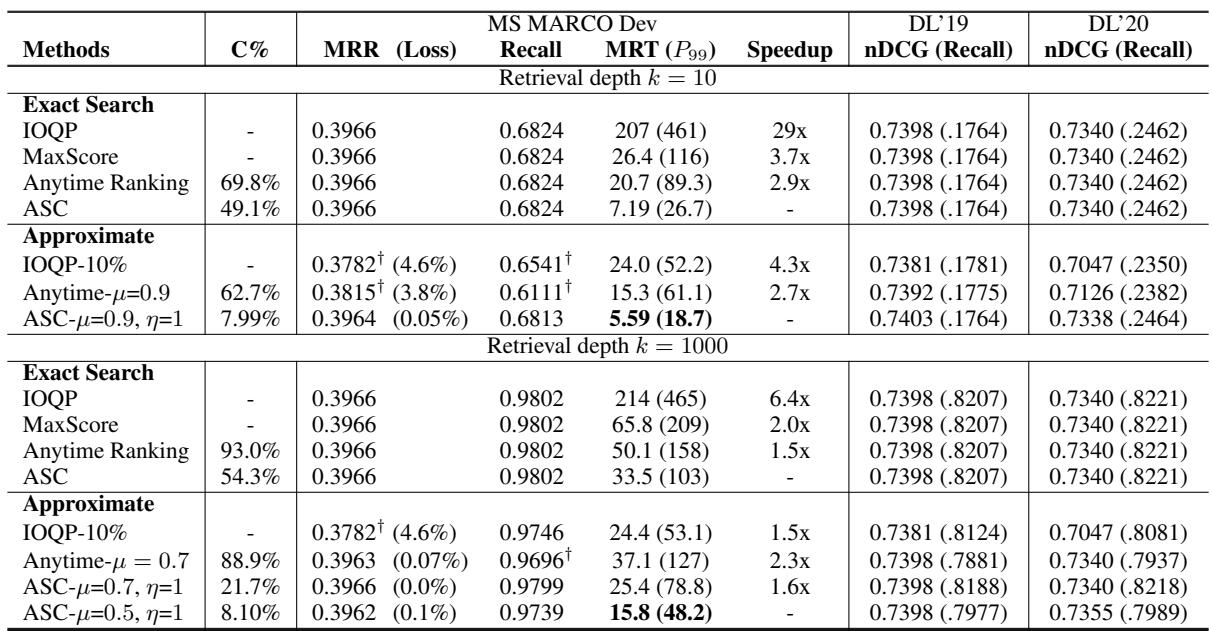
所报告的 MS MARCO passages 上基于 SPLADE 的检索方法比较显示,列出的前十名方法具有相同相关性结果。主要差异与效率相关,包括延迟和所报告簇比例。ASC 具有报告的最快平均延迟和 99 百分位延迟,同时使用低于 Anytime Ranking 的簇比例。ASC 保持与精确搜索和其他基线相同的报告相关性结果,同时降低延迟。在所比较的 SPLADE 方法中,ASC 达到最低报告平均延迟和 99 百分位延迟。
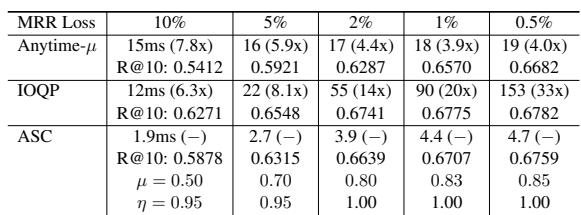
在固定 MRR@10 损失预算下,ASC 在比较方法中提供最低绝对查询延迟,同时在允许损失收紧时保持有竞争力的召回。IOQP 在更严格损失级别实现最强召回,但在更紧预算下其延迟急剧增长。Anytime-mu 表现出相对稳定的延迟,但在测试设置中仍明显慢于 ASC。ASC 在所有损失预算下保持个位数毫秒延迟范围。随着允许 MRR@10 损失减小,IOQP 延迟显著增加。Anytime-mu 需要比 ASC 更长的延迟,同时没有提供相当的召回提升。
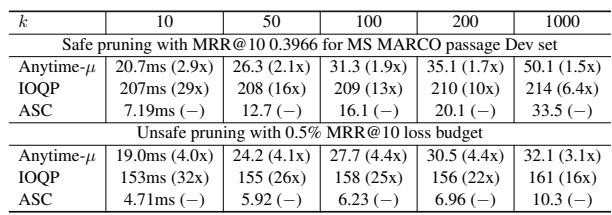
随着请求结果深度增加,检索延迟增加,但在测试深度下,ASC 在安全剪枝下仍是最快方法。IOQP 在较小深度显示更高延迟,且方法间的相对效率差异通常随深度增加而减小。允许较小相关性损失预算会降低不安全剪枝配置的延迟,体现速度与保证检索质量之间的权衡。ASC 在浅层和深层检索设置下具有最低安全剪枝延迟。ASC 与比较基线之间的相对效率差距在更大检索深度时变小。与安全设置相比,带较小损失预算的不安全剪枝可降低延迟。
在深度 10 且没有时间预算的稀疏检索中,对于 uniCOIL 和 LexMAE,精确、MaxScore、Anytime 和 ASC 都保持相同 MRR 和召回。ASC 具有最短平均检索时间,表明簇感知剪枝可在降低 CPU 检索时间的同时保持检索质量。加速对 LexMAE 特别有用,其基线检索成本高于 uniCOIL。ASC 在两种测试稀疏模型上均保持与其他深度 10 方法一致的有效性。ASC 在所比较无时间预算方法中提供最快检索。LexMAE 从较高基线检索时间开始,因此显示出更大的相对加速机会。
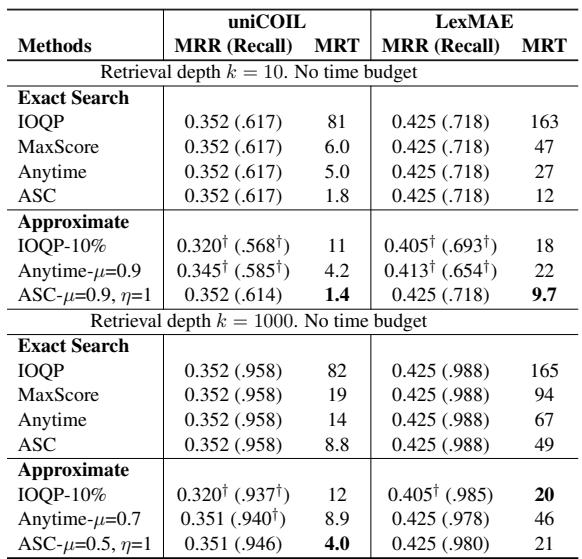
实验评估了 SPLADE 检索在 MS MARCO 上的在线簇感知剪枝,考察剪枝决策、固定相关性损失预算下的延迟、不同检索深度,以及使用 uniCOIL 和 LexMAE 的稀疏检索。结果表明,ASC 作出与 Anytime 基线不同的在线剪枝选择,并可在降低检索延迟的同时保持报告相关性。在各种设置中,ASC 仍是最快或接近最快的方法,尤其在安全剪枝和浅层深度下,而竞争方法要么产生更高延迟,要么在更紧损失预算下提供有限召回优势。